Text Embedding by Weakly-Supervised Contrastive Pre-training 리뷰
Background
Text embeddings는 임의의 길이를 가진 text를 낮은 dimension으로 dense하게 표현하는 역할을 한다. 기존의 text 표현 방법인 TF-IDF은 전체 단어의 빈도수에 기반하기 때문에 dimension이 높고 sparse해서 Cosine과 같은 계산을 하지 못할 뿐더러 lexical (어휘) mismatch 문제를 갖고 있다. Lexical mismatch란 두 text가 동일한 개념을 다른 단어로 표현할 경우, 사용한 언어가 달라 두 text를 다르다고 판단하는 문제이다. 하지만 text embedding은 말 그대로 text의 의미를 함축시킨 것이기 때문에 text embedding을 사용하면 다른 어휘를 사용하더라도 동일한 주제를 갖고 있다고 판단할 수 있게 된다. 이로 인해 효율적이며 정확한 retrieval이 가능해진다.
Pre-trained language models (BERT, GPT)도 범용적으로 사용 가능한 text representation을 만들 수 있지만 문제점이 많다.
- 우선 BERT의 구조를 보면 각 token에 대한 embedding만 출력하고 입력한 text를 대표하는 embedding은 존재하지 않는다.
- BERT의 [CLS} token은 모든 token과 self attention을 하였기 때문에 입력 text를 대표하는 representation이라고 볼 수 있지만 BERT pre-training 과정에서 [CLS] token은 Next Sentence Prediction task를 수행하도록 학습되기 때문에 문장의 순서에 대한 정보를 표현할 순 있어도 문장의 전체적인 의미를 잘 표현하지 못 한다.
- BERT의 token representation들은 Anisotropy 문제를 갖고 있다. 이전 연구에서 BERT의 representation들을 시각화한 결과, 모든 vector들이 좁은 영역에 밀집되어 있다는 것이 관찰되었다. 서로 다른 두 token 간의 cosine similarity를 계산하면 유사하다고 나와서 BERT의 representation들은 유의미하지 않다고 판단되었다.
더 좋은 text representation을 얻기 위해 다양한 방법들이 고안되었다.
예를 들어 Retrieval, STS(Semantic textual similarity) 등의 NLP task에서 성능이 좋은 text representation들을 얻기 위해 task-specific text embeddings을 학습하는 방법이 고안되었다. GTR의 경우 MS-Marco dataset (query, query의 답이 들어있는 document)으로 학습을 하여 query에 적합한 document을 retrieve하는데 최적화된 text representation을 얻었다. Sentence-T5의 경우에는 두 문장의 similarity score을 label로 사용하여 supervised learning을 하여 semantic textual similarity 판단에 최적화된 text representation을 얻었다.
더 주된 방법은 contrastive learning을 사용하는 것이다. 하나의 text에 대해서 연관된 positive example 하나와 negative example 여러 개를 하나의 training instance으로 pairing하여 unsupervised learning을 하는 것이다. 현재 이런 방법을 사용한 연구들은 이미 형성된 text pair dataset (Inverse Close Task, Random cropping 등)으로 text representation을 학습하였다. 이런 dataset들은 직접 label 할 필요가 없고 데이터 수가 많지만 quality가 낮아서 embedding 결과물의 성능이 떨어진다.
E5: EmbEddings from bidirEctional Encoder rEpresentations
본 논문은 bidirectional encoder로부터 범용적으로 사용할 수 있는 text embedding E5을 얻는 방법을 소개한다. 본 논문은 text의 single-vector representation가 필요한 모든 task에 적합한 text representation을 얻는 것을 목표로 한다. 이때, labeled data에 의존하지 않으며 이미 만들어진 low quality text pairs도 사용하지 않는다.
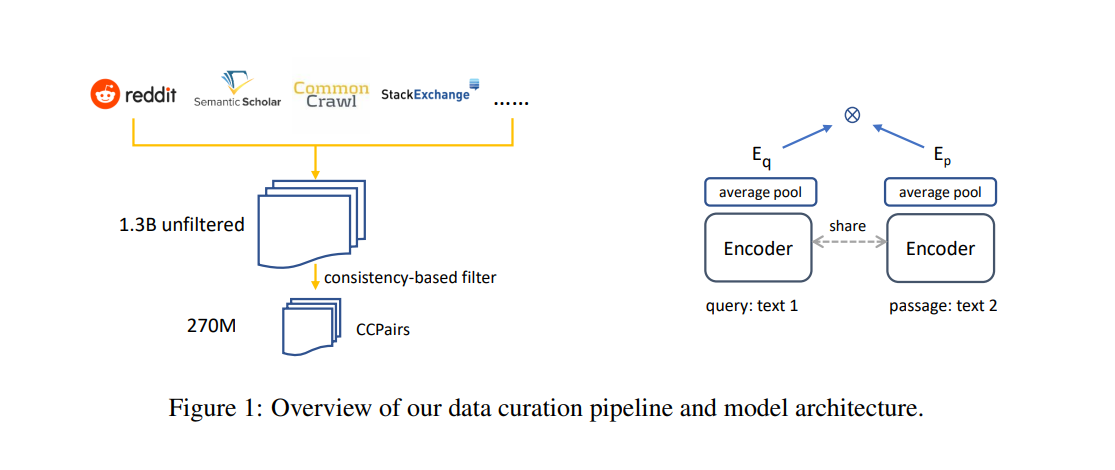
우선, Web-scale의 text pair dataset인 CCPairs를 직접 생성하였다. CCPairs 데이터는 CommunityQA, Common Crawl, Scientic papers 등의 semi-structured data sources으로 구성되어 있으며 consistency-based filter를 적용하여 데이터의 quality를 높였다.
학습 알고리즘으로는 간단한 contrastive learning을 적용하였고 negative examples를 구성하는 방법으로는 in-batch negative을 사용하였다.
CCPairs: A Large Collection of Text Pair Dataset
다양한 tasks에서 성능이 좋기 위해서는 학습 데이터의 quality와 다양성이 중요하다. 본 논문은 CCPairs dataset을 통해 인터넷에서 high quality의 text pairs를 얻어 학습된 text embedding이 다양한 task에 적용될 수 있도록 하였다.
Harvesting semi-structured data sources
Text embedding 학습을 위해서는 보통 크기가 작은 human annotated data (NLI, MS-MARCO) 을 사용하거나 text를 random하게 cropping하여 text pair를 구성하는 방법이 많이 사용된다. 전자는 dataset의 크기가 작아 제약이 존재하고 후자는 noise가 많다.
따라서, 크기가 크면서 noise가 적은 CCPairs(Colossal Clean text Pairs) dataset을 직접 구성하였다. CCPairs는 query가 q, passage가 p인 text pair data $(q,p)$로 구성된다. 이때 passage를 임의의 길이를 가진 단어 sequence으로 정의하였다. Passage는 문장, 문단, 긴 문서 등 다 가능하다. 이렇게 정의함으로써 CCPairs는 다른 dataset과 다르게 다양한 성격의 text pair들로 구성될 수 있다. 예를 들어 CCPairs는 Reddit의 (post, comment), Stackexchange의 (question, upvoted answer), 위키피디아의 (entity name + section title, passage), 논문들의 (title, abstract), 그리고 뉴스나 웹페이지를 크롤링한 Common Crawl의 (title, passage) text pair들로 구성된다.
이렇게 얻은 dataset의 크기는 1.3B이다.
Consistency-based filter
데이터의 quality를 향상하기 위해 consistency-based data filtering 방법을 적용한다.
이 방법은 Neural network의 기억 성향에서 유래되었다. 연구에 따르면 noisy한 dataset으로 Neural network을 학습할 때, 우선적으로 clean한 label들을 학습하고 나중으로 갈수록 noisy label들을 암기하는 경향이 존재한다고 한다.
우선 앞서 얻은 1.3B dataset으로 모델을 학습한 다음, dataset의 각 text pair에 대해 text pair 중 query에 대응되는 passage을 100만개의 무작위 passage들 안에서 넣어 전체 passage들을 ranking하도록 하였다.
Noisy한 1.3B dataset으로 학습을 먼저 시킨 이유는 모델이 우선적으로 clean한 label들을 학습하기 때문이다. 이를 통해 모델은 clean한 data들을 구분할 수 있을 것이라는 가정이 깔려있다.
Ranking 결과에서 top k 안에 실제로 대응되는 passage가 존재할 때만 그 text pair를 다시 학습 dataset에 포함시켰다. 이때 본 논문은 k=2를 사용하였다. 이 filtering 방법으로 총 270M의 dataset만 남았다.
Method
학습 방법은 CCPairs의 unlabeled data에 대해 contrastive pre-training을 하는 것이다. Pre-trained된 모델에서 labeled data에 fine-tuning을 적용하면 더 좋은 성능을 보인다.
E5의 전체적인 흐름은 다음과 같다.
Contrastive Pre-training with Unlabeled Data
Contrastive pre-training은 query와 연관없거나 잘못된 (negative) pair와 연관이 있는 (positive) pair를 구분하는 것을 목표로 한다.
Text pairs collection ${ (q_i, p_i) }^{n}{i=1}$이 존재할 때, i번째 example에 negative passages ${ p{\text{ij}}^{-}}^m_{\text{j=1}}$을 할당하였다. InfoNCE contrastive loss는 다음과 같다.
\[\min L_{\text{cont}} = - \frac {1} {n} \sum_i \log \frac {e^{s_{\theta}(q_i, p_i)}} {e^{s_{\theta}(q_i, p_i)} + \sum_j e^{s_{\theta}(q_i, p^{-}_{\text{ij}})}}\]이때, $s_{\theta}(q,p)$는 query q와 passage p의 연관성을 계산해주는 함수이다.
\[s_{\theta}(q,p) = \cos(E_q, E_p) / \gamma\]Embeddings $E_q, E_p$는 pretrained Transformer encoder의 output layer에 있는 단어들의 vector들에 대해 average pooling을 적용하여 얻었다.
Average pooling이란 문장을 구성하는 단어들의 vector들의 average 값을 구하여 전체 문장의 embedding vector를 구하는 방법이다.
BERT와 같은 Transformer encoder는 finetune되지 않았다면 [CLS]보다는 average pooling 방법이 더 좋은 representation을 만든다는 연구 결과를 전제로 한다.
Embedding을 만들 때, query와 passage을 구분할 수 있도록 하기 위해 text pair에 “query: “와 “passage: “ 라는 두 prefix를 추가하였다.
Contrastive learning에서 negative samples ${ p_{\text{ij}}^{-}}^m_{\text{j=1}}$을 선택할 때 어떤 방법을 사용할 것인지가 매우 중요하다. 본 논문은 in-batch negative 방법을 사용하였다.
In-batch negative란 학습 batch 내에서 다른 query의 positive passage들을 현재 query의 negative passage로 사용하여 효율적으로 contrastive learning dataset을 형성하는 방법이다.
Fine-tuning with Labeled Data
Pre-training을 한 뒤, human annotated high quality dataset으로 추가적으로 fine-tuning하면 모델에 인간의 지식을 주입할 수 있게 된다. 따라서 fine-tuning을 한 결과에 대해서도 탐구한다.
Human annotated dataset으로 NLI (Natural Language Inference), MS-MARCO passage ranking dataset, 그리고 NQ (Natural Questions) dataset의 조합을 사용한다.
- NLI: (전제, 가설)로 이루어져 있어 두 문장이 함의 (전제가 참이면 가설이 참)인지, 모순인지, 중립인지가 label로 주어져있다. (Binary label)
- MS-MARCO: (query, document)으로 이루어져있어 document 안에 query의 답이 들어있는지 label 되어있다. (Binary label)
- NQ: (query, wikipedia passage)으로 구성되어 wikipedia passage가 query의 답이 되는지 label 되어있다. (Binary label)
이 dataset들로 contrastive learning을 하기 위해 추가적인 hard negative들을 구했다.
경험적으로 Semantic Textual Similarity 성능은 NLI data으로, Retrieval task 성능은 MS-MARCO와 NQ data로 향상된다.
이때, 오직 hard label, 즉 binary label처럼 discrete한 label 값만 가진 dataset으로 fine-tuning (contrastive learning)을 하는 것이 아니라 Cross Encoder를 teacher model로 사용하여 distillation도 하였다.
Cross Encoder는 pair q와 p를 모두 하나의 Bi-encoder transformer 모델 input으로 넣어서 q와 p의 관계를 계산한다. 이 방법은 성능이 매우 좋지만 두 문서의 관계를 비교할 때마다 매번 embedding을 계산해야 하기 때문에 효율적이지 않다. 따라서 보통 문서들의 embedding을 따로 계산한 다음에 similarity function을 적용하여 두 문서의 관계를 계산한다.
학습되는 student 모델이 teacher model이 예측한 두 문장의 관계 (0~1의 continuous 값을 가짐)를 예측하도록 distillation 하였다. 이때, Teacher model과 Student model가 최대한 일치하도록 KL divergence 값을 최소화하도록 loss를 설계하였다.
다음은 fine-tuning에 사용되는 loss이다.
\[\min D_{\text{KL}} (p_{\text{ce}}, p_{\text{stu}}) + \alpha L_{\text{cont}}\]$p_{\text{ce}}$와 $p_{\text{stu}}$는 각각 teacher model과 student model의 확률 분포이다.
Experiments
Initial model: MiniLM, bert-base-uncased, bert-large-uncased-whole-wordmasking 모델로 pretraining을 하여 $\text{E5}{\text{small}}$, $\text{E5}{\text{base}}$, $\text{E5}_{\text{large}}$을 얻었다.
Evaluation Datasets
BEIR Benchmark
Retrieval에 집중된 benchmark으로 다양한 도메인의 문서들에서 retrieval이 잘 되는지를 평가한다. 사용되는 데이터셋은 총 15개이다. 평가 지표로는 nDCG@10 (상위 10개 document 안에 정답이 얼마나 포함되어 있는지, 그 정답이 상위권에 위치하는지를 평가)을 사용한다.
MTEB Benchmark
Text embedding의 범용성을 평가하는 benchmark이다. Classification (Class.), Clustering (Clust.), Pair Classification (PairClass.), Rerank, Retrieval (Retr.), STS, and Summarization (Summ.) task으로 전체적인 text embedding quality 평가를 한다. 각 task에서의 성능을 대표하는 지표는 accuracy, v-measure, average precision, MAP, nDCG@10, 그리고 Spearman coefficients이다.
MAP: 관련 있는 문서들을 얼마나 빠짐없이, 그리고 상위권에 잘 정렬했는가
Spearman coefficient: 두 data 사이의 순위가 얼마나 일치하는지를 측정
Results
Results on BEIR benchmark
Results with Unsupervised Methods
Unsupervised 방법의 모델들끼리 BEIR benchmark에서의 성능을 비교하였다.
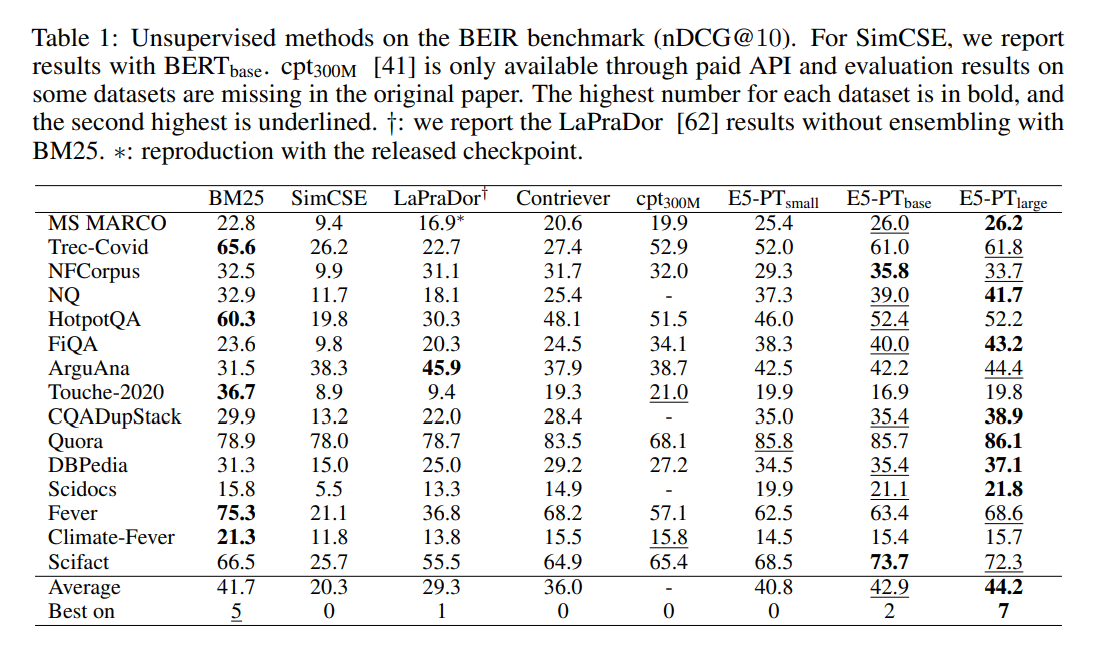
모든 dataset에서의 성능을 평균낸 결과, $\text{E5-PT}{\text{base}}$가 BM25를 1.2p만큼 우수하였다. 현재까지 나온 unsupervised model 중에 BM25를 BEIR에서 능가한 경우는 처음이다. $\text{E5-PT}{\text{large}}$으로 scale up 되었을 때는 더 큰 성능 향상이 관찰되었다.
Results with Supervised Fine-tuning
Supervised datasets에 대해 finetuning을 한 뒤, BEIR benchmark에서의 성능을 비교하였다.
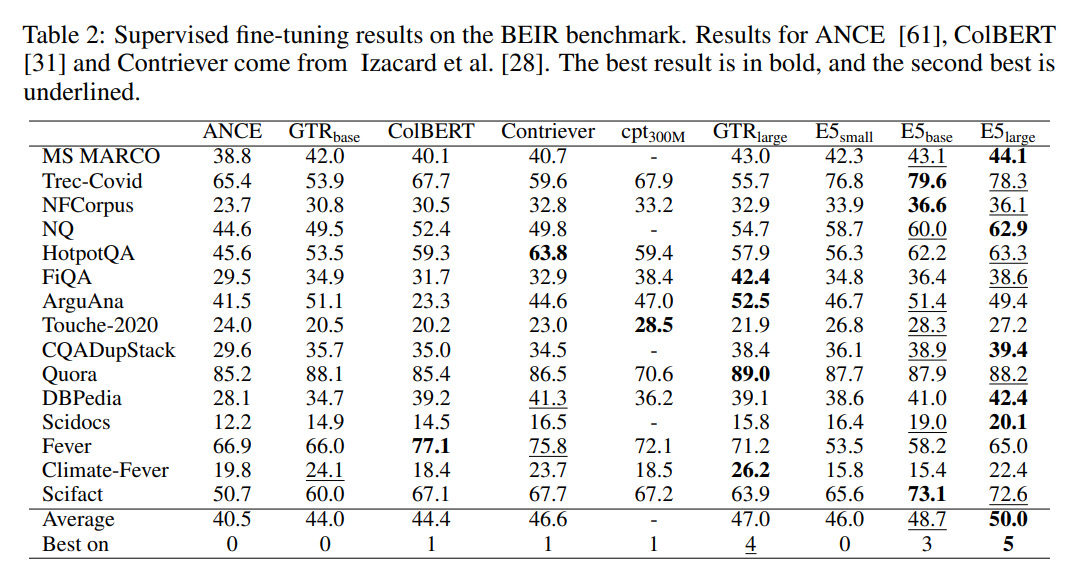
Fine-tuning datasets에는 MS-MARCO, NQ data가 포함되어 있기 때문에 성능은 매우 좋다. 하지만 다른 dataset들에서의 성능은 zero-shot transfer 결과임에도 불구하고 더 큰 크기의 $\text{GTR}_{\text{large}}$보다도 뛰어났다.
Results on MTEB benchmark
Supervised model과 unsupervised model 모두의 성능을 MTEB benchmark으로 측정하였다.
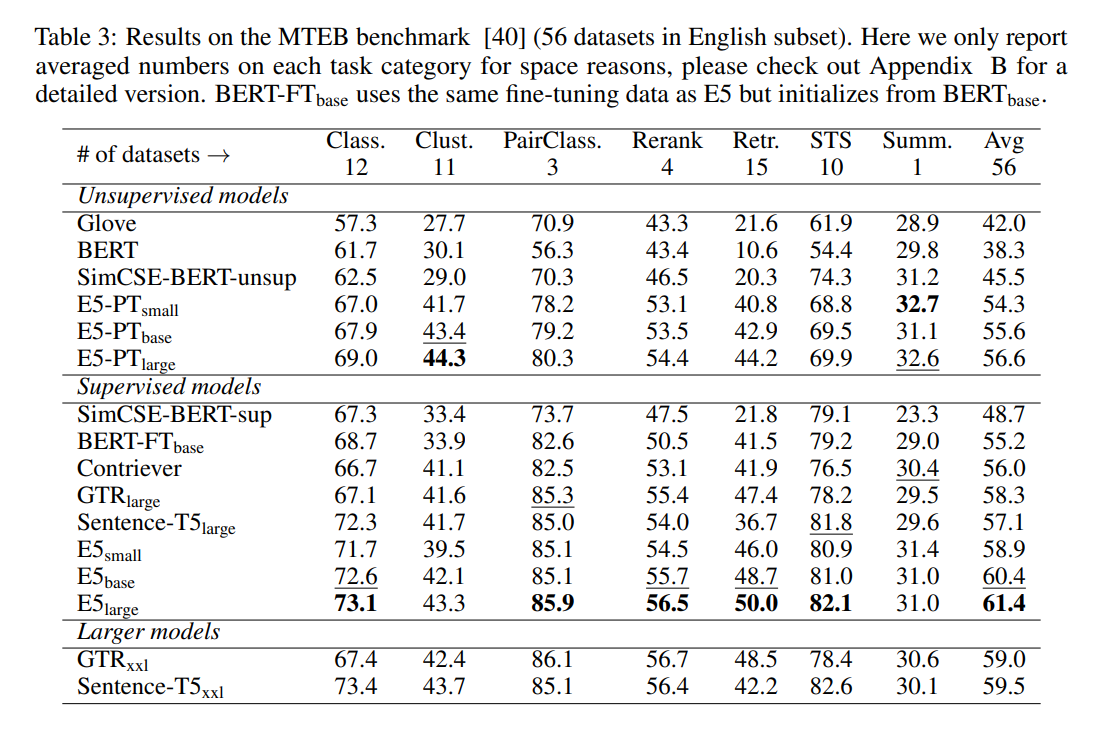
E5는 크기가 비슷한 모델들뿐만 아니라 10배 이상 더 큰 모델들 ($\text{GTR}{\text{large}}$, $\text{Sentence-T5}{\text{xxl}}$)보다 성능이 우수하다.
$\text{BERT-FT}{\text{base}}$와 $\text{E5}{\text{large}}$의 유일한 차이점은 $\text{BERT-FT}_{\text{base}}$은 fine-tuning만 한다는 것이다. 이 둘의 성능 차이는 CCPairs dataset으로 한 contrastive learning의 효과를 보여준다.
E5는 zero-shot text classification에서도 좋은 성능을 보인다.
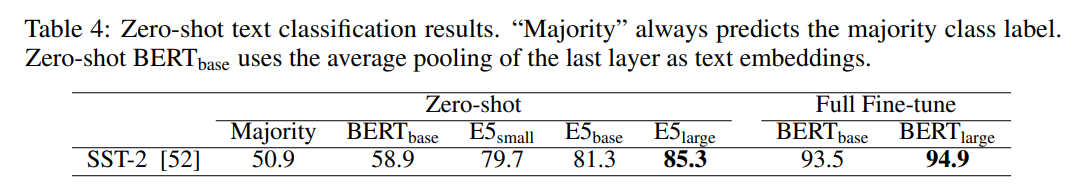
Zero-shot setting에서 majority voting 방법보다 성능이 더 좋다는 것을 관찰할 수 있다.
Analysis
Impacts of Batch Size
Contrastive learning의 negative examples을 구성하기 위해서 in-batch negatives를 사용하기 때문에 batch size가 중요하다. Batch size에 따라 학습 데이터가 늘어나기 때문이다. 따라서 batch size에 따른 성능을 관찰하였다.
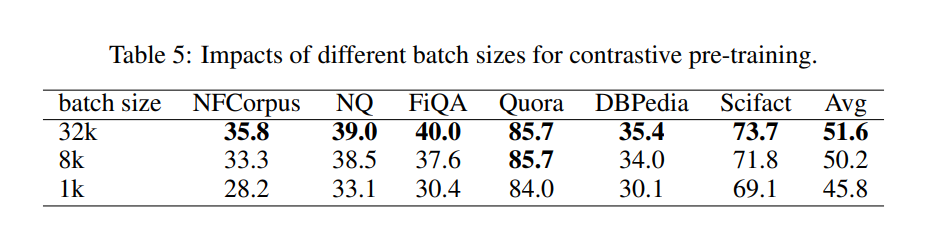
batch size를 1k에서 33k으로 키울수록 꾸준한 성능 향상이 관찰된다.
Fine-tuning Datasets
MS-MARCO+NQ와 다른 다양한 fine-tuning datasets을 사용했을 때의 성능도 관찰하였다.
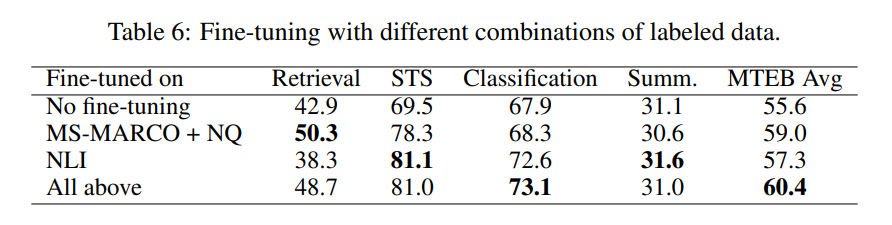
MS-MARCO+NQ에 대해서 fine-tune된 E5는 MS-MARCO+NQ의 특징으로 인해 다른 dataset을 사용한 것보다 Retrieval task에서 더 우수한 성능을 보인다. 반면, NLI data로 fine-tune된 E5는 STS에서 더 우수한 성능을 보인다. 이는 fine-tuned된 dataset의 특징과 관련된 task에 대해 E5가 특화되는 것을 보여준다. 또, 모든 dataset을 사용하여 fine-tune하였을 때 전체적인 MTEB 성능이 제일 높다는 것을 통해 dataset의 다양성의 중요성을 관찰할 수 있다.
Data Filtering
본 논문은 data의 quality에 집중을 많이 하였다. 따라서, 이런 data filtering이 유의미했는지를 실험을 통해 탐구하였다.
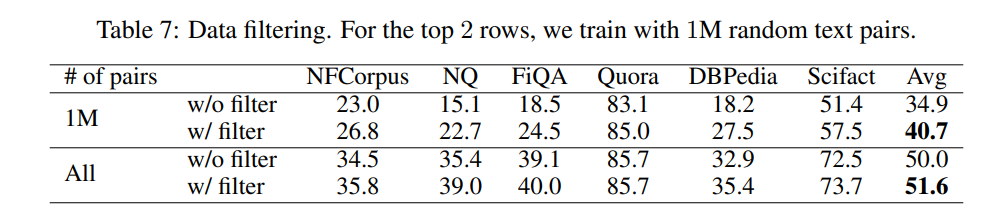
filtering을 적용한 1M pairs와 filtering을 적용하지 않은 1M pairs로 학습하였을 때, filtering을 적용한 것의 평균적인 성능이 6p나 더 높았다. 또, filtering을 적용하지 않았지만 4배가 더 많은 All w/o filter pairs로 학습했음에도 불구하고 filtering을 적용한 All w/ filter pair로 학습했을 때보다 1.6p 더 뒤쳐진다. 이 결과는 아무리 deep learning model이 noise를 어느정도 거를 수 있다고 해도 data quality가 성능과 학습 효율에 큰 영향을 준다는 것을 알 수 있었다.
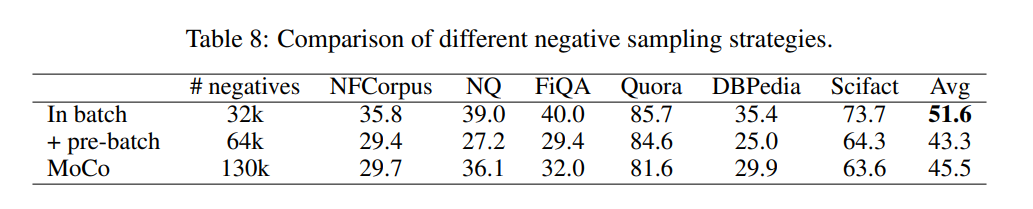
Negative Sampling In-batch negative을 제외한 다른 negative sampling 방법을 사용하는 것도 탐구하였다. 이전 batch의 examples를 negative로 사용하는 방법 (pre-batch)과 MoCo 방법과 비교하였을 때, 우선 세 방법 모두 GPU의 사용량을 크게 늘리지 않고도 negatives의 개수를 많이 키울 수 있다. 하지만, 이 두 방법들은 이전 버전의 model parameters를 가진 model이 생성한 negatives를 사용하기 때문에 성능 저하를 불러일으킨다.
BM25 vs Dense Retrieval
Dense retrieval이 더 좋은 성능을 보이긴 하였지만 BM25를 완전히 대체할 정도는 아니다. BM25는 여전히 더 간단하면서 효율적이기 때문이다.