LoRA Low Rank Adaptation of Large Language Models 리뷰
Background
NLP task를 수행하기 위해서는 하나의 large scale pretrained Language model을 downstream task 에 특화되도록 finetuning 해야 한다. Parameter가 $\Phi$ 인 pretrained Autoregressive Language model $p_{\Phi}(y \mid x)$를 downstream task 에 대해 fine-tuning 시켜야 한다고 하자. 각 downstream task 의 training dataset & context-target pair $Z = {(x_i, y_i)} \text{where i=1..N}$으로 구성될 것이다. 예를 들어 뉴스 요약 도메인에 fine-tuning 시킨다고 하면 $x_i$가 news article 이고 $y_i$는 대응되는 summary 일 것이다. 이때 full fine-tuning을 한다면 model 은 우선 pretrained weights $\Phi_{0}$로 초기화될 것이고 objective equation $\max_{\Phi} \sum_{(x,y) \in Z} \sum_{t=1}^{\mid y \mid} \log(P_{\Phi}(y_t \mid x, y_{<t}))$ 을 최대화하는 방향으로 학습이 될 것이다. 이 objective function이 최대가 되도록 하는 parameter 변화를 $\Delta \Phi$ 라고 할 때. $\Phi_{\text{new}} = \Phi + \Delta \Phi$으로 weights 가 update 될 것이다.
이런 full fine-tuning 의 단점은 매 학습 iteration 마다 $\Phi$ 크기의 weights 의 변화 $\Delta \Phi$ 를 계산하고 저장해야 하고, fine-tuning 한 downstream task 의 개수만큼 $\Phi$ 크기의 weights 값들을 저장해야 해서 computation과 memory cost 가 크다.
LoRA: Low Rank Adaptation of Large Language Models
따라서 본 논문은 더 parameter efficient 하게 fine-tuning을 하는 방법인 LoRA을 소개 한다. Fine-tuning 을 해서 생기는 task-specific parameter 변화 $\Delta \Phi$ 를 더 작은 크기의 parameters $\mid \Theta \mid « \mid \Phi \mid$로 표현하여 더 효율적으로 adaptation을 가능하게 한다. 즉 $\Delta \Phi$를 구하는 과정은 objective function을 $\Theta$ 에 대해서 optimize 하는 것이 된다
\[\max_{\Theta} \sum_{(x,y) \in Z} \sum_{t=1}^{ \mid y \mid} \log (p_{\Phi_0 + \Delta \Phi(\Theta)}(y_t \mid x, y_{\text{<t}}))\]LoRA 는 full fine-tuning 에서 생기는 $\Phi$ 크기의 parameter 의 변화 $\Delta \Phi$를 계산하지 않고 low rank representation 을 통해 task specific parameter increment $\Delta \Phi$를 더 작은 크기의 parameter 인 $\Theta$으로 표현하여 더 효율적으로 계산한다.
\[\Delta \Phi = \Delta \Phi(\Theta)\]LoRA 는 parameter $\Phi$의 update 을 $\Theta « \Phi$로 표현할 수 있게 함으로써 학습해야 하는 parameter 의 크기를 줄였다.
LoRA의 이론은 이전 연구에서 관찰된 neural network models 의 low intrinsic dimension을 바탕으로 한다.
Intrinsic dimension이란 임의의 task 에 대해 일정 수준 이상의 성능을 보여주는 parameter 의 최소 개수를 의미한다.
Neural network 모델의 low intrinsic dimension을 보여준 실험은 모델 parameter space $D$를 더 작은 크기 $d«D$의 parameter space로 mapping 하고 학습한 뒤, 성능을 관찰하여 기존 모델의 성능의 90%을 달성할 수 있는지 확인한 실험이다.
Neural network는 보통 matrix multiplication을 수행하는 많은 layers으로 구성되어있다. 이 neural layers의 weight matrices는 dense하기 때문에 full rank을 지니고 있다. (학습한 수많은 정보가 압축되어있다) 하지만 low intrinsic dimension 실험에 의하면 임의의 task를 수행할 때, 일부 parameter로도 비슷한 성능을 보일 수 있다고 밝혀졌다.
본 논문은 특정 task를 수행하는데 전체 parameter 의 극히 일부분만 필요하다면 fine-tuning이라는 것은 사실 모든 parameter 의 전체적인 방향을 update 하는 것이 아니라 task에 필요한 일부 방향으로만 update 시키는 과정이 아닐까? 라는 의문을 바탕으로 model adaptation (fine-tuning)에서의 parameter change는 low intrinsic rank을 parameter change일 것이라는 가설을 세운다. 즉, 전체 parameter 의 일부분만 학습해도 full fine-tuning 하는 것과 똑같다는 가설을 세운 것이다.
Rank란 matrix 에서 서로 독립적인 벡터의 최소 개수로 matrix가 가진 실질적인 정보량으로 이해할 수 있다. 따라서 low intrinsic rank을 가진 change라는 것은 중요한 일부 방향으로만 변한다는 것이다.
LoRA Method
Pretrained weight matrix $W \in R^{d \times k}$가 있을 때, LoRA는 weight을 low rank decomposition을 통해 $W + \Delta W = W+ BA$으로 표현한다. 이때, $B \in R^{d \times r}$, $A \in R^{r \times k}$, rank $r « min(d.k)$, W는 freeze 된다.
$\text{rank} (B \times A) \le min(\text{rank }(B), \text{rank } (A))$
A의 $\text{max rank = min(r.k) = r}$
B의 $\text{max rank= min(d,r) = r}$
따라서. $B A$는 low instrinsic rank r 을 가진 $d \times k$ matrix 이다.
Low instrinsic rank weight change을 더한 $W = W + BA$ 이므로 새로운 forward pass는 다음과 같다.
\[h=W_0 x+ \Delta W = W_0x+ BAx\]LoRA의 reparameterization은 다음과 같다.
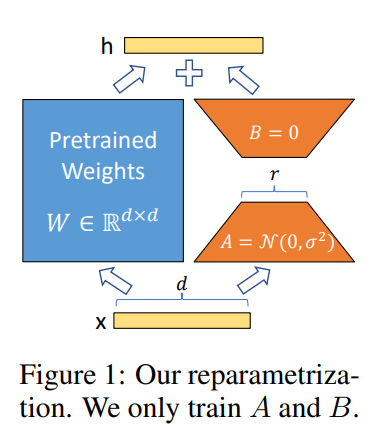
A는 gaussian initialization 으로 초기화하고 B는 0으로 initialization하여 $\Delta W= BA$를 처음에 0이 되도록 한다. $\Delta Wx$ 는 $\frac {\alpha} {r}$으로 scaling 되고 $\alpha$ 는 첫 $r$으로 고정한다. Adam optimizer을 통 해서 A와 B를 학습할 때, $\alpha$ 는 BA의 크기를 바꾸기 때문에 learning rate와 비슷한 역할을 한다. 이때, 이 바뀌더라도 $\alpha$는 고정시켜서 hyperparameter re-tune 하지 않아도 되도록 하였다.
Generalization of Full Fine-tuning
일반적인 fine tuning 은 full rank을 가진 weight gradient update을 하지만 LoRA는 더 적은 rank r을 가진 weight gradient update을 하기 때문에 LoRA를 모든 weight matrix 와 bias 학습에 적용한다면, r이 커질수록 full fine-tuning에 가까워진다. 따라서, LoRA는 어떻게 보면 full fine-tuning 을 포함하는 더 큰 개념으로 볼 수 있다.
No additional inference latency
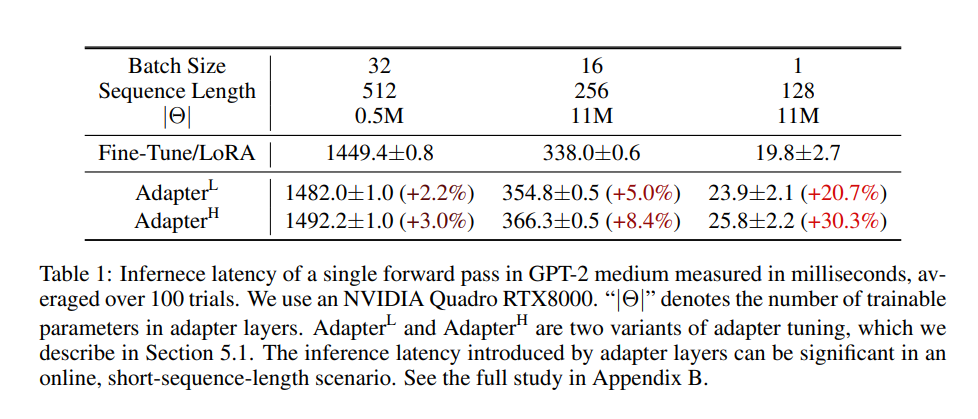
LoRA 로 fine-tuning 한 모델을 실제로 배포하기 위해서는 오직 BA 만 저장했다가 pretrained weight W에 더하기만 하면 되기에 inference 속도가 증가하지 않는다. 또, 다른 downstream task으로 바꾸고 싶을 때는 기존에 더해진 BA를 빼고 그 task 에 trained된 새로운 B’A’를 더하면 되기에 적은 memory overhead으로 task를 빠르게 전환할 수 있다. 즉, LoRA 는 그저 기존 pretrained weight 에 학습된 weight difference 을 더하는 방법이기 때문에 기존의 PEFT (Parameter Efficient Fine Tuning) 방법론과 다르게 inference latency가 크지 않다.
Applying LoRA to Transformer
LoRA 는 neural network의 아무 weight matrices 에 적용되어 학습될 parameter 수를 줄일 수 있지만, 본 논문은 Transformer의 attention weights ($W_q. W_k. W_v$ 등)에 LoRA를 적용했을 때 생기는 효과에 대해서만 탐구한다.
LoRA 로 얻는 최대 이점은 memory 효율이다. Adam으로 Transformer를 학습했을 때 LoRA를 사용하면 frozen 된 pretrained weight의 gradient 까지 계산할 필요가 없어져 VRAM 사용량이 $\frac {2} {3}$만큼 줄어들었다.
또, 다양한 downstream task으로 전환해야 할 때 pretrained weights $W$ 에 다른 downstream task 에 특화된 BA를 갈아끼우기만 하면 되므로 memory 사용량 효율이 향상된다.
Empirical Experiments
LoRA 과 다른 PEFT 방법들과 비교하기 위해서 각 방법들을 적용한 tuning 된 모델들의 성능을 비교하였다. 사용한 Pretrained 모델은 RoBERTa. BERTa, GPT-2 이다.
Baseline 으로 사용된 방법들은 다음과 같다.
- full fine-tuning
- 마지막 2개의 layer 만 finetuning 하는 $\text{SFT}^{Top2}$
- BitFit: Bias vectors finetuning
- Prefix Tuning: Input에 trainable word embedding을 가진 special token들을 넣어서 downstream task으로 distribution을 shift 해주는 역할을 함
- Adatper Tuning: Downstream task에 최적화된 adapter layer를 self attention module 앞뒤에 추가하는 방법이다. 어디에 추가하는지에 따라 명칭이 달라진다.
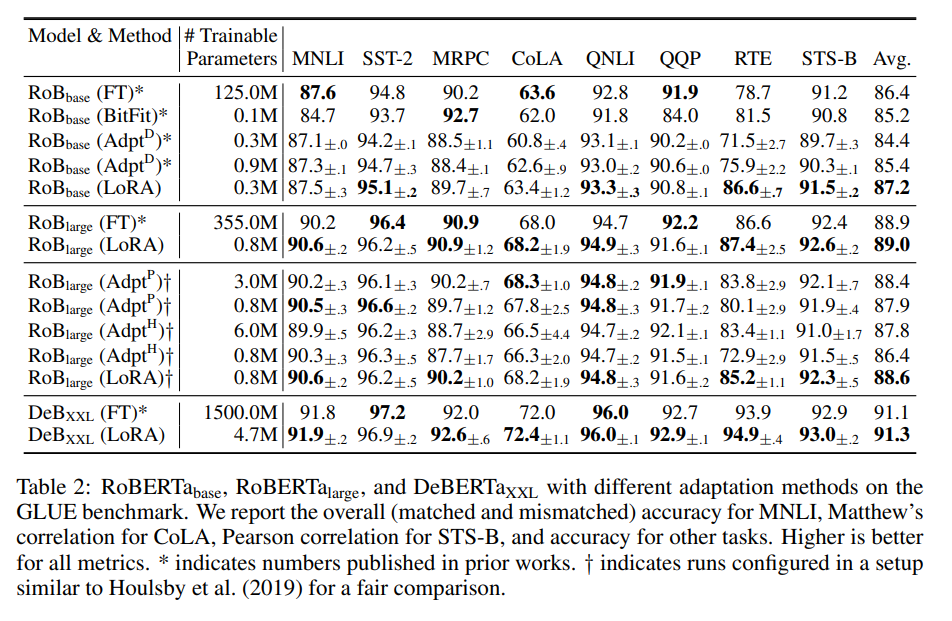
Pretrained model 중 ROBERTa 와 DeBERTa 에 적용했을 때의 성능을 비교하였다.
-
$\text{RoBERTa}_{\text{base}}$ 에 LoRA 를 적용하면 Full fine-tuning으로 학습하는 parameter 수가 LoRA보다 417배 큼에도 불구하고 비슷한 MLI 성능을 보인다.
-
$\text{DeBERTa}_\text{XXL}$ 에 LoRA 를 적용하면 full fine-tuning으로 학습하는 parameter가 LoRA보다 319배 큼에도 불구하고 거의 모든 benchmark 에서 더 높은 성능을 보인다.
$\rightarrow$ 이 결과로 LoRA의 parameter efficiency를 엿볼 수 있다.
또, pretrained language model 의 크기가 커질수록 LoRA 의 성능 향상이 커지는 것을 관찰할 수 있는데 이는 LoRA 가 큰 모델에 적용할수록 효과가 커진다는 것을 알 수 있다.
GPT-2 에 LoRA 를 적용했을 때도 비슷한 양상을 보인다.
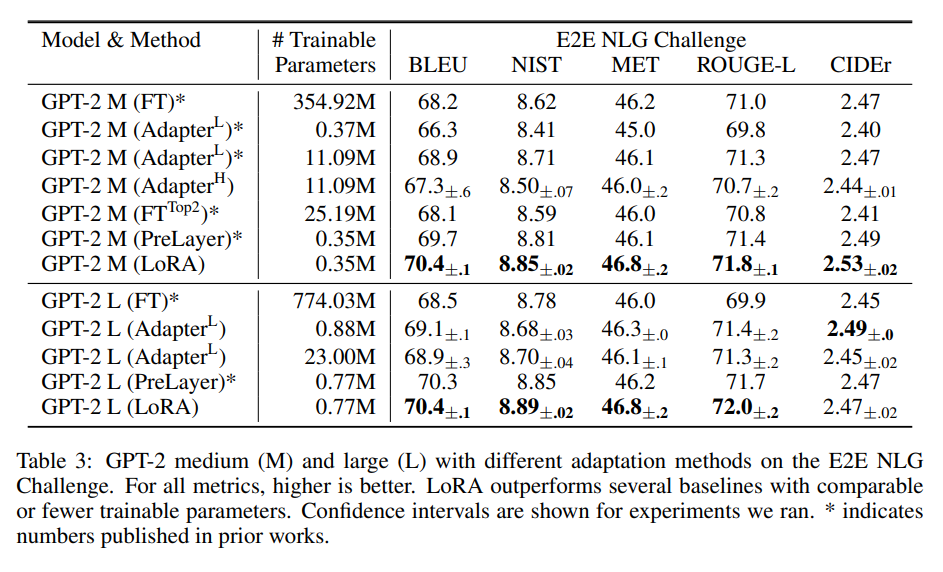
GPT-2 에서 LoRA 을 적용했을 때, 다른 PEFT 방법들보다 학습되는 parameter 수가 가장 적음에도 불구하고 성능이 가장 좋다.
Pretrained language model 중 당시에 가장 컸던 GPT-3에도 LoRA를 적용하여 LoRA의 효과를 입증하였다.
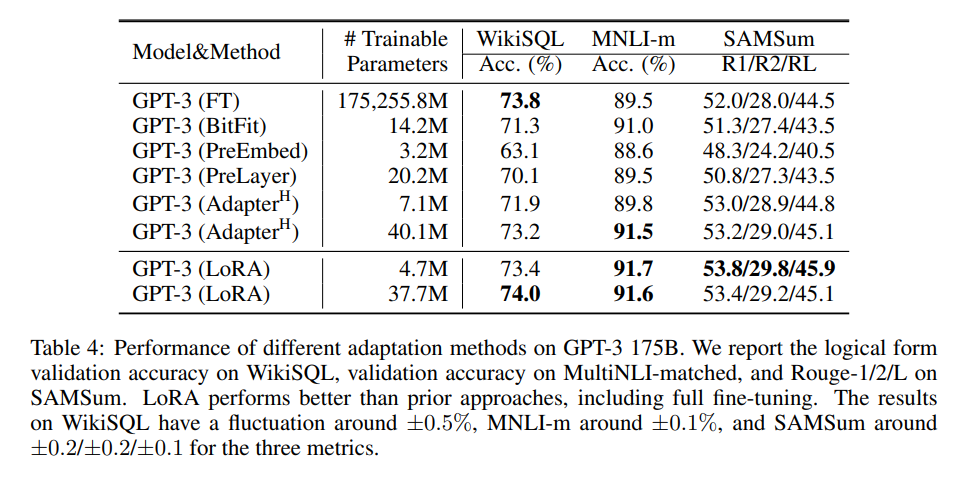
LoRA를 적용했을 때, 4.7M개의 parameter만 학습하는데도 174,255.8M개의 parameter를 finetuning한 모델보다 성능이 대등하거나 우수하게 나왔다.
$\rightarrow$ 37075배 많은 parameter를 finetuning함에도 불구하고 LoRA의 성능 우수성에 대해 설명하기 위해 finetuning에서 학습되는 parameter 수와 성능 간의 관계를 탐구하였다.
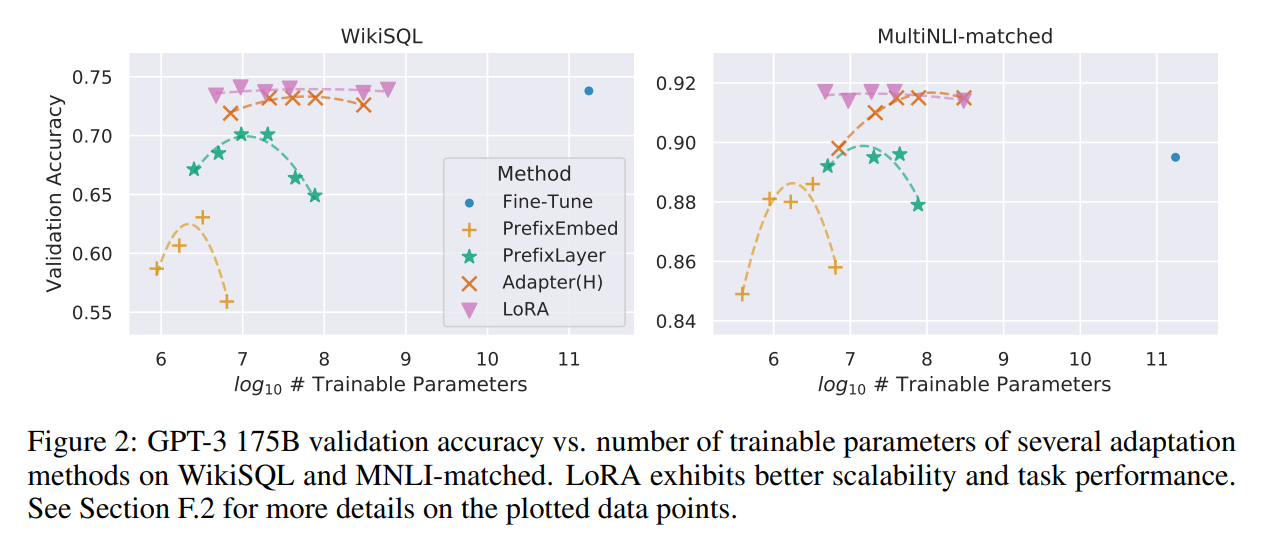
다른 finetuning method (PEFT 포함)들은 학습 parameter를 늘린다고 monotonic하게 성능이 향상되지 않았고 오히려 중간에 꺾이는 현상을 보인다. 반대로 LoRA는 학습 parameter를 늘려도 이런 현상을 보이지 않는다.
이를 통해 LoRA의 hyperparameter를 조절하는 과정은 다른 PEFT 방법에서 hyperparameter 조절 과정보다 더 쉽게, 대충(?)해도 되는 장점을 갖고있다는 생각이 들었다.
Understanding Low Rank Updates
LoRA 를 적용한다고 할 때 어떤 weight matrices에 적용할지, optimal rank r은 얼만큼인지가 중요하다. 본 논문은 실험을 통해 LoRA의 효과에 대해서 증명한다.
Which Weight matrices in Transformer should we apply LoRA to?
본 논문은 정해진 parameter budget 내에서 Transformer의 어떤 weight matrices에 LoRA 를 적용해야 downstream task에서 최대 성능을 보일 것인가에 대해 탐구하였다.
Transformer 의 attention weight matrices $W_q. W_k. W_v. W_o$ 에 LoRA 를 적용하고 WikiSQL 과 MultiNLI benchmark으로 각각 평가하였다. LoRA를 적용하는 parameter 의 개수를 동일하게 하기 위해 하나의 weight matrix 에 적용했을 때는 r=8, 두 weight matrices 에 적용했을 때는 r=4, 네 개의 weight matrices에 적용했을 때는 r=2를 사용하였다.
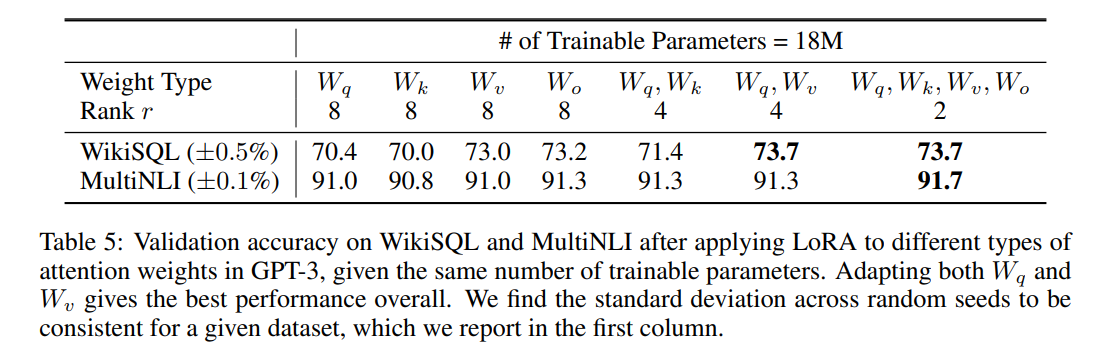
실험 결과. 한 종류의 weight matrix에만 LoRA 를 적용하는 것보다 다양한 종류의 weight matrices에 LoRA 를 적용하는 것이 성능이 좋게 관찰되었다. 이는 LoRA를 많은 weight matrix 에 적용해야 한다는 것을 보여주는 동시에 매우 낮은 intrinsic rank을 가진 parameter update (r=2, r=4)으로도 학습 정보를 많이 capture 할 수 있다는 것을 보여준다.
What is the Optimal Rank r for LoRA?
이어서 rank 값에 따른 LoRA 성능 변화를 관찰하여 LoRA 에 최적인 rank 값에 대해 탐구 하였다. 각 weight type ${ W_q }, { W_q, W_v }, {W_q, W_k, W_v, W_o }$에서 rank 값을 달리 하면서 WikiSQL 과 MultiNLI benchmark 성능을 비교하였다.
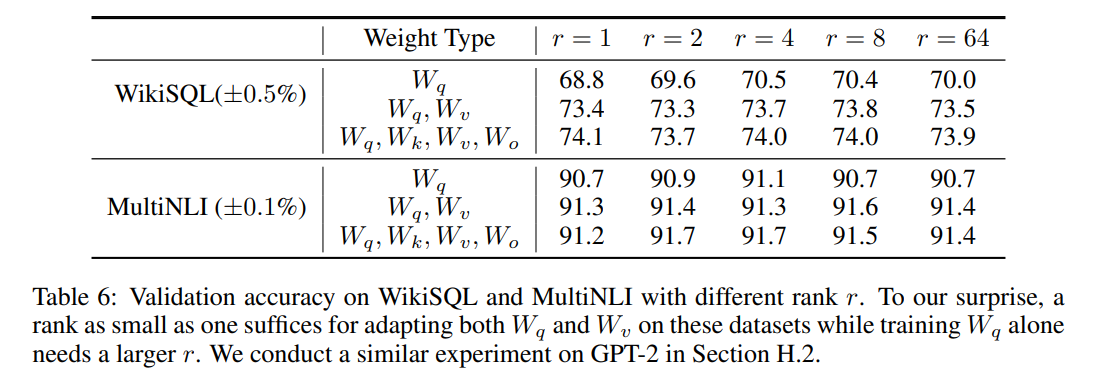
실험 결과에 의하면 각 weight type 에서 r=1~r=64 간의 결과 차이가 매우 미미하다는 것을 통해 LoRA 를 사용하면 매우 작은 rank으로도 (학습 parameter 수를 많이 줄여도) 충분히 성능을 좋게 할 수 있음을 보여준다 즉, model adaptation 에서 parameter change는 사실 low rank라는 것을 보여준다.
Subspace similarity between different r
r의 값이 작아도 된다는 것을 더 자세하게 증명하기 위해 low r과 high r로 학습을 하였을 때, 학습된 subspace가 얼마나 겹치는지를 계산하였다. 즉 low r을 사용한 LoRA 의 주된 학습 방향으로 span된 subspace와 high r을 사용한 LoRA의 주된 학습 방향으로 span 된 subspace 가 많이 겹친다면 굳이 high r을 사용하지 않아도 LoRA는 학습 내용과 방향을 충분히 capture 할 수 있다는 것을 의미하기 때문이다. 또, neural network 의 full fine-tuning은 사실 매우 일부 parameter만 update 하는 것, 논문의 가설이 맞다는 것을 의미하게 되는 것이다.
동일한 pre-trained model 을 r=8과 r=64 으로 학습한 adaptation matrices $A_{\text{r=8}}$ 과 $A_{\text{r=64}}$ 에 대해서 singular value decomposition을 하여 right-singular unitary matrices $U_{\text{r=8}}$과 $U_{\text{r=64}}$을 얻었다.
Right singular unitary matrix란 Singular Value Decomposition $M = U \Sigma V^T$에서 M의 input space / domain을 담당하는 basis이다. 즉, 행렬 M이 가장 민감하게 반응하는 입력 방향에 대한 정보를 가지고 있다고 볼 수 있다.
$U_{\text{r=8}}$의 top i singular vector 로 span된 subspace와 $U_{\text{r=64}}$의 top j singular vector 로 span 된 subspace 가 얼만큼 겹치는지를 Grassmann distance 기반으로 한 normalized subspace similarity 로 계산하였다.
\[\phi(A_{r=8}, A_{r=64}, i, j) = \frac{\mid \mid U_i^{A_{r=8} \top} U_j^{A_{r=64}} \mid \mid ^2_F} {\min(i, j)} \in [0, 1]\]Grassmann Distance: 두 공간 (subspace) 간의 similarity를 계산하도록 해주는 거리 계산 방법이다. 점과 점 간의 거리 계산 방법과 다르게 두 subspace의 방향이 얼마나 겹치는지를 통해 두 subspace가 얼마나 닮았는지를 계산한다.
이 값의 범위는 0에서 1로, 1에 가까울수록 겹친다는 것을 의미한다.
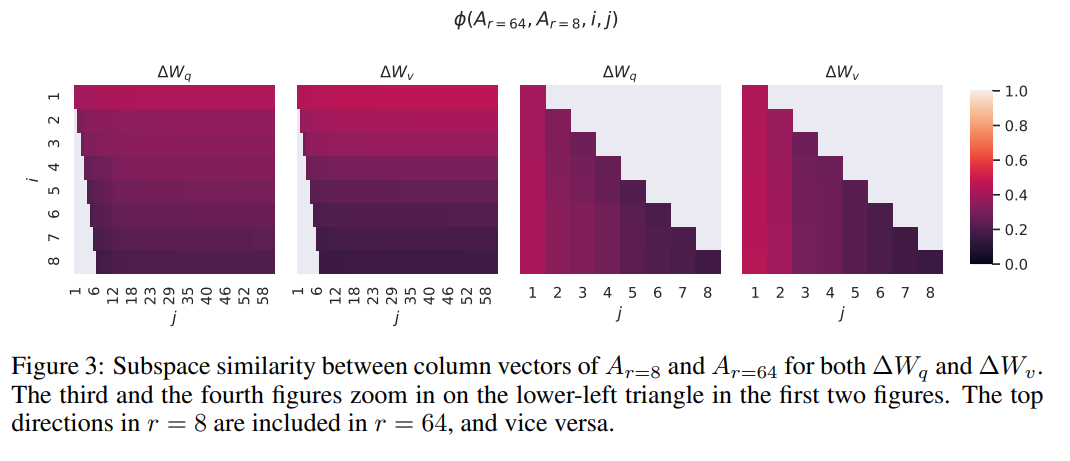
실험 결과의 3번째 figure 에 따르면 $A_{\text{r=8}}$의 top singular vectors 의 subspace 와 $A_{\text{r=64}}$의 top singular vectors의 subspace가 매우 유사하다. 이 결과는 서로 다른 r을 사용한 LoRA 가 생각한 가장 핵심적인 update 방향은 일치한다는 것을 의미한다. 따라서, r 의 값이 작아도 LoRA는 adaptation 방향을 잘 알아내기 때문에 r의 값이 작아도 된다. 이 결과는 table 6 에서 r=1 일 때도 준수한 결과가 나오는 이유를 뒷받침한다.
또 두 subspace 에서 top singular vector 방향들만 겹치고 나머지는 random noise 처럼 similarity 값이 매우 낮다는 것을 통해 adaptation matrix 는 매우 낮은 rank을 가질 수 있음을 보여준다. 즉, 매우 중요한 top singular vector 방향들을 제외한 나머지는 downstream task에 필요한 중요한 학습 방향에 대한 정보를 가지고 있지 않다는 것이다.
Subspace similarity between different random seeds
LoRA 를 적용할 때 r의 값이 작아도 된다는 사실은 r값을 포함하여 동일한 데이터, 동일한 setting에서 initialization random seed만 다르게 하여 fine-tuning 하였을 때 두 모델의 update matrix $\Delta W_q, \Delta W_v$의 subspace도 각각 비교하였다.
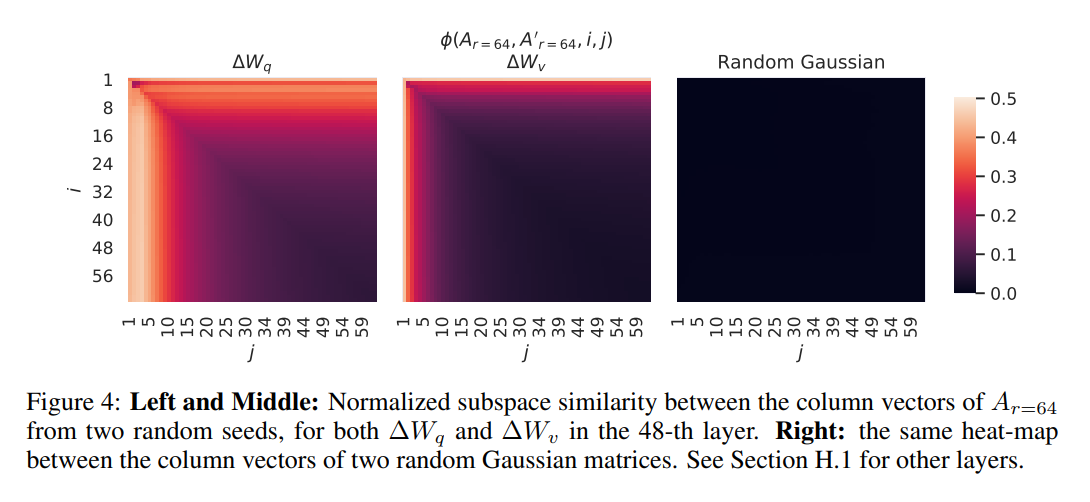
Figure 4의 왼쪽과 중간 그림을 통해 random seed을 다르게 해도 top singular vectors (학습하고자 하는 방향)의 유사도가 높다는 점에서 LoRA의 주된 학습 방향은 일관된다는 것을 알 수 있다. 또, $\Delta W_q$에서 singular vectors 방향이 더 많이 겹친다는 것을 통해 $\Delta W_q$가 더 높은 intrinsic rank를 가지고 있다고 볼 수 있다. 이 사실은 table 6에도 암시된다. $W_q$에만 LoRA를 적용했을 때, 다른 weigh matrix을 섞을 때와 달리 좋은 성능을 내기 위해서 높은 r을 필요로 한다는 것이 관찰된다.
Figure 4의 오른쪽 그림은 random Gaussian initialize된 두 matrices의 top singular vectors의 유사도를 비교한 결과이다. Random인 두 matrices의 subspace similarity를 계산했을 때는 similiarity가 0으로 나온다는 것을 통해 Figure 4 왼쪽과 중간에서 나온 패턴이 우연이 아니라는 것을 보여준다.
How does the Adaptation Matrix $\Delta$W Compare to W?
LoRA는 pretrained weights와 update되는 weights를 구별하여 finetuning 하기 때문에 update weights 와 pretrained weights 간의 관계에 대한 정보를 제공한다.
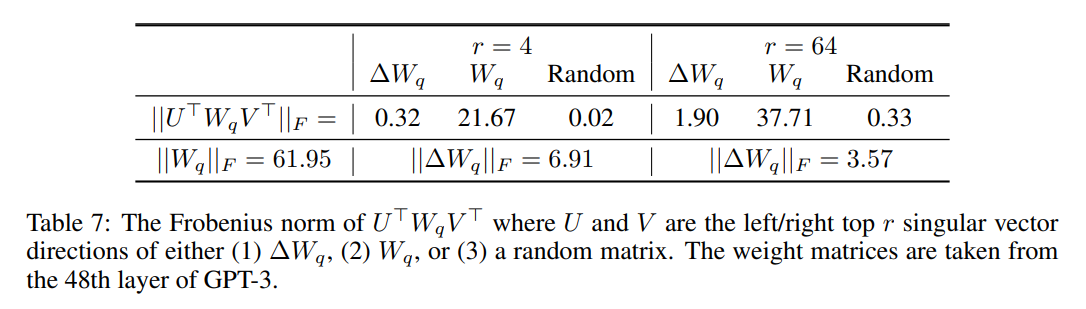
본 논문에서 $W$을 다른 matrix의 dimensional subspace으로 project한 결과와 $W$의 Frobenius norm을 비교하였다. Projection은 비교 대상 matrix의 left / right singular vector matrix U,V을 통해 $U^T W V^T$을 계산하여 얻었다.
Frobenius Norm: 행렬이 얼마나 큰 에너지를 가지고 있는가의 지표이다.
\(\mid \mid A\mid \mid _F = \sqrt{\sum_{i=1}^m \sum_{j=1}^n (\mid a_{ij} \mid ^2)}\)
weight matrix $W$의 Frobenius norm이 크다는 것은, 그 모델이 입력을 받았을 때 output을 변화시키는 에너지가 강하다는 것을 의미힌다.
-
첫 row, 첫 column의 data로부터 $\Delta W$가 random matrix보다 W와 훨씬 높은 연관성을 갖고 있다는 것을 관찰할 수 있다. 이 정보는 $\Delta W$가 W에 존재하는 특징을 증폭하는 경향이 있음을 의미한다.
-
$\mid \mid U^T W_q V^T \mid \mid_F$ (pretrained weight의 특징)은 학습한 parameter matrix $\Delta W$의 특징의 방향으로 0.32만큼만 강조되었다는 것을 통해 학습을 통해 알아낸 중요한 학습 direction과 기존 pretrained weight matrix W가 중요하다고 생각하는 direction 간에는 큰 공통점이 없다는 것을 알 수 있다. 하지만, 학습된 parameter $\Delta W$의 Frobenius norm이 매우 크다는 것을 통해 기존 pretrained weight matrix W의 특징 중 downstream task에 필요한 특징이 증폭되었음을 알 수 있다. (0.32 $\rightarrow$ 6.91)
-
그리고 이 증폭 정도는 매우 크다는 것을 알 수 있다. 21.5 $\sim$ $\frac {6.91} {0.32}$
이 결과를 통해 low rank adaptation matrix는 pretrained model에서 강조되지 않은 특성 중 finetune된 downstream task에 중요한 특성을 증폭시키는 역할을 한다는 것을 알 수 있다.