Active Retrieval Augmented Generation 리뷰
Background
Retrieval Augmented Generation (RAG)
User input이 x이고 document corpus $D = { d_i }^{\mid D \mid}_{i=1}$이 있을 때, retrieval augmented LM의 역할은 task에 적합한 document를 바탕으로 답안 $y = \left [ s_1,s_2,…, s_m\right ] = \left [ w_1, w_2,… w_n\right ]$을 생성하는 것이다.
Retrieval Augmented LM은 보통 별도의 Retriever(ret)를 통해 query q와 관련된 문서들 $D_q = ret(q)$을 얻는다.
지금까지의 RAG는 single retrieval, 즉 Input $\rightarrow$ Retrieve $\rightarrow$ Augment $\rightarrow$ Generate의 구조로 되어있다. 하지만 긴 generation을 할 때는 그 과정 안에서 새로운 정보가 필요한데 single retrieval은 처음 한번만 retrieve 하기 때문에 정보가 부족하여 hallucinate할 가능성이 높아지는 한계가 존재한다.
기존 해결법
어떤 새로운 정보를 언제 가져올 지 정하여 여러 번 retrieval을 하도록 하였다. 이를 multi time retrieval이라고 한다.
Previous window
L개의 token들을 생성할 때마다 retrieval을 하여 query를 현재 context 기반으로 계속 update하는 방법이다.
\[q_t = y_{t-1}, y_t = \left[ w_{(t-1)L+1} \sim w_{(t-1)L+L}\right]\]Previous Sentence
이전에 생성한 문장을 query로 사용
\[q_t = y_{t-1}, y_t = s_t\]Question Decomposition
Question을 sub-question들로 분해하여 각 sub-questions을 토대로 추가 정보를 갖고 오는 것
기존 해결법의 문제점
LLM이 다음에 생성하고자 하는 것은 이전에 생성한 것과 꼭 이어질 것이라는 보장이 없다. 또, fixed length context를 query로 사용하면 context를 이해하는데 어렵게 할 수 있다. 또, Question decomposition 방법은 특정 task에 최적화된 prompt engineering이 필요하기 때문에 general하게 사용하기 어렵다.
이를 해결하기 위해 Active Retrieval Augmented Generation을 제안한다.
FLARE: Forward Looking Active REtrieval Augmented Generation
본 논문은 효과적인 RAG는 필요할 때 생성해야 되는 내용과 관련된 document만 retrieve하여 generate하는 방법이라고 주장한다. 따라서, generation 과정에서 retrieve을 해야 하는 시점과 무엇을 retrieve할 것인지 LM이 직접 알 수 있게 하는 방법론인 Active Retrieval Generation을 제안한다. 이때, 무엇을 retrieve 할 것인지는 과거의 context가 아니라 미래의 context와 연관성이 높아야 한다고 주장한다 . 이를 통해 context fragmentation 문제를 해결할 수 있을 것이라고 주장한다.
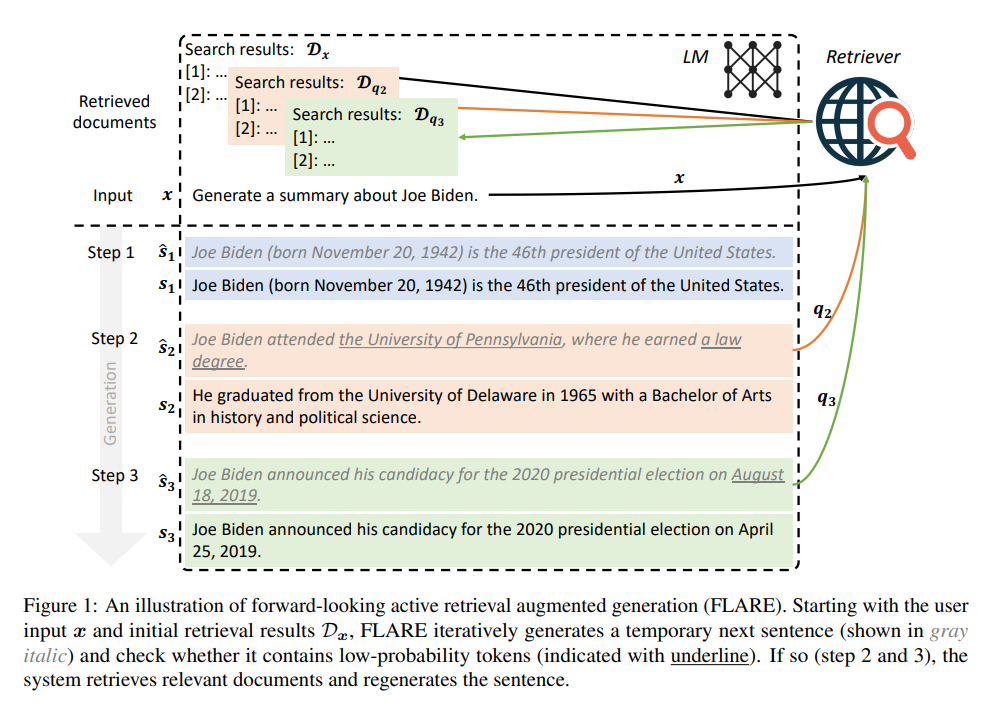
이 방법론은 두 가지로 나뉜다.
- $\text{FLARE}_{\text{instruct}}$: 생성하면서 필요한 내용을 가져올 수 있는 retrieval query를 만들어 retrieve하는 방법
- $\text{FLARE}_{\text{direct}}$: LLM이 평소대로 generate한 내용을 insight of future topic으로 간주하고 retrieval query로 사용하는 것.
$\text{FLARE}_{\text{instruct}}$: FLARE with Retrieval Instructions
Retrieval을 해야겠다고 생각하도록 instruction을 주는 방법이다. 추가적인 정보가 필요할 때 “[ Search (필요한 내용) ]“을 query로 생성하도록 few shot prompting을 하는 것이다. [ Search (필요한 내용) ]은 Toolformer 연구에 의하면 정보를 검색해야 된다는 필요성을 LM에게 직접적으로 알려주는 역할을 한다고 한다.
사용하는 instruction의 형식은 다음과 같다.
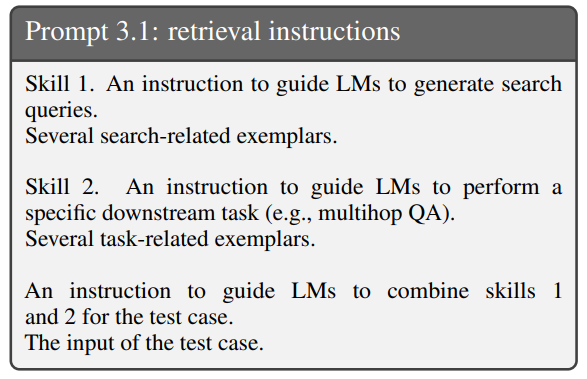
- Skill 1: LM이 search query [Search (query) ]을 생성하도록 guide하는 instruction
- Skill 2: LM이 downstream task을 수행하도록 guide하는 instruction
- Skill 1 + Skill 2를 모두 사용하여 input에 대한 출력을 시키는 instruction
$\text{FLARE}_{\text{instruct}}$의 흐름은 다음과 같다.
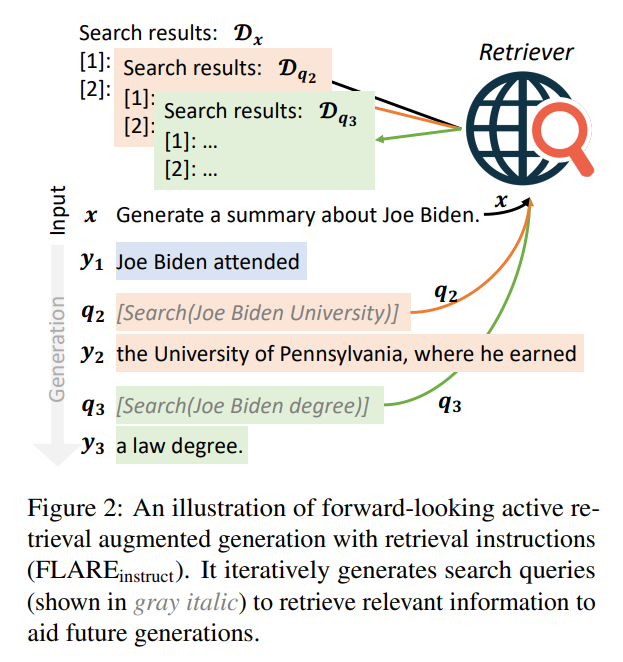
LM이 [Search (query) ]을 generate하면 generation을 멈추고 query term과 연관된 documents들을 retrieve한다. 이때, 이 document들은 user input 앞에 추가되어 generation이 끝나거나 다음 [Search (query) ]문을 생성할 때까지 future generation을 도와준다.
하지만 LLM은 black box model이기에 항상 올바른 search query을 만들도록 finetuning 할 수 없다. 즉, search query의 신뢰성이 떨어질 수 있다. 이 문제를 해결하기 위해 $\text{FLARE}_{\text{direct}}$을 고안한 것이다.
$\text{FLARE}_{\text{direct}}$: Direct FLARE
$\text{FLARE}_{\text{direct}}$는 다음에 생성할 sentence을 토대로 언제 / 무엇을 retrieve 할 것인지 알아내어 직접 retrieve하는 방법이다.
Temporary next sentence $\hat s_t = \text{LM}(\left [ x, y_{<t} \right ])$을 생성하여 $\hat s_t$을 기반으로 retrieval을 활성화할지 결정한다. $\hat s_t$에 대한 자신이 없을 때만 필요한 내용을 retrieve하기 위해 LM이 $\hat s_t$으로부터 search query을 만들어 retrieve하고 actual next sentence $s_t$을 생성한다.
불확실성 계산
불확실성 계산은 token 생성 probability (softmax prob)으로 측정한다. 이전 연구에 따르면 token 생성 probability가 낮을수록 이에 대한 지식이 부족하다는 뜻이며 자신감이 없다는 것과 동일하다고 한다. 따라서, 설정이 가능한 기준치 $\theta$에 대해 $\hat s_t$의 token 생성 확률 중에 $\theta$보다 작은 것이 있다면, unconfident하다고 판단하도록 하여 retrieval을 진행하였다.
\[y_t = \begin{cases} \hat{s}_t & \text{if all tokens of } \hat{s}_t \text{ have probs } \ge \theta \\ s_t = \text{LM}(\left [D_{q_t}, x, y_{<t} \right ]) & \text{otherwise} \end{cases}\]이때, sentence를 기준으로 iteration을 하는 이유는 sentence가 적당한 길이의 semantiv unit이라고 가정하였기 때문이다.
Search Query 생성 방법
Search query를 만드는 방법 중 가장 naiive한 방법은 $\hat s_t$을 그대로 query $q_t$로 사용하는 것이다. 생성한 문장으로 query를 만드는 이유는 질문과 document 간의 semantic gap은 존재하기 때문에 estimated 답변과 document 간의 similarity 계산을 하도록 하기 위해서다.
하지만 만약 $\hat s_t$에 잘못된 내용이 들어있다면 적합하지 않은 정보를 retrieve할 가능성이 존재한다. 이를 극복하기 위해 두 방법을 제시한다.
Masked Sentences as implicit queries
$\hat s_t$ 중 low confidence을 가진 token들만 masking한 결과를 query로 사용하는 방법이다. 이때 low confident의 기준은 $\beta$로 한다.
예를 들면, Joe Biden attended the University of Pennsylvania where he earned a law degree. 에서 the University of Pennsylvania와 a law degree가 low confidence을 보인다면
Joe Biden attended the University of Pennsylvania where he earned a law degree $\rightarrow$ Joe Biden attended, where he earned. 으로 바꿔 query로 사용한다.
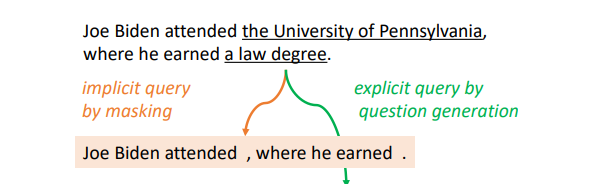
Generated questions as explicit queries
Low confident span이 답이 되는 question을 생성하여 query로 사용하는 방법이다. 이때, question을 생성할 때 다음 prompt을 사용한다.
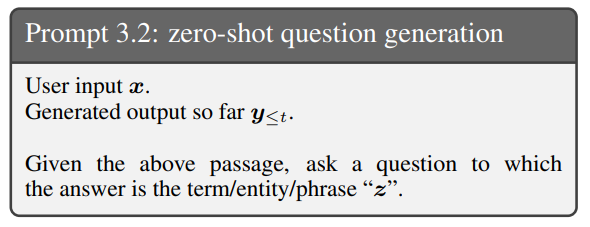
Masked sentence을 query로 사용하는 방법을 설명할 때 사용한 예시를 그대로 사용한다면 이 과정은 다음과 같다.
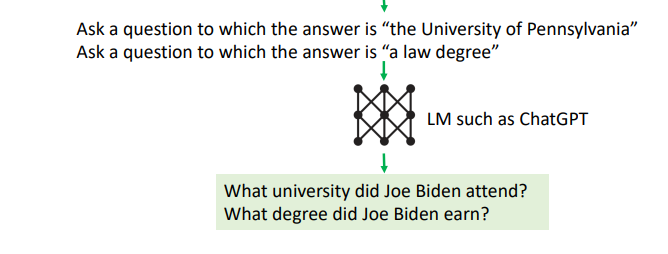
정리하자면 $\text{FLARE}_{\text{direct}}$의 search query는 다음과 같다.
\[q_t = \begin{cases} \emptyset & \text{if all tokens of } \hat{s}_t \text{ have probs } \ge \theta \\ \text{mask}(\hat{s}_t) \text{ or } \text{qgen}(\hat{s}_t) & \text{otherwise} \end{cases}\]Results
FLARE와 다른 baseline들을 다음 evaluation dataset으로 평가한다.
- 2WikiMultihopQA (Multi-hop Reasoning)
답하기 위해서 여러 wikipedia 문서들이 필요한 질문들이 들어있는 dataset이다. 이 dataset에서 높은 점수를 얻기 위해서는 여러 단계의 추론을 해야 한다.
- StrategyQA (Implicit Strategy)
예 / 아니오로 답하는 문제이지만 어떤 정보가 필요한지 prompt에 제시되지 않는다. 이 dataset은 문제를 분석해서 답하기 위해 필요한 표면적으로 드러나지 않은 정보들을 얻어서 답할 수 있는지를 평가한다.
ex) 불교 신자를 스테이크를 즐겨 먹을까? $\rightarrow$ 불교가 무엇인지, 스테이크와 불교의 연관성은 무엇인지를 알아내야 해결할 수 있다.
- ASQA (Ambiguous Question Answering)
긴 서술형 답안이 필요한 모호한 질문들로 구성된 dataset이다. 이 dataset은 긴 generation을 하면서 factual consistency를 잃지 않는지 평가한다.
- ASQA-hint
ASQA에 어떤 부분에 집중해야 되는지를 알려주는 hint를 포함한 dataset이다. 이 dataset은 LM이 hint을 이해하고 잘 따르면서 이와 관련된 정보를 가져올 수 있는지 평가한다.
- WikiAsp (Aspect-based Summarization)
특정 주제의 정해진 속성에 대한 요약이 들어있는 dataset이다. 이 dataset은 문제 상황에 필요한 정확한 정보를 가져오는지와 factual consistency를 유지하는 지를 평가한다.
다음은 FLARE와 다른 baseline들의 evaulation dataset에 대한 성능 결과이다.
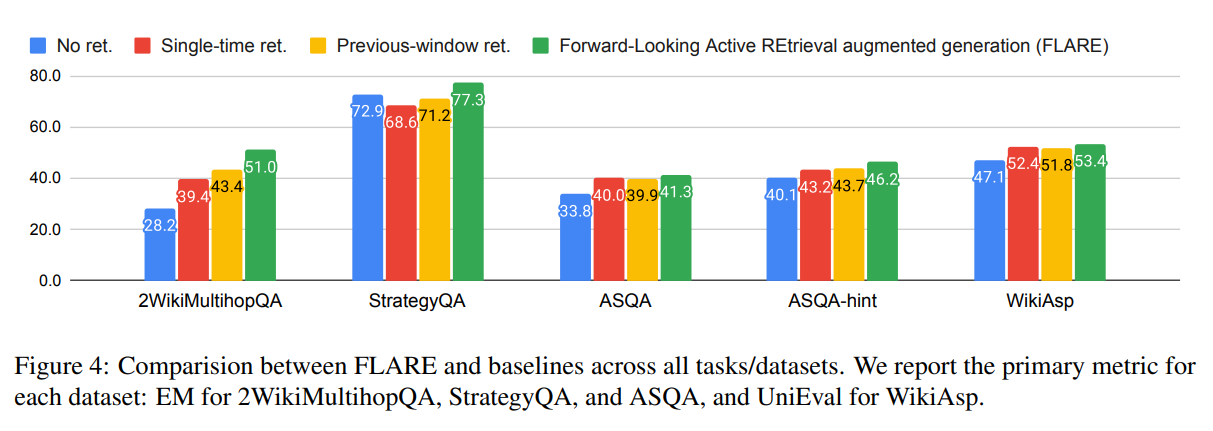
FLARE는 모든 evaluation dataset에서 우수한 성능을 보인다. 특히 2WikiMultihopQA에서 높은 performance gap을 보여준다. 이 결과는 다단계 추론 과정에서 다음에 생성할 내용을 바탕으로 retrieve하는 FLARE 특성 덕분인 것으로 해석된다.
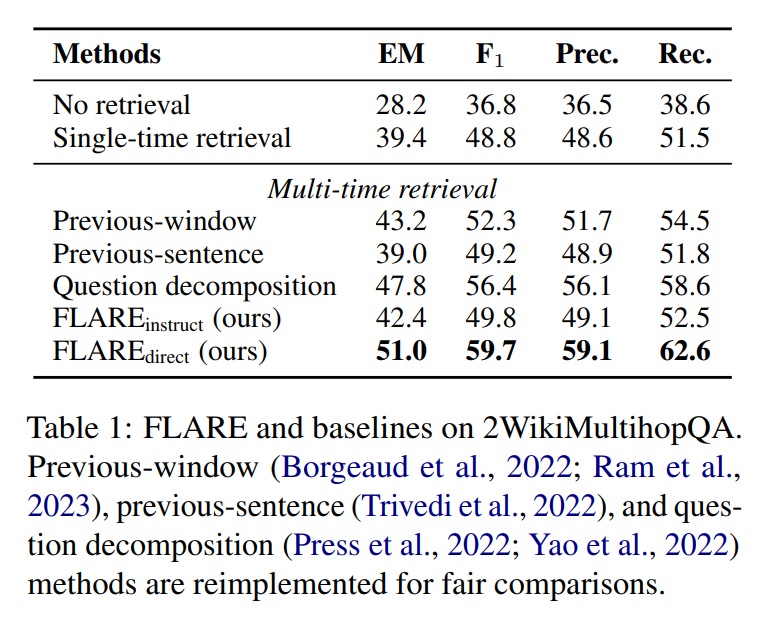
다음은 2WikiMultihopQA에서 모든 baseline과 FLARE 방법론들의 performance에 대한 dataset이다.
-
모든 multi time retrieval 방법이 no retrieval이나 single time retrieval 방법들보다 우수하다는 것을 통해 multi time retrieval의 우수성을 엿볼 수 있다.
-
Previous window가 previous sentence보다 우수하다는 것을 볼 수 있는데 이는 previous window는 한 문장에서 first half을 바탕으로 retrieve하기 때문에 previous sentence보다 더 미래에 있는 정보를 바탕으로 retrieve할 수 있다. 이런 차이점은 future generation의 의도를 바탕으로 retrieval을 해야 한다는 본 논문의 주장과 align된다.
-
Baseline 중에서 Question decomposition 방법이 제일 성능이 좋다는 것을 관찰할 수 있다. 이는 human labeled decomposition을 통해 LM의 생각 방향을 가이드 해주기 때문에 당연한 결과이다. 하지만 $\text{FLARE}_{\text{direct}}$이 question decomposition보다 월등히 성능이 좋다는 것을 통해 RAG는 human labeled 예시는 필요로 하지 않고 오직 미래의 generation을 얼만큼 더 반영하여 retrieval 할 수 있는지가 중요하다는 본 논문의 주장과 알맞다.
다른 evaluation dataset에서도 일관된 결과를 보인다.
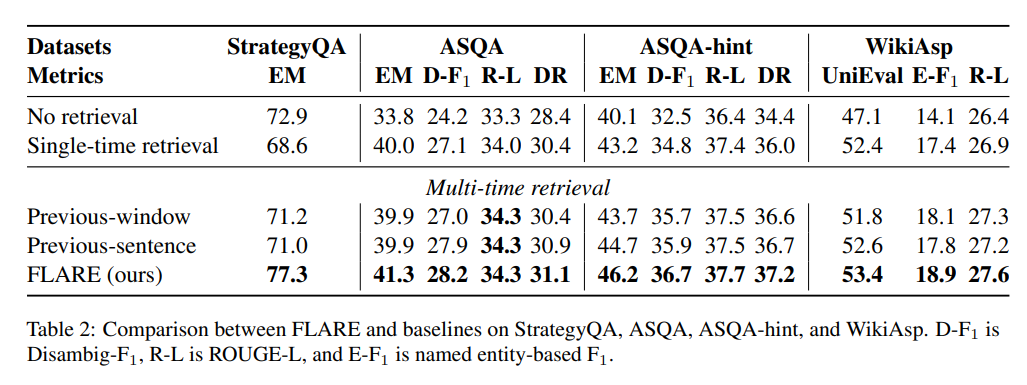
FLARE가 다른 baseline들보다 더 사실에 기반하고 일관된 답변을 한다는 것을 볼 수 있다.
Ablation Study
Importance of forward looking retrieval
본 논문의 주장: 미래 generation (의도)를 바탕으로 retrieval을 하여 generation을 진행할 수 있어야 우수한 RAG이다. 를 뒷받침하기 위해 $\text{FLARE}_{\text{direct}}$ 방법론에서 모든 조건을 동일하게 하고 search query을 어떻게 구성하는지 (Previous sentence / Future sentence)만 다르게 하여 실험을 하였다.
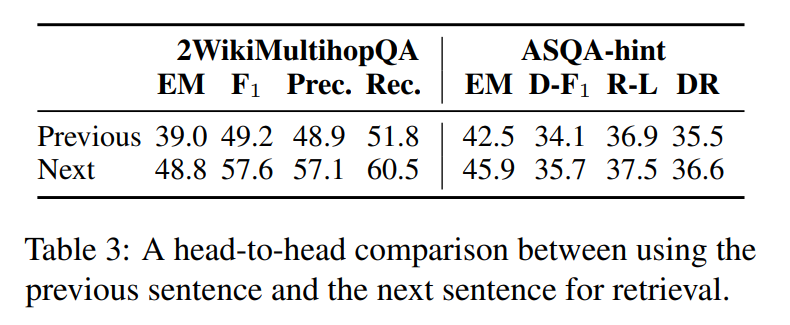
실험 결과 다음 문장을 토대로 retrieval하는 방법이 훨씬 우수하다는 것이 관찰되었다.
더 나아가서 Previous window를 구성할 token 수를 늘려가면서 RAG의 성능이 어떻게 나오는지 관찰하여 previous window을 통해 retrieval하는 방법이 얼마나 안 좋은지, 그리고 미래 generation 의도를 파악하는 것이 얼마나 중요한지 보여준다.
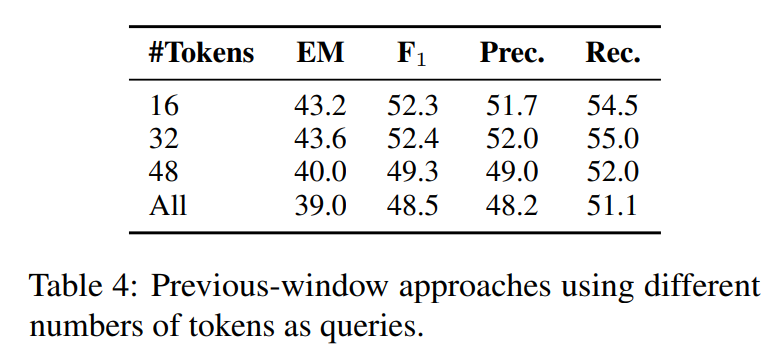
Previous context token 수를 늘릴수록 성능이 감소하는 것을 관찰할 수 있다. 이런 결과가 나오는 이유는 previous context 양을 늘릴수록 미래 generation의 의도를 더 파악할 수 없게 되기 때문이라고 주장한다.
Importance of active retrieval
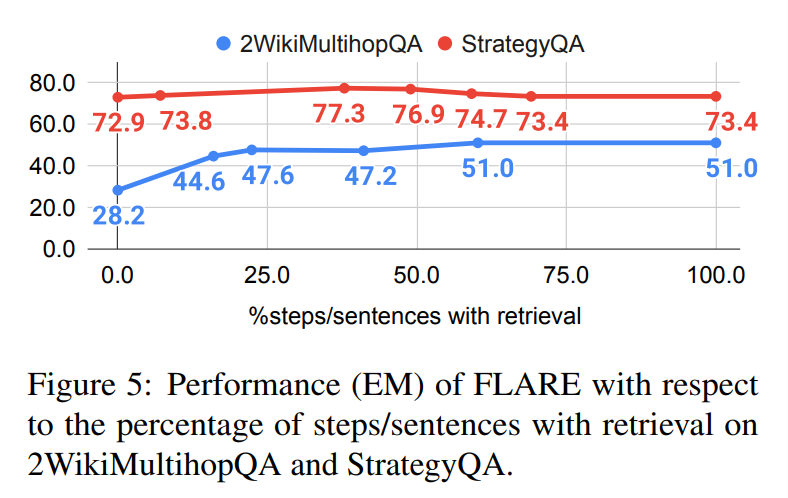
Confidence level을 측정하는 기준인 $\theta$는 어느 정도가 적당한 지를 파악하였다. $\theta$가 낮을수록 retrieval을 하지 않게 되고, 높을수록 모든 문장을 생성할 때마다 retrieval을 한다고 보면 된다.
Retrieval을 한 step의 비율을 계산하여 얼만큼의 $\theta$가 중요한지 파악하였다.
-
2WikiMultiHop에서는 60%가 넘어가자 성능이 일정하게 유지되는 것을 관찰할 수 있고 StrategyQA에서는 50%가 넘어가자 성능이 저하되는 현상을 관찰할 수 있다. 이는 과도하게 높은 $\theta$는 computational efficiency가 떨어질 뿐만 아니라 성능 저하까지 야기한다는 것을 보여준다.
-
Retrieval을 하는 비율이 40%~80%이도록 하는 $\theta$가 제일 적당하다는 것을 알 수 있다.
Effectiveness of different query formulation methods
$\text{FLARE}_{\text{direct}}$에서 search query를 생성하는 방법들을 탐구하였다.
우선 Masked sentences을 search query로 사용하는 방법에서 unconfident 기준인 $\beta$값에 따른 성능 변화를 측정하였다.
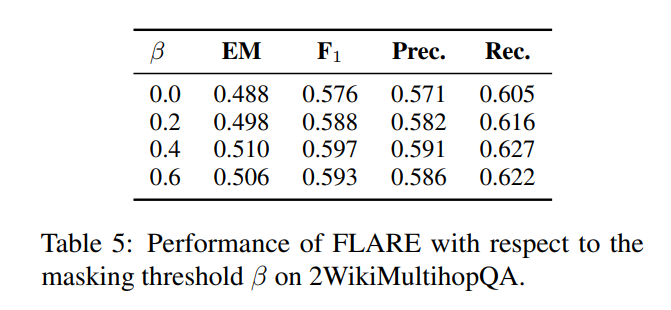
Masking을 아예 안 했을 때 ($\beta = 0$)보다 Masking을 어느 정도 했을 때 성능이 더 좋게 나오는 것을 통해 search query를 구성할 때 low confidence을 가진 (오류가 존재하는) tokens을 없애는 것이 좋다는 것이 증명되었다.
다음은 Masked sentences을 search query로 사용하는 방법 (Implicit)과 low confident span을 바탕으로 search query를 구성하는 방법 (explicit)을 비교한 결과이다.
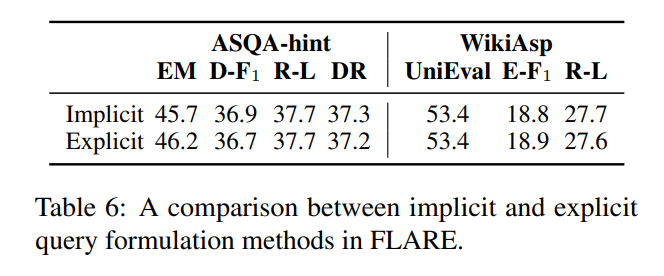
두 방법 모두 성능이 비슷하다는 것을 통해 두 방법 모두 효과적이라는 것을 알 수 있다.