FocusVLA: Focused Visual Utilization for Vision-Language-Action Models 리뷰
Background
Vision Language Acton Paradigms
VLA는 시각 정보와 언어 지시사항을 바탕으로 로봇 조작 신호들을 생성하는 대표적인 모델이다. VLA는 현재 두 종류로 나뉜다.
-
Diffusion/Flow matching
부드러운 행동을 생성할 수 있지만 추론 속도가 느리고 pretraining 양이 많다.
-
Auto-regressive
학습된 도메인에 대해서는 잘 맞추지만 정교하고 안정적인 행동 생성에는 성능이 좋지 않다.
이때, 본 논문은 Auto-regressive policy의 문제점의 원인은 encoder의 표현력 부족이 아니라 policy가 encoder로부터 추출된 visual language 정보를 효율적으로 사용하지 못하기 때문이라는 것이다.
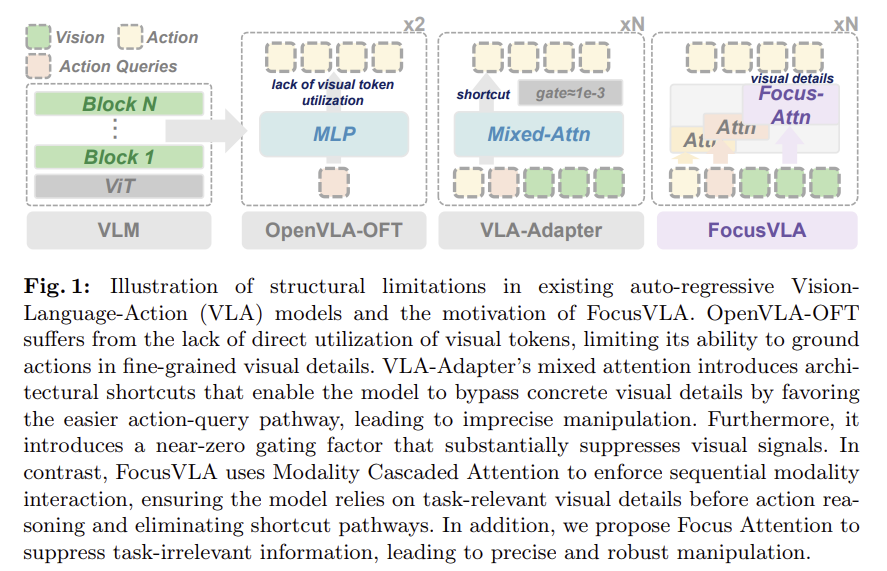
예를 들어 OpenVLA-OFT는 VLM 내부에서 vision과 language 정보를 contextualized hidden state으로 변환하고 이 정보가 action 생성 MLP에 들어가기 때문에 action을 생성할 때 visual/language 정보를 직접적으로 attend하지 못한다.
VLA-Adapter의 경우에는 언어 지시사항 (action query), 시각 정보, 그리고 현재 action 정보들이 mixed attention이라는 구조의 입력으로 들어가서 action을 생성할 때 다양한 modality들을 직접 attend 할 수 있는 장점을 가진다. 하지만 본 논문은 mixed attention 과정에서 structural bias가 존재한다고 주장한다. 즉, 여러 modality들을 한번에 넣었을 때 처리하기 어려운 vision 정보는 잘 보지 않고 이해하기 쉬운 언어 (action query)에만 attention score가 집중되어서 attend하는 modality에 bias가 생길 수 있다는 것이다.
VLA Adapter의 원리 및 mixed attention
VLA Adapter의 원리를 자세히 보자면 두 개의 VLM conditions: vision feature $C_t^V$ 와 action query $C_t^{\text{AQ}}$ 을 합친다. 이때 t는 t번째 VLM layer의 정보 (condition)가 t번째 policy layer에 들어간다는 뜻이다.
\[W_t = \operatorname{Softmax} \left( \frac{ \left[ S_V \circ \tanh(g),\; S_{\mathrm{AQ}},\; S_A \right] }{ \sqrt{d} } \right) >\]각 attention layer는 이 두 condition을 바탕으로 mixed attention을 계산한다.
\[\begin{aligned} S_V &= (\sigma_q(A_t))(\sigma_k(C_t^{V}))^\top, \\ S_{AQ} &= (\sigma_q(A_t))(\sigma_k(C_t^{AQ}))^\top, \\ S_A &= (\sigma_q(A_t))(\sigma_k(A_t))^\top. \end{aligned}\]여기서 S는 attention score을 의미한다.
$\sigma$ 는 MLP projection을 의미한다. 최종적으로 latent action $\hat A_t$ 는 다음처럼 계산된다. Latent action은 residual FFN으로 들어가서 update된 latent action $A_{t+1}$ 을 생성한다.
이런 문제로 인해서 auto-regressive policy들이 섬세한 action을 생성하지 못하고 visual 정보와 action 간의 mapping을 성공적으로 할 수 없다고 주장한다.
이 주장을 정당화하기 위해 본 논문은 시각 정보가 주어졌을 때 autoregressive 기반 VLA가 이 정보를 활용을 잘 하지 못하는 이유를 다음 두 질문에 대한 실험을 진행한다.
-
Raw visual representation이 action 생성에 긍정적인 영향을 주는지 그리고 이 영향력을 어떻게 최대화할 것인가?
-
Visual representation을 활용하는 방법이 representation의 quality보다 중요한가?
4개의 framework와 3개의 visual representation을 사용해서 탐구를 한다.
첫 번째 질문을 위해서 baseline으로는 (a)visual tokens을 그대로 사용하는 framework을 사용한다. 그 다음 (b) Visual tokens의 수를 2x2 pooling으로 줄였을 때, (c) 하나의 parameter gate을 통해 visual signal의 강함 정도를 약화시켰을 때, 그리고 (d) attention 패턴을 cascaded attention으로 바꿨을 때의 세 가지 constraint을 적용하였다.
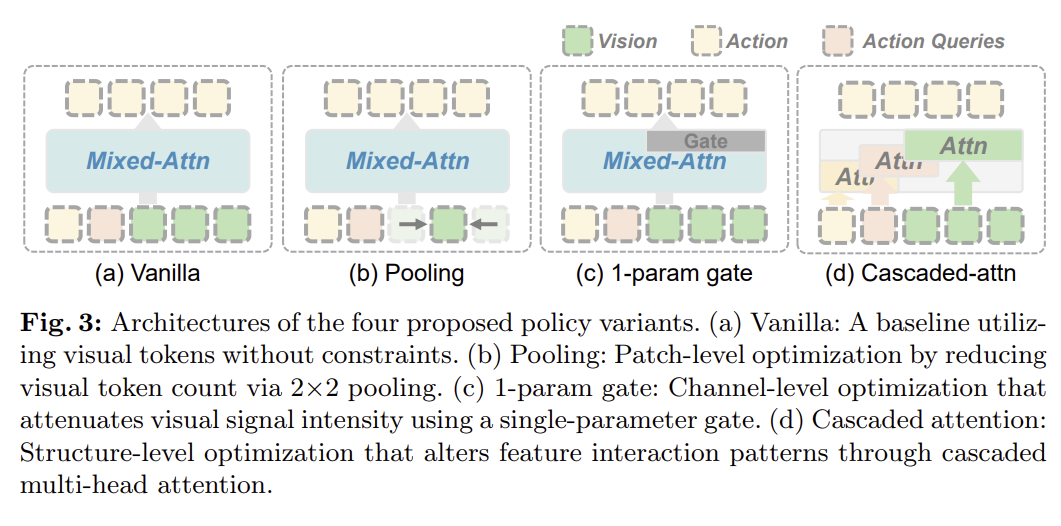
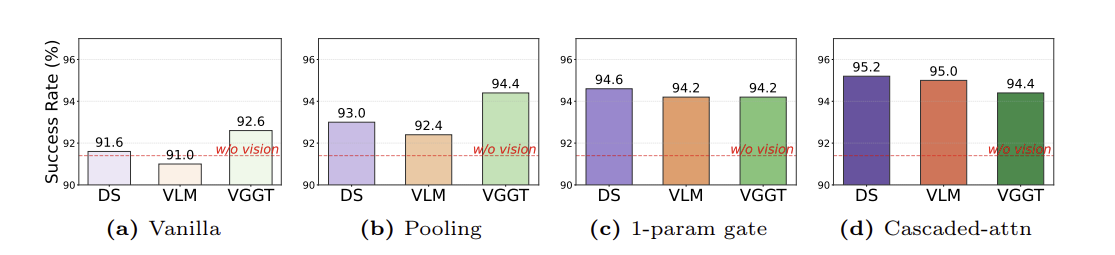
두 번째 질문을 위해서 visual representation의 quality의 영향력을 확인하기 위해 DINOv2 + SigLIP (task 관련성 정보가 없는 2D features), VLM output (task 관련성 정보가 있는 2D features), 그리고 VGGT(task 관련성 정보가 없는 3D features)를 사용하여 각 framework에 LIBERO benchmark에서 실험을 하였다.실험 결과는 다음과 같다.
Key findings 1
Visual token 수를 줄이거나 visual signal의 세기를 줄이는 것만으로도 baseline보다 성능이 좋아졌다. 이 실험을 통해서 (a) visual token 수가 과도하다는 것을 알 수 있고 너무 많아서 오히려 policy의 성능을 저하시킨다는 것을 알 수 있따. 또, (b) 방해되는/관련없는 token 세기가 약해져서 좋아진 것이 실제 성능에 관여하는 signal 세기가 약화되어서 안 좋아진 것보다 더 효과적이었다는 것을 알 수 있다.
Low signal noise to noise ratio (SNR)을 완화하면 불필요한 정보가 관여하는 정도가 줄어듦
Key findings 2
Mixed attention에서 cascaded attention을 사용했더니 attention scores의 분포가 특정 영역들에 집중된 경향을 보인다.
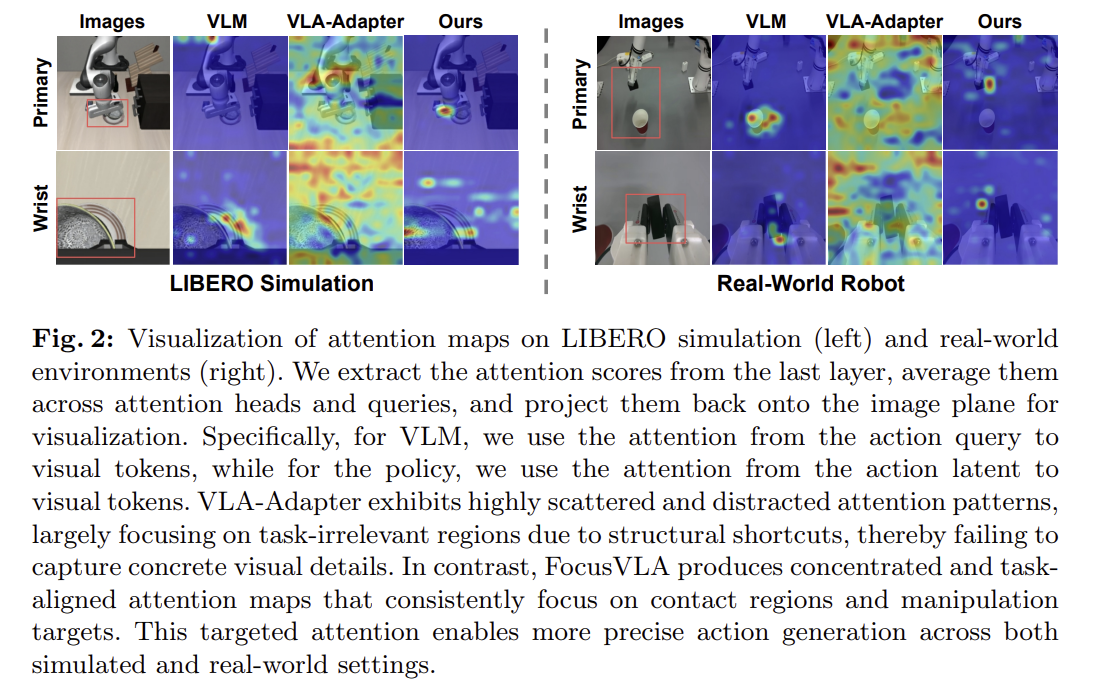
또, cascade attention을 사용했을 때 성능이 가장 좋아졌다는 것을 통해서 visual representation의 quality보다는 task에 관련된 것에 집중을 하게 하는 것이 훨씬 중요하다는 것을 알 수 있다.
Key findings 3
어떤 visual representation을 사용하더라도 성능차이가 별로 나지 않는다는 것을 통해서 VLA policy의 성능은 visual representation의 quality가 아니라 어떻게 활용해야 하는지에 따라 크게 달라진다는 것을 알 수 있다.
정리하자면, 본 논문은 다음 세 가지 이유로 autoregressive 기반 policy가 visual information으로부터 action을 유도하지 못한다고 정리한다.
-
Architectual bias
Mixed attention으로 인해 action을 생성할 때 visual information을 대충 보게 될 수 있는 경향이 존재한다.
-
Information overload
모델이 좋은 성능을 내기 위한 visual token 수보다 훨씬 많은 양이 들어오기 때문에 섬세한 visual informaton을 capture하기 어렵다.
-
Task Irrelevant noise
Background 정보에는 task와 관련없는 정보들이 많기 때문에 실제 관련성 높은 정보들은 잘 capture하지 못한다.
FocusVLA Methodology
본 논문은 위 실험 결과들을 바탕으로 Modality Cascaded Attention와 Focus Attention을 제안한다.
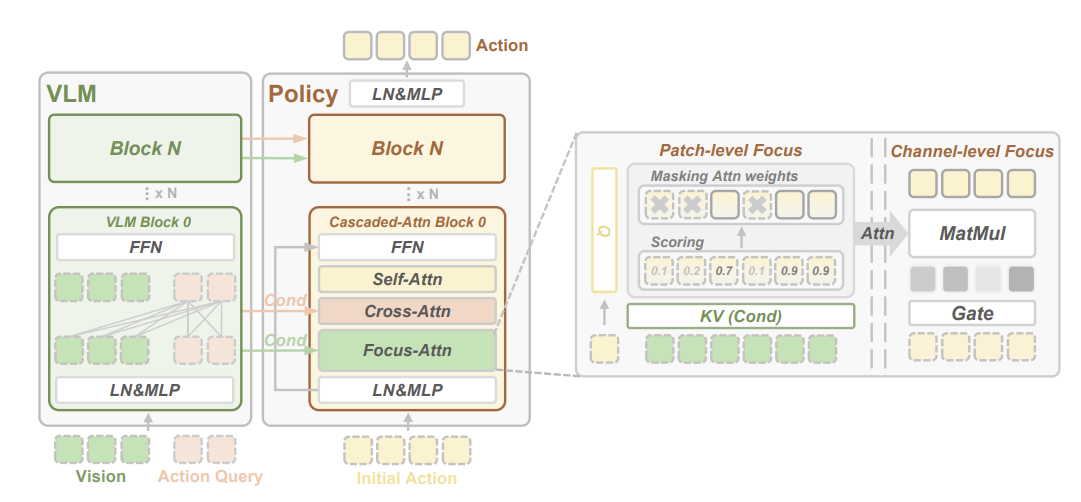
Modality Cascaded Attention
모든 modalty을 다 하나의 attention에 넣는 것이 아니라 cascade 구조를 통해서 modality별로 latent action과의 attention score을 계산한다.
즉, 각 layer마다 action latent $A_t$ 와 각 modality 간의 attention score을 계산한 뒤에
\[\begin{aligned} H_A &= \operatorname{Attn}(A_t,A_t),\\ H_{AQ} &= \operatorname{Attn}(A_t,C_t^{AQ}),\\ H_V &= \operatorname{Attn}(A_t,C_t^V) \end{aligned}\]이 output들을 concatenate하여 하나의 fusion MLP에 입력으로 넣어 aggregated action latent $\hat A_t$ 을 얻는다. $\hat A_t$ 은 그 다음에 residual FFN에 들어가서 update된 latent $A_{t+1}$ 을 얻는다.
Modality을 한번에 섞지 않고 하나씩 추가함으로써 action latent가 특정 modality에 의존하도록 하는 것을 막고 structural bias을 없애서 task와 관련있는 모든 modality를 모두 참조하도록 한 것이다.
Focus Attention
Modality 중에서 시각 정보 representaton $C^V_t$ 와 attention을 할 때 focus attention을 적용하여 visual token 개수와 low signal to noise ratio을 조절한다.
이것이 가능하기 위해서 서로 보완적인 두 부분에서 regulation을 적용한다.
Patch와 channel은 이미지가 vision encoder을 통과했을 때 만들어지는 visual feature의 서로 다른 두 축이다. Vision feature $V \in \mathbb{R}^{N \times D}$ 라고 할 때 $N$이 patch, 즉 visual token 개수이고 $D$가 channel, 즉 token의 차원 크기이다.
Patch level regulation은 task와 관련없는 visual token의 수를 줄여주는 역할을 하고 channel level regulation은 visual token 내에서 관련없는 부분들을 억제하는 역할을 한다. 이 방법들을 통해 action latent을 계산할 때 필요한 정보만 볼 수 있도록 한다.
Patch level Focus
기존의 visual token 수를 건들이는 연구들은 효율성을 높이기 위해서 VLM 부분에서 token selection을 하게 해서 visual token 수를 줄였지만 본 논문은 action prediction의 성능을 높이기 위해서 policy 부분에서 처리하는 visual token의 수를 줄이는 방법을 제안한다.
Policy에서 visual token 수를 줄이는 방법을 적용하는 이유는 VLM은 이미 large scale web data의 pretraining을 통해서 주어진 task과 관련된 영역들을 알 수 있는 반면에 VLA의 policy 부분은 VLM보다 훨씬 적은 parameter들을 가지고 있으며 보통 scratch부터 학습되기 때문에 이런 능력을 가지고 있지 않게 때문이다.
즉, policy에게 따로 어떤 visual token들이 중요한지 알려줘야 한다는 것이다. 따라서, 중요한 visual token들을 골라주기 위해서 action query와 visual 정보 keys 간의 cross attention score을 사용한다.
\[W_V = \operatorname{Softmax} \left( \operatorname{TopK} \left( \left(\sigma_q(A_t)\right) \left(\sigma_k(C_t^V)\right)^{\top} \right) \right),\]Attention score에서 top k score만 사용함으로써 top k 안에 들지 않는 visual token들은 masking 처리를 해버린다.
그 다음 vision to action attention은 다음처럼 계산한다.
\[H_V = W_V \left( \sigma_v(C_t^V) \right)^{\top}\]Channel level Focus
Patch level focus을 통해서 이미 task relevant 영역 (visual tokens)가 무엇인지 알아내었기 때문에 처음 실험처럼 single parameter gate을 통해 모든 visual signal들의 세기를 약화시킬 필요가 없다.
따라서 본 논문은 element wise gate을 사용해서 noise control을 더 세부적으로 할 수 있게 하여 task relevant channels만 사용하도록 하였다.
\[H'_V = H_V \odot \sigma_g(A_t)\]이때 $\sigma_g$ 가 element wise gate MLP이고 $\sigma_g (A_t)$ 는 현재 action에 필요한 visual feature channel을 판단하는 gate이다.
어떤 시각적 특징이 중요한지는 현재 수행하려는 행동에 따라 달라지므로 $A_t$에 적용한 것이라고 이해하면 된다.
종합적으로 보았을 때 Focus Attention을 통해서 방해되는 visual 정보는 제거하고 task와 관련성이 높은 정보들만을 통해 다음 action을 생성하는 방법론을 소개하는 것이다.