Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware 리뷰
Background
세밀한 작업을 하기 위해서는 환경 변화에 빠르게 대응해야 하고 hand-eye coordination이 좋아야 한다.
정확성과 시각적 피드백이 필수인 문제 상황에서는 behavior cloning은 어려움을 겪는다. 정확한 demonstration으로 학습을 하더라도 inference 할 때 앞에서 한 행동이 training distribution에 없던 scene을 만들면, 그 다음 행동을 할 때 OOD 문제를 일으켜 그 이후로 error가 계속 축적되는 compounding error 문제가 생긴다.
Compounding errors을 해결하기 위해서 보통 DAgger와 같이 error로부터 복구하는 데이터 (on-policy interactions / expert corrects)를 추가해서 더 학습시키는 방법도 존재하는데 이런 방법은 cost가 높다.
Demonstration data을 얻을 때 일부러 실수를 하게 하고 그 실수로부터 복구하는 전체 과정을 추가함으로써 compounding errors 문제를 해결할 수 있다. 하지만 세밀한 작업을 해야 하는 도메인에서는 이런 noise가 로봇 행동의 세밀함을 저하시킬 수 있다.
Action Chunking with Transformers (ACT)
Action Chunking and Temporal Ensemble
본 논문은 behavior cloning의 compounding errors을 해결하기 ACT을 제안한다.
우선 human demonstrations에서 leader arm의 joint position 값들을 정답 action이라고 정의한 다음에 observation으로 camera input이 들어올 때 연속적인 actions을 예측하도록 하였다. 각 action은 target joint position 값으로 정의한다.
ACT로 학습을 한다는 것은 하나의 observation이 주어졌을 때, 동일한 timestep에서 사람이 한 행동을 그대로 따라하도록 하는 것이다.
50 Hz로 2초의 행동을 했다면 이는 총 100개의 actions가 생긴다. 기존의 behavior cloning은 100개의 독립적인 prediction 문제로 생각하기에 effective horizon이 길었다. Effective horizon이 길었기 때문에 compounding errors가 발생할 가능성이 높았던 것이다. 하지만 ACT는 이 100개의 actions을 10번의 action (10개의 action trajectory)로 생각하는 것이다. 즉, effective horizon이 10으로 줄여서 짧은 prediction 문제로 바꿔 compounding errors가 발생할 가능성을 줄인 것이다.
Action chunks을 k steps마다 새로운 observation 값을 받고 예측을 하고 그대로 실행을 하게 되면 k steps마다 action chunk 간에 부드럽지 않을 수 있다. 따라서 매 timestep마다 policy에게 query해서 매 timestep마다 여러 action predictions을 갖게 하였다. 그리고 매 timestep마다 이 actions을 weighted sum하여 부드러운 actions을 갖게 하였다. 이 방법을 temporal ensemble 이라고 한다.
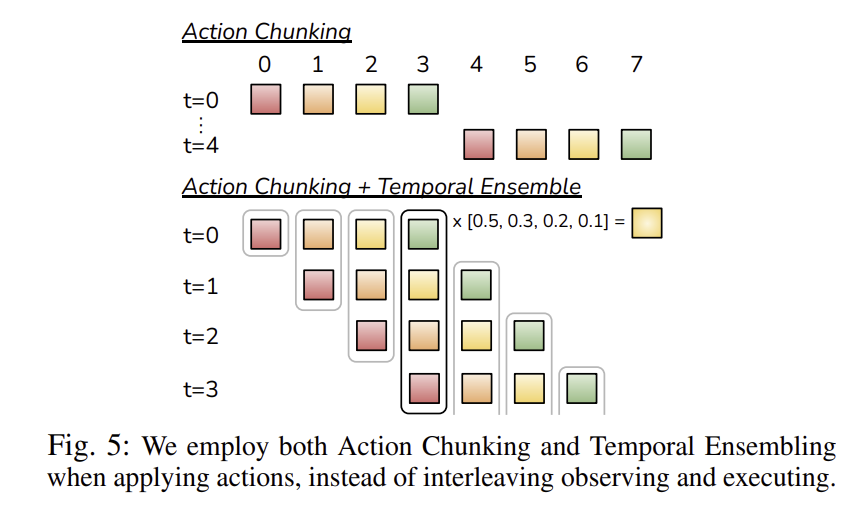
각 weight $w_i$ 는 $\exp^{\text{-m * i}}$ 값을 갖게 하여 오래된 actions일 수록 더 많은 가중치를 갖게 하였다.
Modeling Human Data
behavior cloning의 또 다른 문제점은 human demonstration에 존재하는 noise다. 동일한 observation이 주어지더라도 사람은 다른 방법을 사용해서 주어진 task을 수행할 수 있다. 이런 noise는 behavior cloning에 큰 영향을 준다. 하나의 observation마다 하나의 action만 예측하는 behavior cloning에서는 noise까지 학습할 수 있기 때문이다.
이 문제를 해결하기 위해서 action chunking policy를 generative한 model로 만들었다. Regression 기반 policy들은 noise으로 인해 action 답으로 동일한 observation에도 다른 trajectory가 존재하면 이 trajectory의 평균값으로 답을 도출한다. 하지만 generative 기반 policy로 정의하면 $p(a_t:a_{t+H} \mid o)$ 분포를 학습하기에 다양한 trajectory가 존재하더라도 문제가 생기지 않는다.
이 논문에서 사용한 모델은 Conditional Variational AutoEncoder(CVAE) 이다.
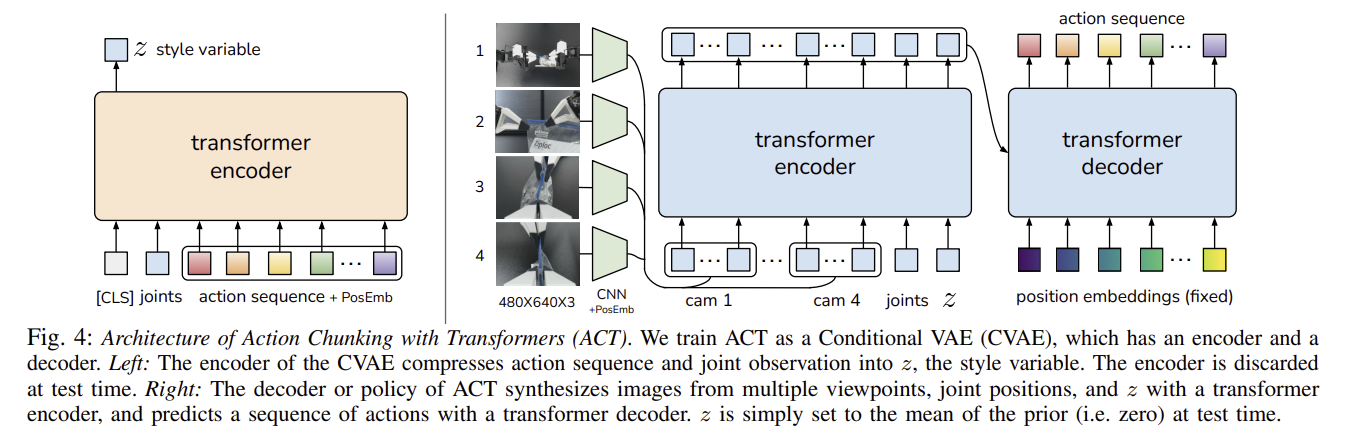
CVAE는 encoder와 decoder로 이뤄진 모델로 encoder는 decoder (policy)을 학습시키기 위한 부품일 뿐이며 inference 때는 사용되지 않는다. Encoder는 현재 observation과 action들이 주어졌을 때 style variable z (상황이 주어졌을 때 가능한 여러 행동 방식)의 평균과 분산을 예측하도록 학습이 된다.
이럴 때 decoder는 z와 현재 observation (이미지 + joint positions)으로 action chunk을 예측하도록 학습이 된다.
\[\min_{\theta} - \sum_{s_t, a_{t:t+k}\in D} \log \pi_{\theta}(a_{t:t+k}\mid s_t)\]추론 시에는 z (= prior distribution의 평균)이 주어진 상태로 action chunks을 생성한다.
Implementing ACT
CVAE의 encoder는 BERT 형태이며 현재 joint position과 action 정답이 주어졌을 때 CLS 토큰에 style variable z의 정보가 encoding 되고 이 CLS 토큰으로 z을 예측하는 것이다.
CVAE의 decoder는 현재 observation과 z을 input으로 받아서 다음 action chunks을 예측한다.