15: Beyond Physical Memory: Policies
Beyond Physical Memory: Policies
앞서 말했듯이 page을 memory에 넣어야 하는데 자리가 없을 때, memory에 존재하는 page들의 일부를 없애는 작업을 해야 한다. 이때, 없앨 page을 고르는 과정을 replacement policy라고 한다.
Cache management
Physical memory는 전체 page들 중 일부를 지니고 있기에 virtual page를 저장하는 hard disk 관점에서 cache로 해석될 수 있다. 따라서 없앨 page을 고를 때, 다음에 cache miss가 안 나도록, 즉 나중에 쓰일 page을 없애지 않도록 policy을 설계해야 한다.
Cache miss와 hit rate을 통해 memory에 접근하는데 얼만큼의 시간을 사용하는지 계산할 수 있다. 이 방법을 Average memory access time (AMAT) 라고 한다.
\[\text{AMAT} = (Hit rate * T_M ) + (Miss rate * T_D )\]이때 $T_M$은 memory에 접근하는데 걸리는 cost이고 $T_D$는 disk에 접근하는데 걸리는 cost이다.
예를 들어 4KB address space가 있고 page는 256 byte라고 해보자. 그러면 page 개수는 $2^12 / 2^8 = 2^4 = 16$ 개이며 VPN은 4 bit, offset은 8 bit가 된다.
이때 process가 0x000, 0x100, 0x200, 0x300, 0x400, 0x500, 0x600, 0x700, 0x800, 0x900 메모리 접근을 한다고 해보자. 그리고 virtual page 3만 메모리에 존재하지 않는다고 해보자. 그럼 순서대로 hit, hit, hit, misss, hit, hit, hit, hit, hit, hit 가 난다. 따라서 hit rate는 90%, miss rate는 10%가 된다. $T_M$이 100 nanoseconds이고 $T_D$가 10 milliseconds라고 했을 때
\[AMAT = 0.9 * 100ns + 0.1 * 10ms = 1.00009 ms\]1 millisecond가 나온다. Miss rate가 90%여도 이런 시간이 나온다는 것은 cache miss가 났을 때 생기는 성능 저하가 엄청 크다는 것이다.
Optimal Replacement Policy
따라서, 최적의 방법으로 page을 없애려면 miss가 안 나도록 미래에 사용할 page 들 중에서 가장 먼 미래에 사용할 page을 없애는 것이다.
Optimal replacement policy의 예시를 보자. Process가 virtual page을 0,1,2,0,1,3,1,2,1 순서로 접근한다고 하고 cache에는 3개의 page 정보만 들어갈 수 있다고 해보자.
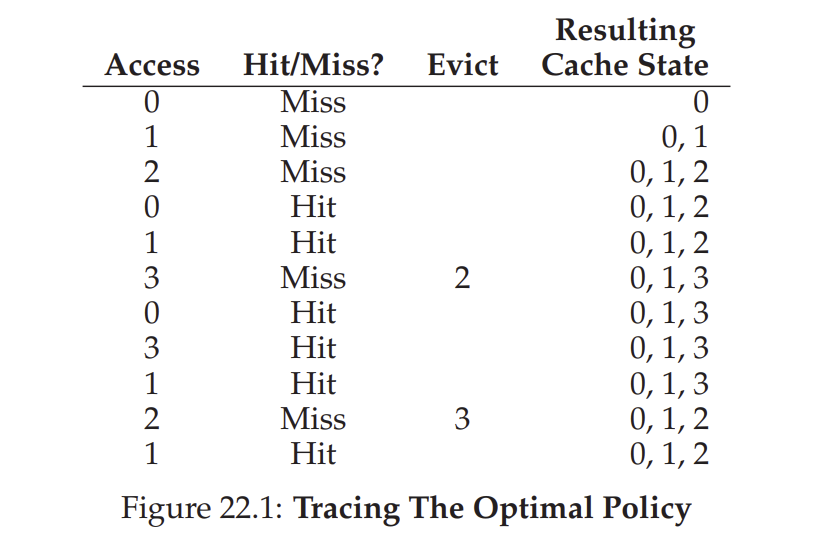
처음에는 cache가 비어있기 때문에 miss가 날 수 밖에 없다. 이를 cold start miss라고 한다. 6번째는 access에서 cache에는 0,1,2가 있는데 3이 필요한 상황이다. 이때 그럼 cache에서 한 page을 골라서 swapping을 해야 하는데 optimal policy는 미래를 보고 2가 0과 1보다는 더 나중에 쓰이기 때문에 2를 제거하고 3을 넣는다. 이 방법으로 hit rate을 계산하면 54.6% ($\frac {hits} {hits + misses} = \frac {6} {6 + 5}$)다. cold start miss을 포함하지 않는다면 85.7%의 hit rate이 나온다.
하지만 실제로는 미래를 볼 수 없기 때문에 optimal policy는 비현실적이다. 따라서 다음 방법 중 하나를 사용한다.
FIFO
FIFO는 replacement가 일어나야 할 때, cache에 가장 먼저 들어온 page을 없앤다.
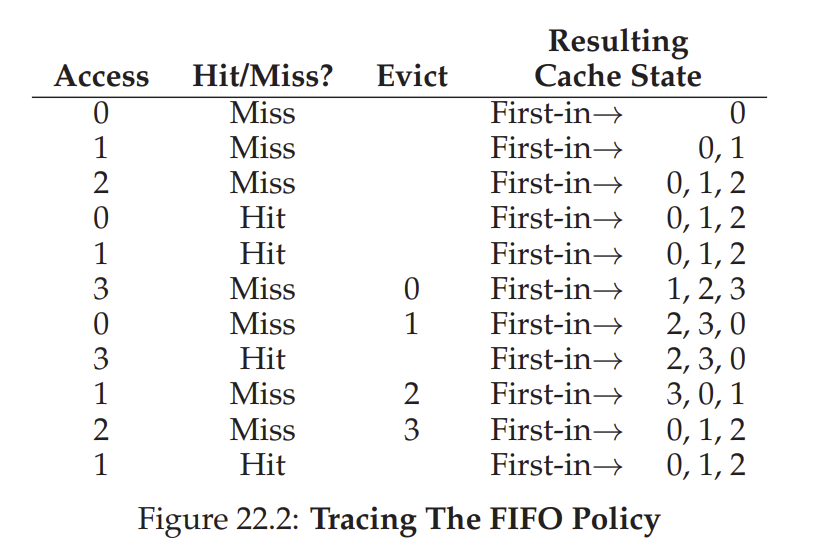
3을 access 해야 할 때, cache에 가장 먼저 들어온 0을 없애는 것을 볼 수 있다. 이 policy을 그대로 적용하면 hit rate가 36.4%, cold start miss을 포함하지 않으면 57.1%의 hit rate이 나온다.
이런 hit rate이 나오는 이유는 FIFO는 각 page의 중요성을 고려하지 않고 (지금까지 0은 1과 2보다 더 access 되었음으로 중요하다고 볼 수 있음) 온 순서만 신경쓰기 때문이라고 볼 수 있다.
Belady’s Anomaly
보통의 policy들은 cache가 증가하면 hit rate이 증가하는데 FIFO에서는 다른 양상을 보일 수도 있다. Cache가 증가하면서 page가 더 오래 머무는데 FIFO가 evict하는 주기와 오래된 page가 실행되어야 할 때가 겹쳐서 계속 cache miss가 나는 경우이다.
Random
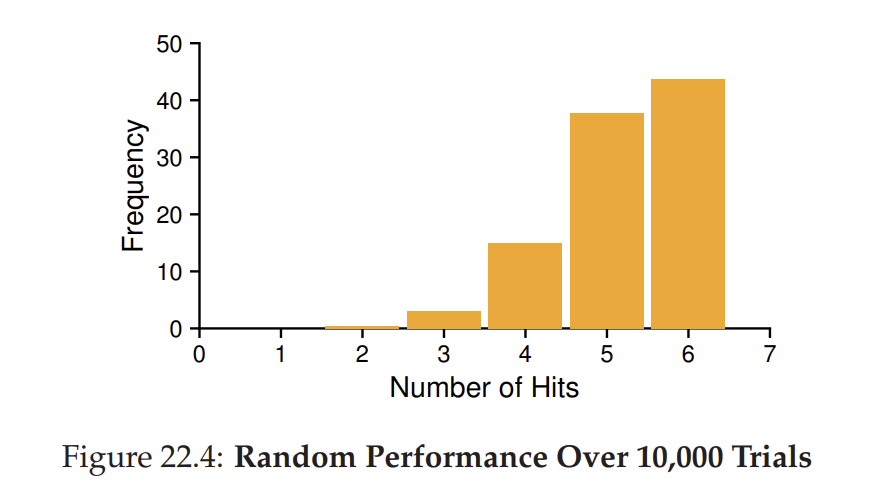
Random은 말 그래도 무작위의 page을 골라서 없애는 policy이다. 즉, Random도 page의 특성을 고려하지 않는다는 특징이 있다. 하지만 trial을 많이 할수록 hit rate가 올라가는 경향이 있고 가끔 optimal policy와 비슷한 성능을 낼 때도 존재한다.
History 사용: LFU, LRU
FIFO나 Random은 page의 특징을 활용하지 않기에 문제가 있었다.
그럼 page의 특징 정보는 어떻게 이해할 수 있을까? 과거의 정보를 통해 미래를 예측하는 수 밖에 없다.
과거 정보 중 하나는 frequency이다. Page가 지금까지 얼만큼 접근되었는지를 통해 page의 특성을 알아낼 수 있다. 다른 하나는 recency이다. Page가 얼마나 최근에 접근되었는지를 통해 page의 특성을 알아낼 수 있다.
이런 정보를 활용한 policy는 결국 locality을 활용한 policy라고 볼 수 있다.
LFU는 Least Frequently Used policy로 가장 적게 사용된 page을 제거하는 policy이다.
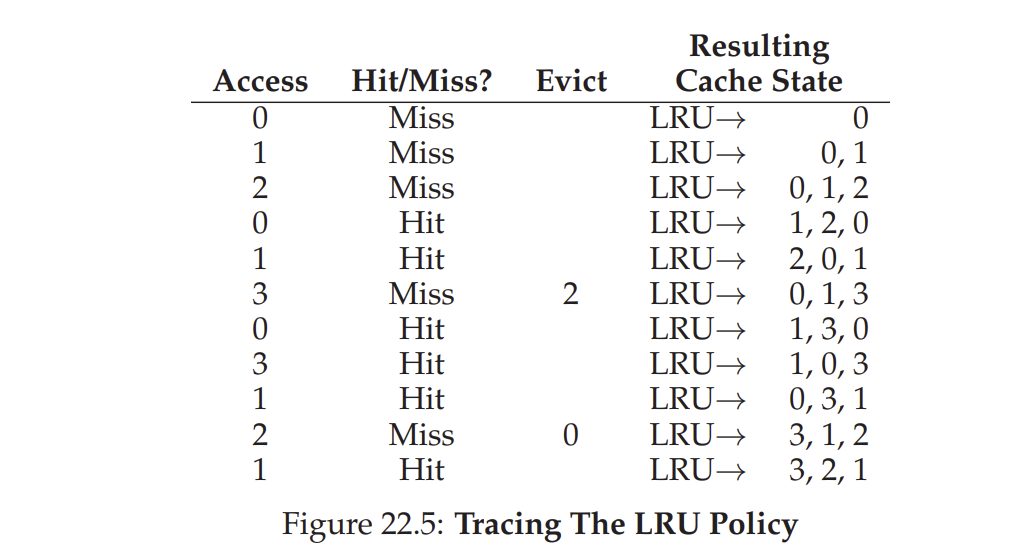
한편 LRU는 Least Recently Used Policy로 가장 예전에 사용되었던 page을 제거하는 policy이다.
$\rightarrow$ temporal locality
이 중 LRU가 작동하는 방법의 예시를 보자
Workload examples
그럼 지금까지 어떤 policy가 제일 좋을까? 사실 policy의 성능은 process가 메모리에 접근하는 패턴에 영향을 받는다. 다시 말하자면 메모리 접근을 하는 작업을 여러 개 모아놓은 것은 workload라고 하는데 workload의 성격에 따라 관측되는 policy의 성능이 달라진다.
예를 들어 workload에 locality라는 성격이 없고 다 random한 접근이라고 해보자.
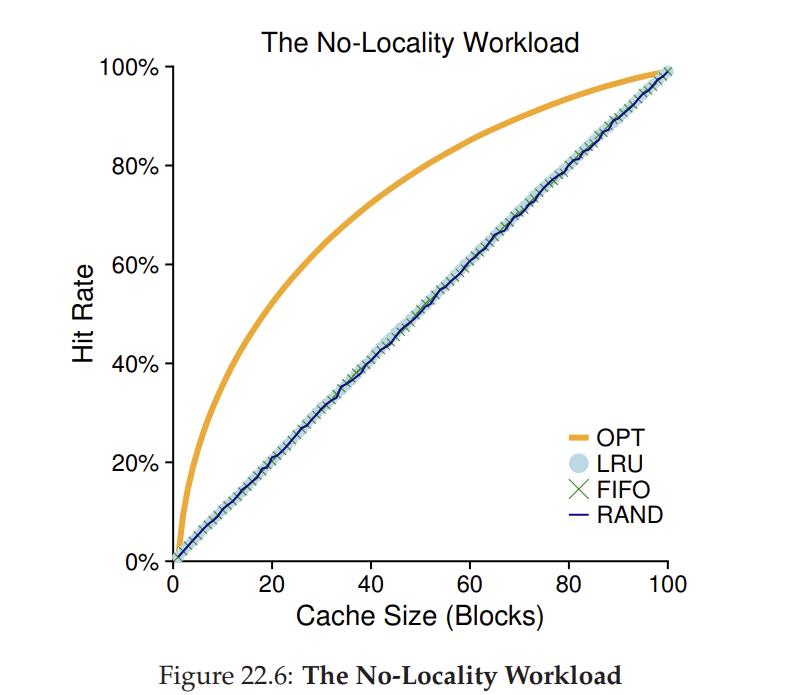
그렇다면 어떤 policy을 사용하던 다 비슷하게 결과가 나온다. 또, cache가 증가하게 되어 workload을 다 저장할 수 있는 상태까지 가면 모든 policy의 성능이 비슷하게 나온다 (miss가 날 수 없기 때문에)
반대로 workload에 locality 성격이 있다고 해보자.
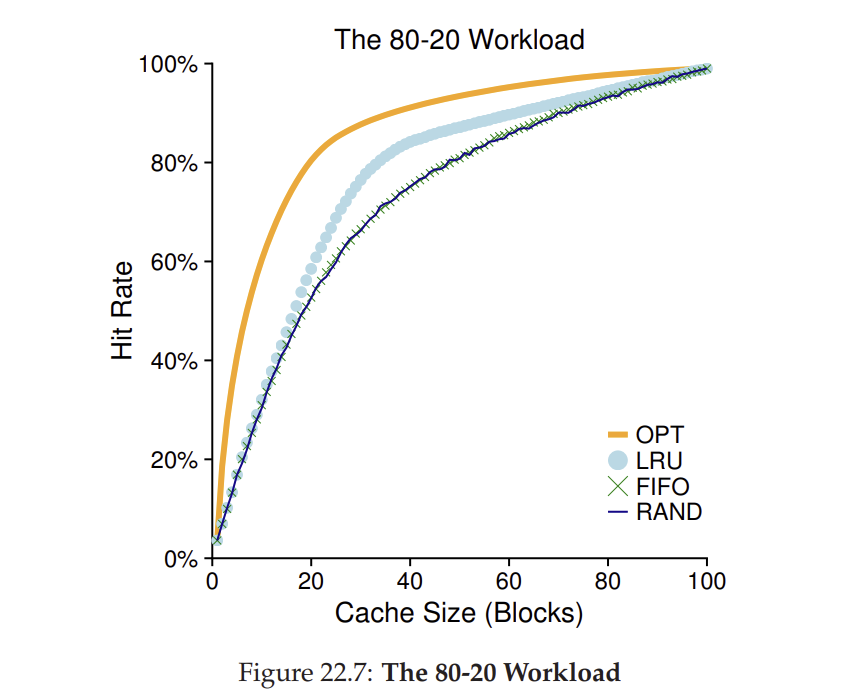
이때는 page의 성격, locality 정보를 사용하는 LRU가 다른 방법들모다 더 좋은 성능을 보인다. 하지만, 그렇게 크게 차이가 나지 않는다는 것을 알 수 있다.
이젠 workload가 1->50까지 순서대로 접근하는 작업의 반복이라고 해보자
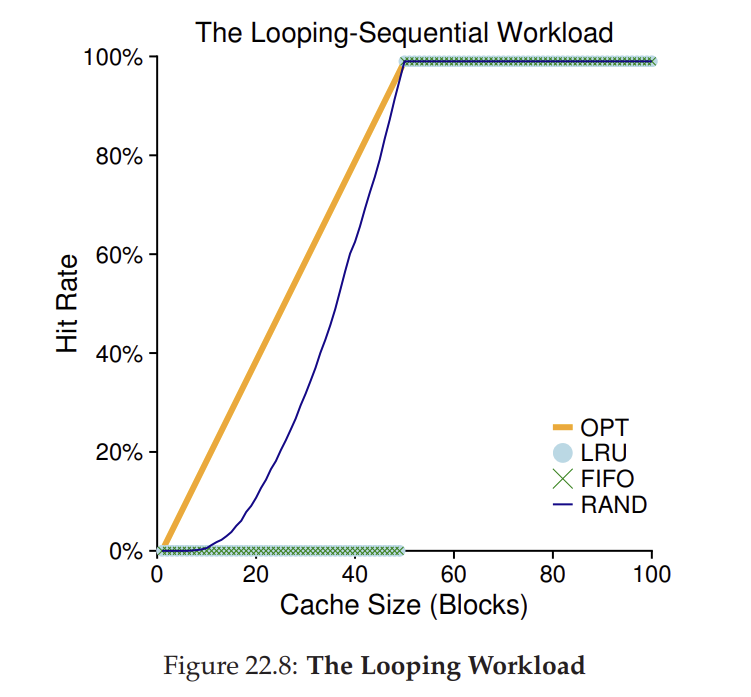
Cache 크기가 50이기 전까지 LRU을 적용하면 50을 접근해야 할 때 1은 이미 evict된 상황이라 hit rate가 0이 된다는 것을 관찰할 수 있다. 하지만 random은 이와 상관없이 잘 작동한다는 것을 볼 수 있다. 따라서 최적의 policy는 존재하지 않고 workload의 성격에 따라 성능이 많이 차이 날 수 있다는 것이다.
Implementing Historical Algorithms
LRU와 같은 historic replacement algorithm을 구현한다고 해보자. 이런 알고리즘은 메모리 access 요청이 올 때마다 이전 정보를 확인하는 작업을 거쳐야 하기 때문에 속도가 저하될 수 있다.
Page 수가 많아지면 많아질수록 제일 나중에 사용된 page을 결정하는 작업은 더 오래 걸리게 된다. 속도를 높이기 위해 적용한 아이디어가 정확한 least recently used page을 구하는 것이 아니라 추정치를 사용하면 되지 않을까라는 것이다.
Approximating LRU
Hardware의 도움을 통해 LRU의 approximation을 할 수 있다. Hardware의 도움의 예시로는 reference (use) bit가 있다. Use bit은 page가 사용되었을 때, 1이 되어 이 page가 사용된 적이 있음을 알려주는 역할을 한다.
그렇다면 LRU을 approximate하기 위해서는 어떤 방법을 사용할 수 있을까? 가장 간단한 방법은 clock algorithm 이다.
모든 page을 circular list에 넣고 clock hand (시침)은 아무 page나 가리키도록 한다.
replacement가 일어나야 할 때, 현재 시침이 가리키고 있는 page의 use bit을 조회한다. 1이라면 사용된 적이 있는 page이기에 locality에 따라 나중에도 사용될 가능성이 있다고 생각하고 다음 page으로 간다. Use bit가 0인 page을 찾게 된다면 그 page는 least recently used page라고 가정하고 그 page을 제거한다.
모든 page의 use bit가 1이라면 그냥 use bit을 다 0으로 초기화해버린다
이 clock algorithm의 variant도 존재한다. 시계방향으로 page들을 조회하는 것이 아니라 랜덤으로 한 page을 조회하는 방법을 사용한다. 이 page의 use bit가 1이라면 0으로 설정하고 다시 랜덤으로 한 page을 조회한다. Use bit가 0이라면 그 page을 제거하는 방법을 사용한다.
이 Clock variant algorithm의 성능 그래프를 봐보자.
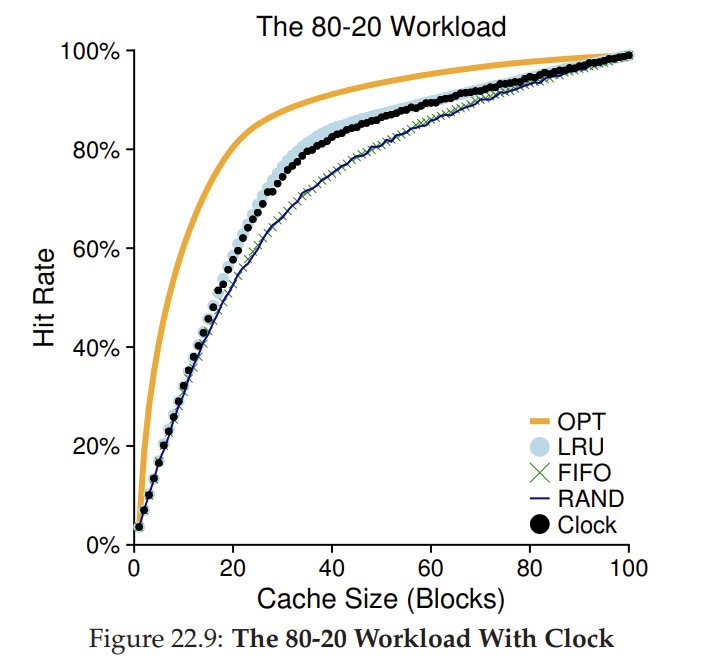
LRU와 clock가 그렇게 많이 차이나지 않음을 알 수 있다.
Dirty pages 활용
이 algorithm에서 dirty bit 정보를 사용해서 더 발전시킨 방법이 있다.
Dirty bit가 1이라면, 이 정보는 disk에 있는 정보와 다르다는 것을 의미하기에 이 정보를 결국 disk에 update 해야 한다. 하지만 이 과정은 expensive하다. 반면, dirty bit가 0이라면 disk에 update을 하지 않아도 되기에 이 page을 없애는 과정은 비용이 없다.
이 원리를 사용한 clock algorithm은 evict page의 우선 순위를 둔다.
-
1등: 사용된 적 없으며 dirty하지 않을 때
$\rightarrow$ 지금 필요없고 비용이 거의 안 들기에
-
2등: 사용된 적 없으며 dirty할 때
$\rightarrow$ 지금 필요없고 어처피 disk에 바뀐 내용을 update해야 하기에
Other Virtual Memory Policies
어떤 page을 제거할 지 정하는 알고리즘 외에도 어떤 page을 memory에 들여올 지 정하는 알고리즘도 중요하다. 이르 page selection policy라고 한다.
-
Demand paging
요구될 때만 그 page을 memory로 가져오는 방법을 의미한다.
-
Prefetching
locality을 기반으로 나중에 사용될 page들을 미리 가져오는 방법을 의미한다.
Page을 evict할 때 어떤 방법으로 disk에 저장할 것인지 결정하는 알고리즘도 존재한다.
-
Clustering/Grouping
Evict 되어야 하는 page들을 몇 개 모은 뒤에 한꺼번에 disk에 저장하는 방법이다.
Thrashing
만약에 요구되는 memory 양이 실제 존재하는 memory 양보다 많으면 어떻게 해야할까? 이 상황에서 system은 계속 paging을 하면서 memory에 들어갈 수 있는 page을 찾는 과정만 반복하고 실제로 진행되는 것은 없을 수 있다. 이 상황을 Thrashing이라고 한다.
이 문제를 해결하기 위해서 두 가지 해결책이 소개된다.
-
Admission Control
전체 프로세스를 다 돌리려다 다 망하는 것보다 일부만 선택해서 제대로 실행하는 방법이다.
선택된 프로세스들의 working set (프로세스가 현재 활발하게 사용 중인 페이지들의 집합)이 메모리에 맞게 유지된다면 thrashing 없이 진행 가능
“모든 것을 형편없이 하는 것보다 적은 것을 제대로 하는 것이 낫다”의 철학이 담겨있다고 생각하면 된다.
-
Out of Memory Killer
메모리를 가장 많이 쓰는 프로세스 선택해서 강제로 kill하는 방법이다. 하지만 가장 많이 사용하지만 중요한 프로세스를 없앨 수 있다는 점에서 단점이 존재한다.