12: Paging Faster Translations (TLB)
Paging : Faster Translations (TLB)
Address translation을 하기 위해서 memory access을 두 번 하는 과정에서 paging은 속도가 너무 느려진다. 그렇다면 이 address translation을 얻는 과정을 더 빠르게 할 수는 없을까?
OS는 이 과정을 빨리 하기 위해서 TLB라는 hardware의 도움을 받는다. TLB는 MMU의 한 부분으로 address - translation cache라고 생각하면 된다. Cache을 사용해서 memory에 접근하지 않고도 virtual address에 해당하는 PFN을 얻어서 address translation 과정을 빠르게 해줄 수 있게 한다.
Virtual address로부터 VPN을 얻고 바로 hardware에서 PFN을 찾는 것이 아니고 우선 TLB에 PFN 정보가 존재하는지 확인하는 것이다. TLB hit이 난다면, memory 접근을 한 번 덜 할 수 있게 되는 것이다.
VPN = (VirtualAddress & VPN_MASK) >> SHIFT
(Success, TlbEntry) = TLB_Lookup(VPN)
if (Success == True) // TLB Hit
    if (CanAccess(TlbEntry.ProtectBits) == True)
        Offset = VirtualAddress & OFFSET_MASK
        PhysAddr = (TlbEntry.PFN << SHIFT) | Offset
        Register = AccessMemory(PhysAddr)
    else
        RaiseException(PROTECTION_FAULT)
else // TLB Miss
    PTEAddr = PTBR + (VPN * sizeof(PTE))
    PTE = AccessMemory(PTEAddr)
    if (PTE.Valid == False)
        RaiseException(SEGMENTATION_FAULT)
    else if (CanAccess(PTE.ProtectBits) == False)
        RaiseException(PROTECTION_FAULT)
    else
        TLB_Insert(VPN, PTE.PFN, PTE.ProtectBits)
        RetryInstruction()
TLB의 hit / miss에 따라, 즉 TLB의 성능에 따라 추가적인 memory 접근이 발생 여부가 달라진다. 따라서, TLB의 성능이 매우 중요하게 된다.
TLB
TLB을 사용한다고 했을 때의 예시를 보자. 10개의 4 byte integer가 든 list가 있다고 하고 virtual address space에서 시작 주소가 100이라고 해보자.
Virtual address space가 8 bit이고 page가 16 byte으로 구성된다고 할 때, virtual space의 크기는 $2^8 = 256$ byte 이기에 총 page 수는 16이다. 그리고 각 page에 4개의 integer가 저장될 수 있다.
그럼 virtual address space는 이 그림처럼 표현된다.
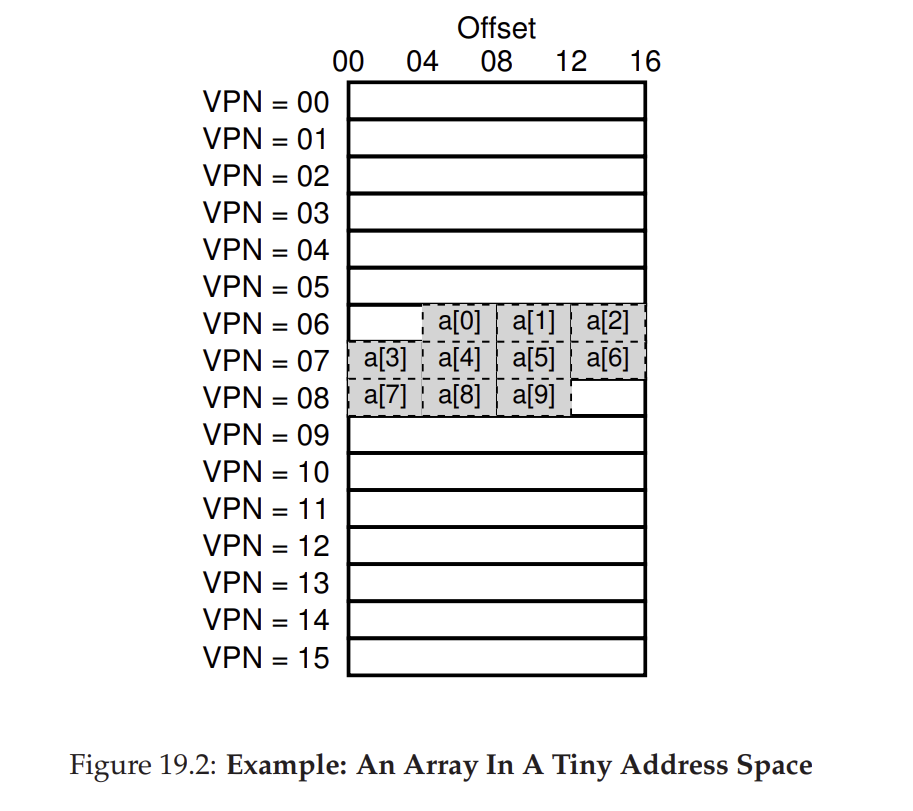
시작 address는 100 = 16*6 + 4 이기 때문에 VPN = 6 page에서 두 번째부터 시작한다. 이 상황에서 list의 각 element에 접근하는 loop가 있다고 하자.
int sum = 0;
for (i = 0; i < 10; i++) {
    sum += a[i];
}
a[0]에 접근했다고 하자. 처음 접근하기 때문에 TLB에는 VPN = 6에 해당하는 PFN이 저장되어 있지 않을 것이다. 그래서 miss가 나고 TLB에는 VPN = 6에 해당하는 PFN이 저장된다. 그럼 a[1], a[2]에 접근할 때는 동일하게 VPN = 6이기에 TLB hit이 난다.
a[3]에 이제 접근하게 되면, TLB에는 VPN = 7에 대한 정보가 없기에 다시 miss가 난다. 하지만 a[4][ a[5], a[6]은 TLB hit이 날 것이다.
모든 경우를 차례대로 확인하면 miss, hit, hit, miss, hit, hit, hit, miss, hit, hit $\rightarrow$ hit rate이 70%가 된다. 이런 높은 rate이 나오는 이유는 spatial locality 때문이다. Page size가 컸다면 더 많은 VPN이 겹쳤을 것이기에 hit rate은 더 높았을 것이다.
이 loop을 한번 더 하게 되면 TLB는 각 VPN에 대한 정보를 이미 갖고있기에 hit만 나올 것이다. 이런 이유는 temporal locality이다. 즉, TLB는 spatial과 temporal locality을 바탕으로 성능이 나온다.
정리하자면 TLB을 사용하면 address translation으로 인해 생기는 속도 저하 문제는 해결할 수 있다.
TLB Miss Handling
그러면 TLB miss는 누가 처리할까?
이전에는 TLB miss을 hardware가 처리했다. Hardware managed TLB가 성공하기 위해서 hardware는 page table이 page tabke base register (PTBR)으로 메모리 어디에 존재하는지 정확히 기억했어야 했다. Page miss가 나면, hardware는 page table에서 정보를 가져와서 TLB에 기록을 하고 miss가 난 instruction을 다시 시도하였다.
최근에는 OS가 handle하는 software managed TLB가 사용된다. TLB miss가 나면 hardware는 exception만 발생시키고 OS가 그 trap에 해당되는 trap handler을 통해 문제를 해결한다.
더 자세히 설명하자면 exception이 발생하면 kernel mode으로 들어가 trap handler을 실행하고 page table 정보를 바탕으로 TLB을 update 한 뒤 return from trap을 한다.
이때, return from trap은 이전과 다르다. System call에서는 return from trap이 그 다음 instruction으로 갔지만, 이 exception에서는 exception을 일으킨 instruction으로 돌아가서 그 instruction을 다시 실행해서 TLB hit을 발생하도록 한다. 즉, trap / exception 종류에 따라 hardware는 다른 PC 값을 저장해야 한다.
TLB Issue: Context Switch
TLB에는 해당 process에 대한 virtual-physical translation이 존재하기에 process가 변하면 TLB에 존재하는 정보는 의미가 없어진다. 따라서, TLB에는 다음에 실행될 process에 대한 translation 정보를 가지고 있지 않으면 이전 process의 translation 주소로 접근할 수 있게 된다.
이 문제에 대한 예시를 들자면 Process P1에서 10 VPN이 100 PFN에 대응된다고 해보자. 그리고 다음에 실행될 process P2에서는 10 VPN이 170 PFN에 대응된다고 해보자. Context switch가 일어날 때 이전 process P1에 대한 정보를 처리하지 않게 되면 TLB에는 다음 translation 정보가 담기게 된다.
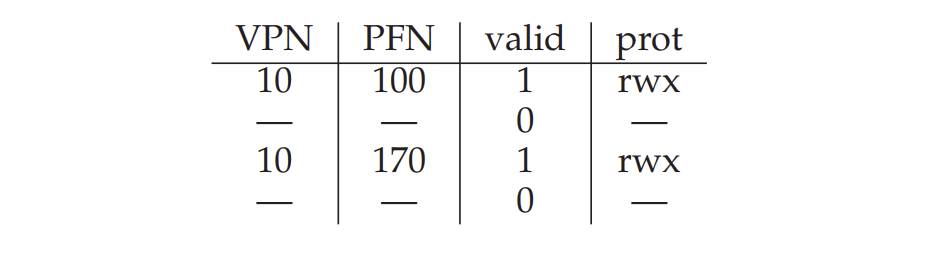
즉, VPN 10에 대응되는 PFN이 두 개가 되고 hardware는 이들을 구별할 수 없게 된다.
이 문제를 해결하기 위해 flush을 사용할 수 있다. Context switch가 일어날 때마다 TLB을 다 비우는 것이다. 그러면 헷갈릴 이유가 없어지기는 한다. 하지만 새로운 process을 실행할 때마다 TLB miss가 많이 일어난다는 것과 context switch가 자주 일어나게 되면 더 많은 miss에 시달려야 한다. (쌓아온 TLB 정보가 없어지므로)
이런 문제를 해결하기 위해 address space identifier (ASID)을 사용할 수 있다. 이는 그저 process을 구별할 수 있도록 추가 정보를 TLB에 저장하는 것이다.
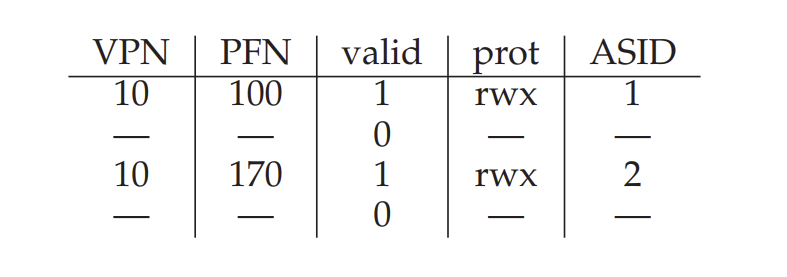
VPN이 다른데 동일한 PFN과 대응되어야 할 때도 있다. 이런 상황은 두 process가 동일한 code 정보를 공유할 때 생길 수 있다.
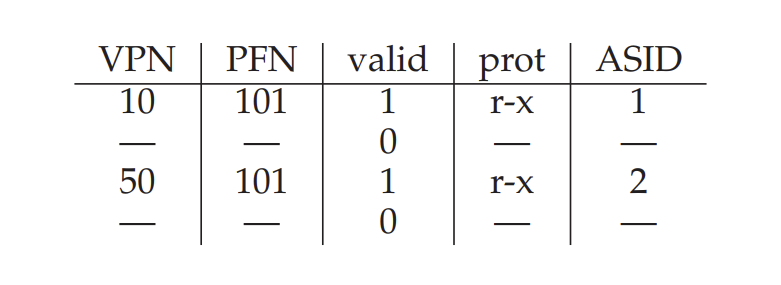
이때는 문제가 발생하지 않는다.
Replacement Policy
TLB을 사용할 때 더 고려해야 하는 것은 cache replacement이다. TLB에 새로운 entry을 저장해야 하는데 이미 꽉 차있다면 어떤 것을 바꿔야 할까? 지금은 제일 기본적인 것만 알아보자
1) LRU: Least recently used
LRU는 locality 개념을 이용해서 최근에 사용되지 않은 entry는 나중에도 사용되지 않을 것이라는 가정 하에 이 entry을 없애는 policy이다.
2) Random
Random은 말 그래도 random하게 제거하는 것이다.