기학원 Week 6 Naive Bayesian 정리
Prabability RECAP
Probabilistic Independence
$P(A, B) = P(A)P(B)$와 $P(A \mid B) = P(A \mid \neg B) = P(A)$ 중 하나를 무조건 만족할 때 두 사건 A,B가 독립적이라고 정의한다.
Bayesian Rule
\[P(A \mid B) = \frac{P(A, B)}{P(B)} = \frac{P(B \mid A) P(A)}{P(B)}\]Conditional Probability on Independence and Bayesian Rule
C가 주어졌을 때, A와 B가 독립적일 조건
- $P(A, B \mid C) = P(A \mid C) P(B \mid C)$
- $P(A \mid B, C) = P(A \mid \neg B, C) = P(A \mid C)$
C가 주어졌을 때, Bayesian rule
\[P(A \mid B, C) = \frac{P(A, B \mid C)}{P(B \mid C)} = \frac{P(B \mid A, C) P(A \mid C)}{P(B \mid C)}\]Naive Bayesian Classifier
예를 들어 outlook, temperature, humidity, wind에 따라 tennis을 했는지 여부에 대한 data가 있다고 해보자
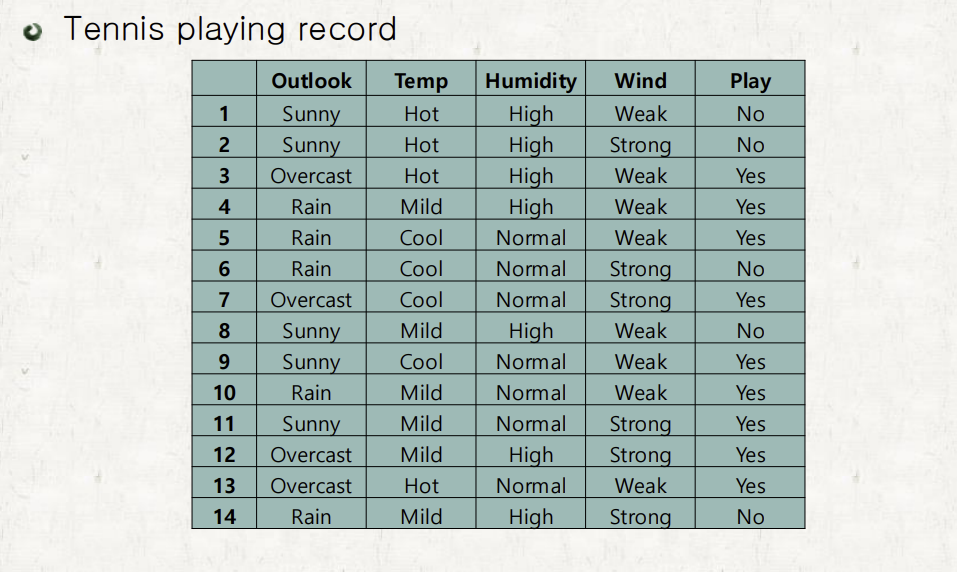
이 data을 가지고 각 attribute가 sunny, mild, high, strong일 때 tennis을 할 지 여부를 어떻게 예측할 수 있을까?
sunny, mild, high, strong일 때, yes였던 경우의 수 P(yes $\mid$ sunny, mild, high, strong)와 sunny, mild, high, strong일 때, no였던 경우의 수 P(no $\mid$ sunny, mild, high, strong)을 비교하면 된다.
정확한 예측값을 알아내기 위해서는 sunny, mild, high, strong일 때에 대한 data을 많이 얻어야 한다. 하지만, 이 확률값을 평가할 방법은 딱히 없다. 또, 얼마만큼의 data가 충분한 지 알 수가 없다. 즉, incomplete statistics으로 인한 문제인 것이다.
$\rightarrow$ 이런 경우에 Naive Bayesian Classifier을 사용할 수 있다.
Naive Bayesian Classifier 가정
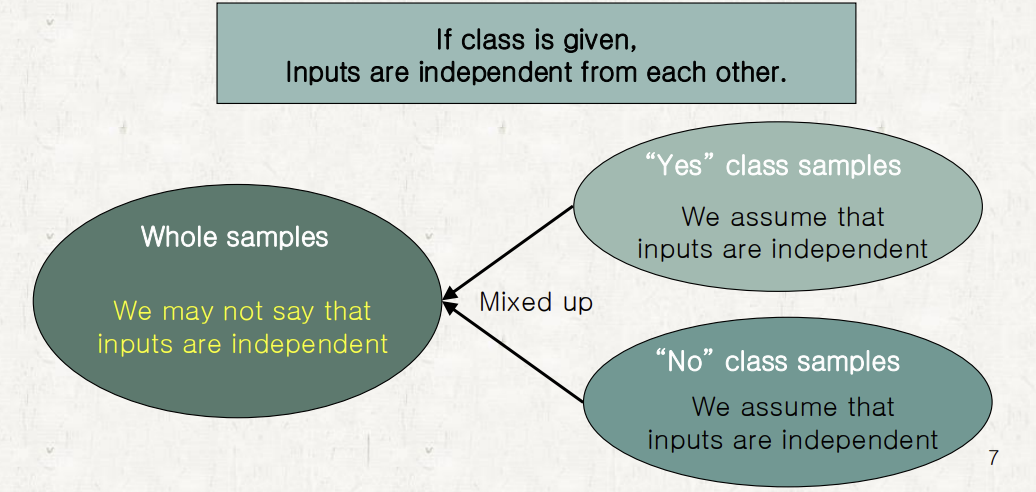
Naive Bayesian Classifier가 적용되기 위해서는 하나의 가정을 전제로 해야 한다.
If class is given, Inputs are independent from each other
즉, class가 주어졌을 때, 각 column 값이 서로 독립적이라는 것을 전제로 해야 한다는 것이다.
Naive Bayesian Classifier 적용
Naive Bayesian에서 그럼 P(yes $\mid$ sunny, mild, high, strong)와 P(no $\mid$ sunny, mild, high, strong)는 어떻게 구하는 것일까?
가정을 전제로 한 Bayesian rule을 적용하는 것이다.
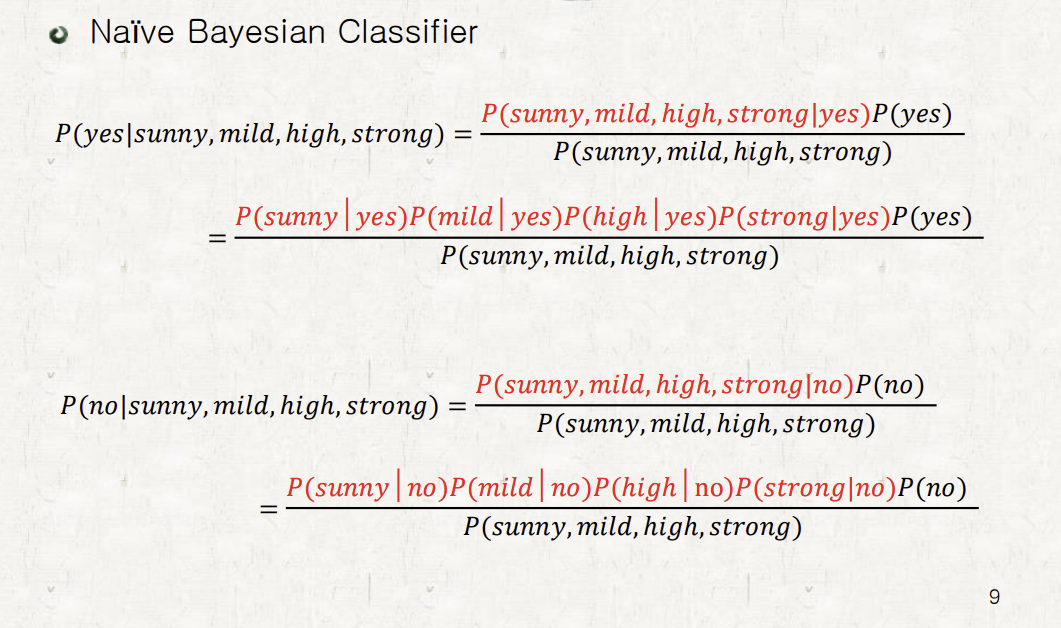
class가 주어졌을 때, 각 attribute는 독립적이기에 분자가 분리가 될 수 있는 것이다.
이때, 분모에서는 class가 안 주어졌기 때문에 독립적이지 않다. 따라서 구할 수 없는 값이다.
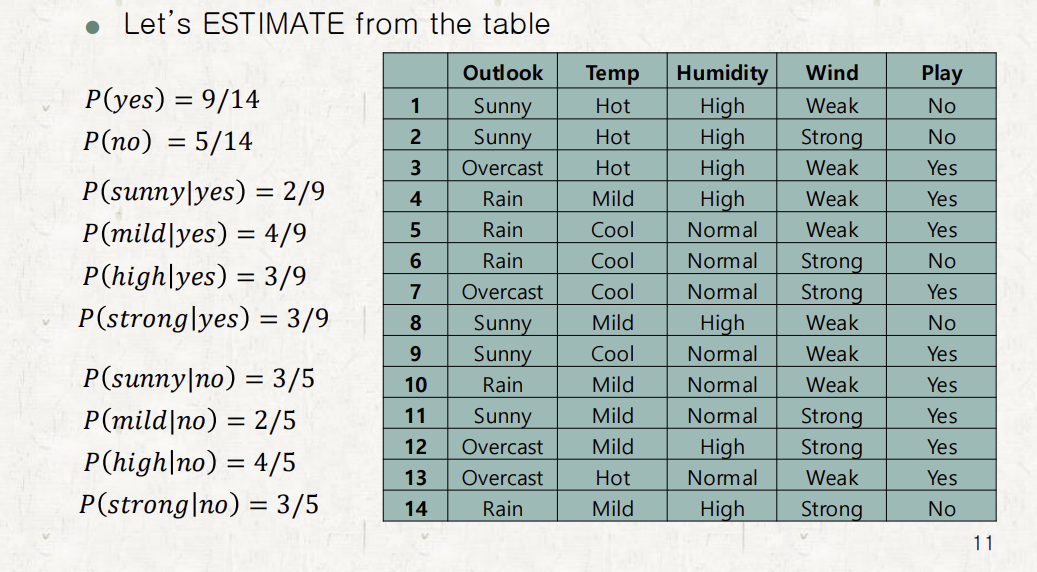
Independence으로 분리된 분자의 각 확률값들은 data을 통해 estimation을 구할 수 있다.
Naive Bayesian Classifier in Different Domains
실수 domain
이때, attribute 값이 실수인 domain일 때는 어떻게 될까? 예를 들어 A,B,C이면서 온도가 36.7도일 사건은 엄청 희귀하기 때문에 P(A,B,C,temp = 36.7 $\mid$ Yes) 값이 계속 0이 될 수가 있다. 분자의 한 확률값이 0이 된다면, 정당한 예측을 할 수 없게 된다.
이런 경우에는 실수 attribute을 어떻게 처리해야 할까?
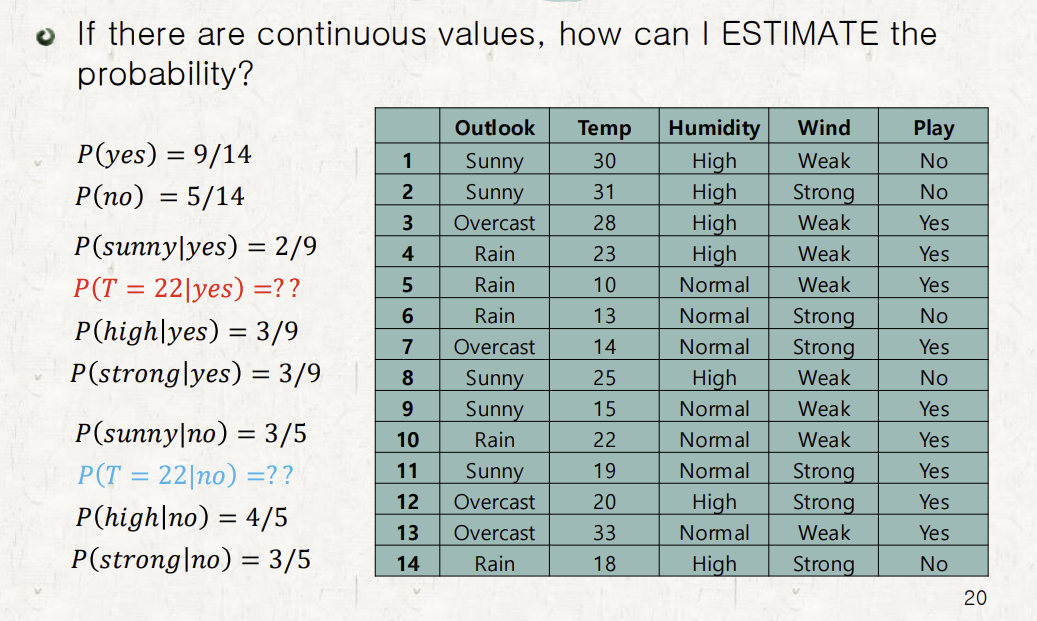
이 경우에 Naive Bayes Classifier는 class가 주어졌을 때 실수 attribute가 Gaussian Distribution을 따른다고 가정한다.
P(temp = t $\mid$ yes)을 구하기 위해서는
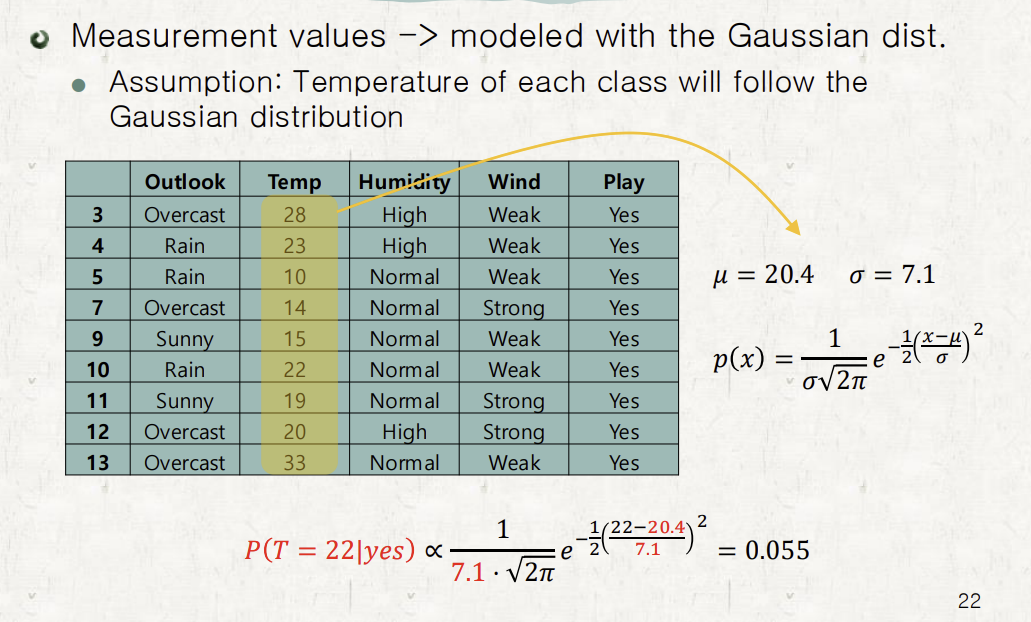
Yes가 주어졌을 때의 data에서 Temp attribute의 평균과 표준편차를 계산한 다음 Gaussian distribution 함수에 t을 대입하는 것이다.
Count domain
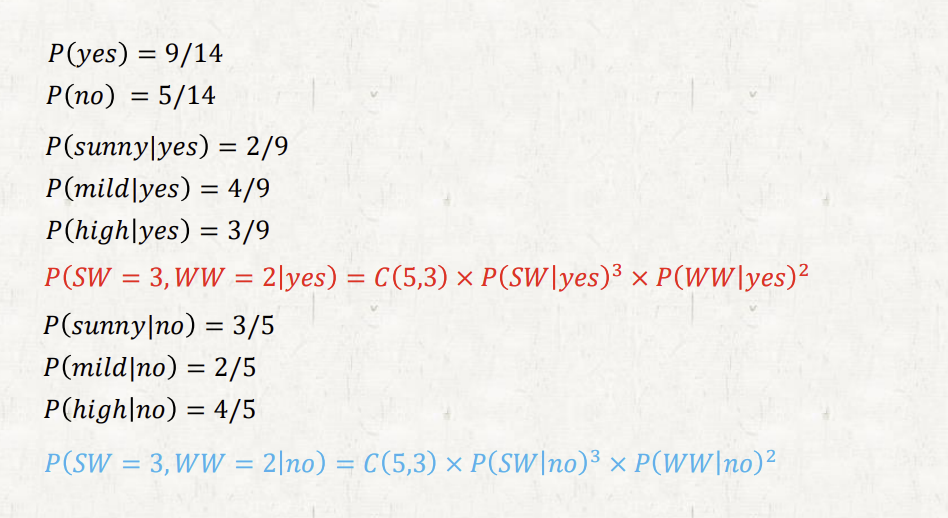
Attribute 값이 count based (정수)일 때도 마찬가지이다. 예를 들어 A,B 이면서 강한 바람은 3번, 약한 바람은 2번일 사건은 엄청 희귀하기 때문에 P(A,B,SW=4, WW = 2)의 값이 0이 될 수가 있다.
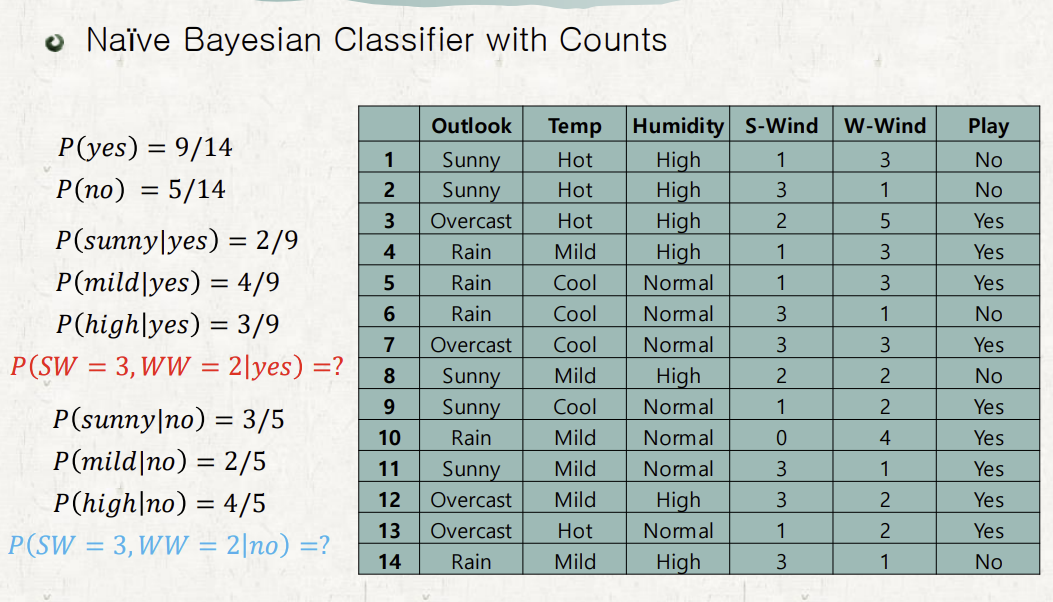
이 경우에 Naive Bayes Classifier는 class가 주어졌을 때 Count attribute가 Multinomial Distribution을 따른다고 가정한다.
P(SW = t, WW = k $\mid$ yes)을 구하기 위해서는
- P(SW $\mid$ Yes)와 P(WW $\mid$ Yes), P(SW $\mid$ No)와 P(WW $\mid$ No)의 estimation을 구한 다음
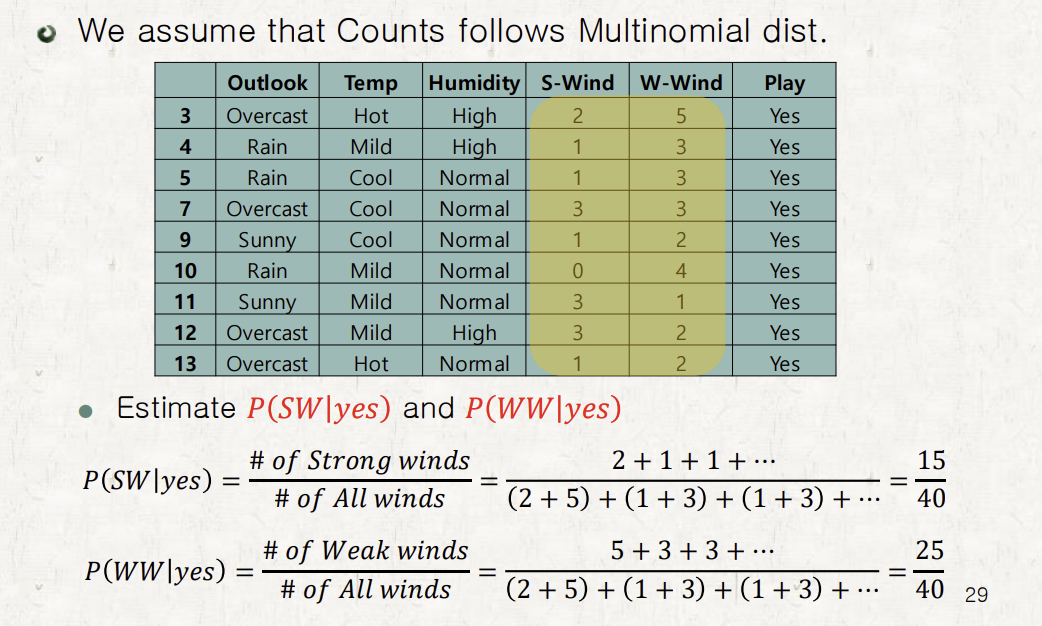
- Multinomial distribution을 따른다고 가정하는 것이다.
Smoothing: Naive Bayesian Classifier의 overfitting 방지 방법
그런데 만약에 data가 부족해서 p(A $\mid$ yes) = 0 또는 P(A $\mid$ no) = 0이 되면 어떻게 될까?
Data 부족으로 인해 yes였던 경우의 수 P(yes $\mid$ sunny, mild, high, strong)와 sunny, mild, high, strong일 때와 no였던 경우의 수 P(no $\mid$ sunny, mild, high, strong)을 정당하게 비교할 수 없게 된다.
즉, Classifier가 data에 너무 민감해져 overfitting이 되는 것이다.
이 overfitting을 막기 위해 사용되는 방법이 Smoothing이다.
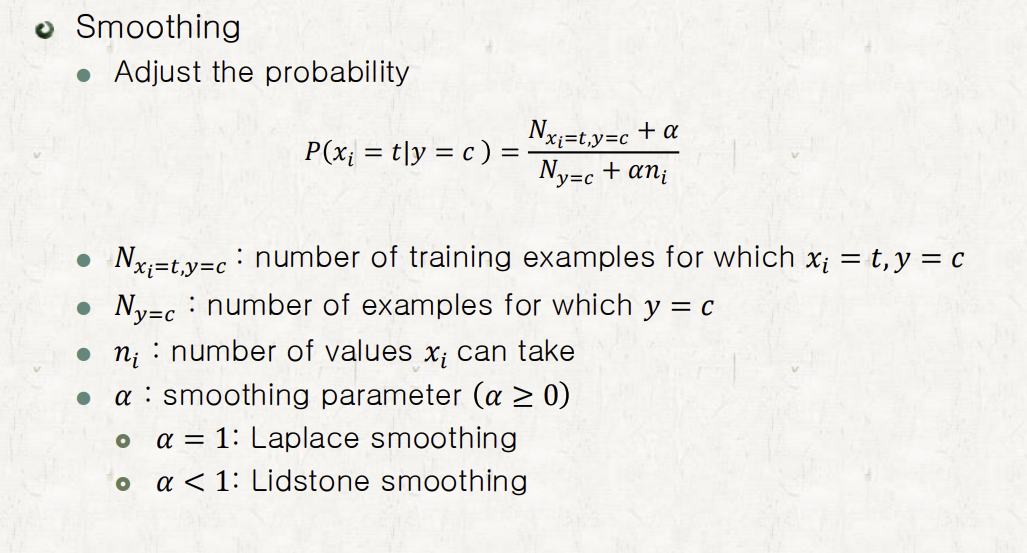
이때, $\alpha n_i$와 $\alpha$ 값은 해결하는 문제의 domain에 대한 전문적인 지식으로 설정하는 것이다.
$\alpha$의 값에 따라 naive bayes classifier가 overfitting이 될수도, underfitting이 될 수도 있다. 만약에 $\alpha$ 의 값이 너무 크게 된다면 모든 확률값 $P(A \mid class)$가 $\frac {\alpha} {\alpha N_i}$ 의 값을 갖게 되므로 data에 너무 둔감해진다. 즉, high bias low variance을 가진다.
반면 $\alpha$의 값이 너무 작아진다면, data에 너무 민감해져 overfitting 되며 low bias, high variance을 갖게 된다.
적용 상황 / 분야
-
Data가 엄청 많거나, Attribute들이 실제로 conditionally independent 할 때
-
Classifying text documents