Vis6
Marks and Channels
Visual encoding은 mark와 channel로 정의된다.
Mark는 item이나 link을 표현하는 geometric element이고 channel은 mark의 생김새를 나타내는 element이다.
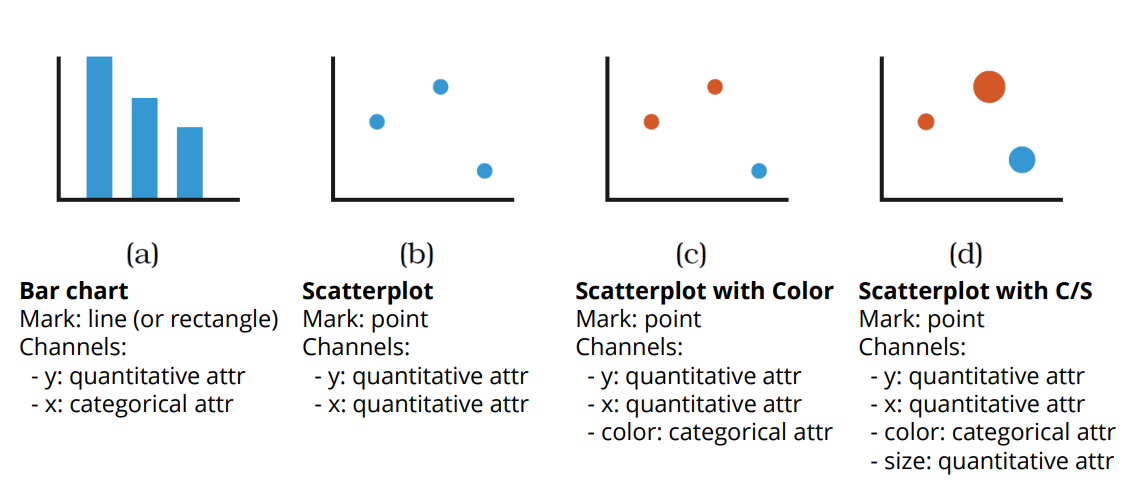
Marks
Mark는 요구하는 spatial dimension으로 분류가 가능하다.
- 0D: point
- 1D: line
- 2D: area
- 3D: volume
Mark가 link으로 표현될 때는 containment와 connection으로 나뉜다.
Channels
Channel은 mark의 appearance을 나타내고 종류는 다음과 같다.
- Position: Horizontal, Vertical, Both
- Color
- Shape
- Tilt
- Size: Length, Area, Volume
더 많은 data을 여러 visual channel으로 encoding할 수 있지만 effectiveness가 떨어질 수 있다.
하지만 동일한 data을 여러 channel을 사용해서 encoding 하면 좋은 효과를 볼 수 있다. 이 방법을 Redundant Encoding이라고 부른다
Channel의 Type은 역할에 따라 Magnitude와 Identity으로 나뉜다. Magnitude는 how much을 encoding하고 identity는 what/where을 encoding한다고 보면 된다.
따라서 magnitude는 ordered data (Quantative and Ordinal) 에 필요하고 identity는 categorical data에 필요하다.
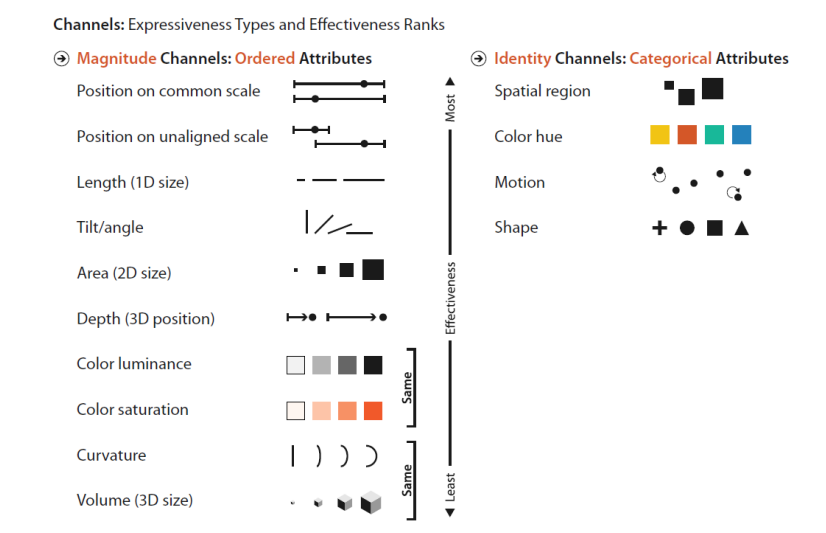
Magnitude Channel
Ordered Attributes
- Position Channel
- ex) X,Y positions
- Size Channel
- Length
- Area
- Volume 순서로 효과적이다
- Orientation
- Magnitude 정보를 mark의 orientation으로 encoding한다.
- Tilt: absolute
- Angle: relative
- Curvature
- bin 수도 적고 명확하지 않음
Identity Channel
- Shape
- Motion
- Attention은 많이 받을 수 있음. 따라서 highlighting에 사용된다
Texture: Small scale pattern에 적용되고 magnitude와 identity 둘 다 적용 가능하다 Identity에서는 10~20 bins, magnitude에서는 3~4 bins으로 구분 가능하다
Channels 선정 방법
여러 channel 중에서 expressiveness와 effectiveness을 기준으로 골라야 한다.
Expressiveness는 visual encoding이 오직 dataset attribute의 정보만 표현해야 한다.
Effectiveness는 데이터의 중요도와 Channel의 시각적 효과를 일치시켜야 한다.
하지만 effectiveness에는 여러 criteria가 존재한다.
- Accuracy (Value을 얼마나 정확하게 읽어낼 수 있는가)
- 전체적인 Accuracty 수학적으로 표현하는 방법이 Stevens’s Power Law이다.
\(S = I^n\) S: perceived sensation I: physical intensity n=1에 가까울수록 effective 하다고 말한다
- Discriminability (데이터들을 다르게 얼만큼 표현할 수 있는가)
- Visual channel이 가능한 number of bins으로 결정된다.
- Separability (여러 channel을 사용할 때 Channel이 뚜렷하게 섞여 쓰일 수 있는가)
- Visual popout
- Preattentive processing : 반응속도 빠르게 인식됨
- 하나의 visual channel에 대해서 대부분 발생함
- Perceptual groupings
- 사람은 object나 pattern을 인식할 때 다음 요소를 통해 하나의 그룹으로 인식하게 된다
- Proximity: 가까움의 정도
- Similarity: 유사한 정도
- Connectedness: 연결된 정도
- Continuity
- Symmetry: 대칭적인 정도
전체적인 Accuracty 수학적으로 표현하는 방법이 Stevens’s Power Law이다.
\(S = I^n\) S: perceived sensation I: physical intensity n=1에 가까울수록 effective 하다고 말한다
Color
- Pros
- Preattentive processing: 빨리 인식하는 특징을 가졌고
- Ordinal / Nominal data 표현에 Accuracy가 높다
- Cons
- 상대적인 성질을 지니고 있고 색맹/색약을 고려해야 한다.
색은 사람이 인식하는 것과 빛 자체가 가진 물리적인 특성으로 정의된 색과 다르다. 단일 frequency / 파장을 가진 빛은 단색광인데 실제로 사람이 인식하는 색은 여러 파장이 혼합된 색이다.
사람은 retina을 통해서 빛을 받아들이고 rod cell과 cone cell으로 인해 색으로 변하는 과정을 거친다.
Rods cell은 low light setting에 활성화되며 low resoluation black / white을 인식한다. 100 million receptors을 가진다
반면 cones cell은 색을 인식하는 역할을 하여 normal lighting condition에 활성화되며 세 가지로 이루어져있다. 6 million receptors만 있으며 center of vision (fovea)에 dense하다
Cone cells은 Long, Middle, Short으로 나뉘며 인식하는 파장에 따라 나뉜다.
- Long: Red, 63%
- Middle: Green, 31%
- Short: Blue, 6%
따라서 파란색을 잘 인식하지 못한다.
정리하면 사람은 복잡한 빛을 세 종류의 cone의 반응값 (tristimulus value)으로 압축한 뒤에 인식한다. 이를 Trichromacy라고 한다. 따라서 다른 spectra이더라도 동일한 tristimulus value을 가지면 사람은 동일한 색으로 인식하게 된다는 것이다.
그러면 세 개의 primary light을 혼합해서 사람이 인식하는 색을 모두 표현할 수 있을까?
RGB의 파장 강도를 조절하면서 색의 조합을 여러개 한 결과, 일부 primary light의 강도를 음수로 둬야 사람이 인식하는 색을 표현할 수 있다는 실험 결과가 나왔다. 즉, 세 primary의 양수 조합만으로 사람이 인식하는 색을 표현할 수 없었다.
이걸 보여주는게 rg Chromaticity Diagram이다. 색 표현 시스템이 표현 가능한 사람이 인식하는 색은 직각삼각형 안의 범위의 색이다. 이를 gammut이라고 한다. 하지만 gammut 만으로 사람이 인식하는 모든 색을 표현할 수는 없다.
CIEXYZ Color Space는 사람이 볼 수 있는 색을 음수가 아닌 값으로 나타낼 수 있도록 설계된 표준 색 표현 체계이다.
sRGB는 사람이 볼 수 있는 전체 색 영역을 표현하지 못함
RGB는 세 숫자로 색을 표현하는데 RGB 값만으로 사람이 색을 직관적으로 조절하는데에는 불편하다. 이를 해결하기 위해 HSL이 도입된다.
HSL Color Space는 색 표현을 세 가지 속성으로 한다
- Hue
- 색상 종류
- Lightness
- 밝기
- 검은색이 얼마나 섞였나
- Saturation
- 채도 (색의 선명함)
- 하얀색이 얼마나 섞였나
하지만 Lightness가 같더라도 사람이 느끼는 lightness는 다를 수 있기에 pseudoperceptual이라고 표현한다. (Blue랑 Yellow는 lightness 값은 동일하더라도 지각하는 밝기는 노랑색이 더 밝아보임)
이를 해결하기 위해 CIELAB 이 도입된다. 사람의 color의 lightness 인식을 고려하여 정의된 표준 색 표현 방법이다.
세 축을 사용한다.
- L* = 인식되는 lightness
- a* = green - red
- b* = blue - yellow
a* 와 b* 는 opponent color model of human vision으로 결정된 것이다. 인간의 색 지각이 세 가지 대립쌍으로 구성된다는 Opponent Process Theory 기반이다.
이 대립쌍은 Black vs white, Green vs red, Yellow vs blue이다
Luminance(밝기) + Chroma (색상 차이)가 Color image을 표현한다. a* 와 b* 는 black - white (luminance) 정보에 비해 적은 정보를 담고 있다.
Color deficiency는 일부 cone 기능이 결핍된 것이다. Long 또는 Middle의 영향이 없어진다
Color Encoding 단어들 중에서 Luminance, Brightness, Lightness는 구분된다.
- Luminance: Physical light의 양. 단위로 표현 가능
- Brightness: 인식되는 light의 양, self luminous한 대상 한정
- Lightness: 표면에서 반사되는 light의 양
Stevens Power Law가 적용된다.
\[\text{Perceived Brightness} = \text{Luminance} ^ n\]Lightness Constancy : 조명 환경이 달라져도 물체 표면의 밝기를 어느 정도 일정하게 인식하는 현상
정보시각화 관점에서는 Luminance, hue, saturation을 사용해서 색을 표현하는데 이때의 luminance는 아까 말한 physical light가 아니라 black - white channel을 의미한다.
Computer에서 색을 표현하기 위해서는 RGB 값을 사용해야 한다.
Nominal data는 Hue을 사용하고 순서가 있는 ordinal이나 quantative data는 luminance 또는 saturation을 사용해야 한다.
즉, Hue는 순서 정보가 들어있지 않기 때문에 category / nominal 을 표현하는데 좋다.
Luminance와 Saturation은 순서 정보는 들어있지만 구별하는 정보로 사용되기에는 한계가 존재하다. Luminance는 배경이 불균일할 때 비교가 어렵고 Saturation은 bin 의 수가 적다.
Transparency는 color을 표현할 수 있는 4th channel이다. Luminance와 saturation에 영향을 준다.
Color map은 데이터값을 색으로 변환하는 규칙이다. 예를 들어 categorical에서는 hue을 사용하고 (두 개의 category만 존재할 경우에는 hue을 사용하지 않아도 된다) ordered에서는 sequential인 경우 min -> max으로 정의하고 diverging의 경우 두 hue의 end point을 사용한다.
Categorical의 경우 뚜렷하게 구분 가능한 색은 많이 없기 때문에 bin 수가 적다. 또, luminance, mark type (Area가 작을 때는 low saturation, 즉 색이 뚜렷해야 한다.), color deficiency, printing을 고려해야 한다.
Bivariate Colormap은 서로 다른 attribute을 동시에 encoding할 수 있다.