VLM4VLA: REVISITING VISION-LANGUAGEMODELS IN VISION-LANGUAGE-ACTION MODELS 리뷰
Background
VLA는 VLM의 visual-language 지식을 사용해서 robotics generalization에 사용한다. 그렇다면 VLA에 사용되는 VLM은 어떤 성격을 지녀야 robotics에 큰 효과를 보여줄 수 있을까?
VLM4VLA
본 논문은 여러 VLM들을 갈아끼우면서 안정적으로 학습하기 위해서 action expert을 모두 단순한 MLP decoder로 설정하고 L1/L2 loss을 학습 objective으로 둔다. 특정 데이터에 대해 학습을 할 때도 동일한 설정을 유지한다. 이런 pipeline을 VLM4VLA라고 한다. Action expert을 간단하게 설정함으로써 VLM을 downstream robot data으로 더 직접적으로 학습할 수 있게 하고 VLM의 특징이 VLA에 얼만큼의 영향을 주는지 직관적으로 이해할 수 있게 된다.
VLM4VLA Design
다양한 VLM을 사용하더라도 general하게 사용 가능하게 하는 VLA 구조는 다음과 같다.
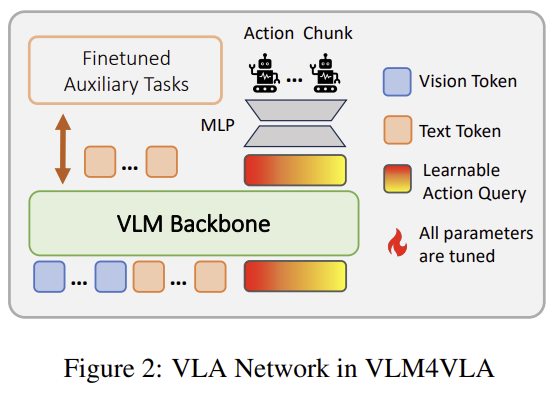
VLM에서 행동 예측에 필요한 정보를 action query라고 한다. 이 action query을 학습 가능하게 만들고 action query가 visual / language representaton들과 attention이 되도록 하고 이 action query을 바탕으로 행동이 decode되게 하였다.
\[\text{action = MLP(VLM([⟨img⟩. . .⟨img⟩⟨text⟩. . .⟨text⟩⟨ActionQuery⟩⟩]))}\]img는 vision endoer의 embedding, text는 language encoder의 embedding이다
VLM4VLA Training Objective
학습을 할 때는 VLM의 모든 부분 (LLM, Vision Encoder, Word embedding)을 학습한다. Action expert을 학습할 때는 diffusion/flow matching loss을 사용하지 않는다. 이런 loss들은 checkpoint마다 성능이 다르고 정확한 평가를 하기 위해서는 많은 rollout을 해야 하기 때문이다.
따라서, end effector의 desired 상대적 위치 $a^{\text{pos}}$ 는 maximum likelihood imitation learning으로 action expert을 학습한다.
\[\mathcal{L} = \frac{1}{|\mathcal{B}|} \sum_{b \in \mathcal{B}} ( \|a_{\mathrm{pos}}-\hat{a}_{\mathrm{pos}}\|_2^2 + \mathrm{BCE}(a_{\mathrm{end}},\hat{a}_{\mathrm{end}}) )\]$\hat{a}{\mathrm{end}}$ 와 $\hat{a}{\mathrm{pos}}$ 는 demonstration data에서의 상대적 위치 정보이다.
Experiments
이 pipeline을 통해 24개의 VLM의 능력을 세 가지 관점에서 평가한다.
General capability
VLM pretraining (increased generalability)의 효과가 VLA의 embodied control 능력와 상관관계가 존재하는지 평가한다.
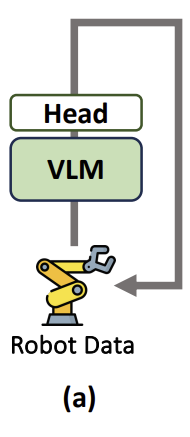
Pretrained된 VLM에서부터 시작하는 VLA와 Scratch VLM에서부터 시작하는 VLA 간에 비교를 한다.
VLM4VLA pipeline에 사용하는 pretrained된 VLM들은 paligemma-1, paligemma-2, Qwen2.5VL-3B, Qwen2.5VL-7B, Qwen3VL-2B, Qwen3VL-4B, Qwen3VL-8B, Qwen3VL-30B-A3B, Kosmos-2 이다. QwenVL 계열들이 generalibility가 가장 높고 paligemma는 downstream finetuning할 때 적응력이 높고, Kosmos는 grounding tasks에 좋은 특징을 가지고 있다.
Scratch VLM에서부터 시작하는 VLA들은 OpenVLA, $\pi_0$, ThinkAct이다.
다음은 Calvin benchmark에서 평가한 결과이다.
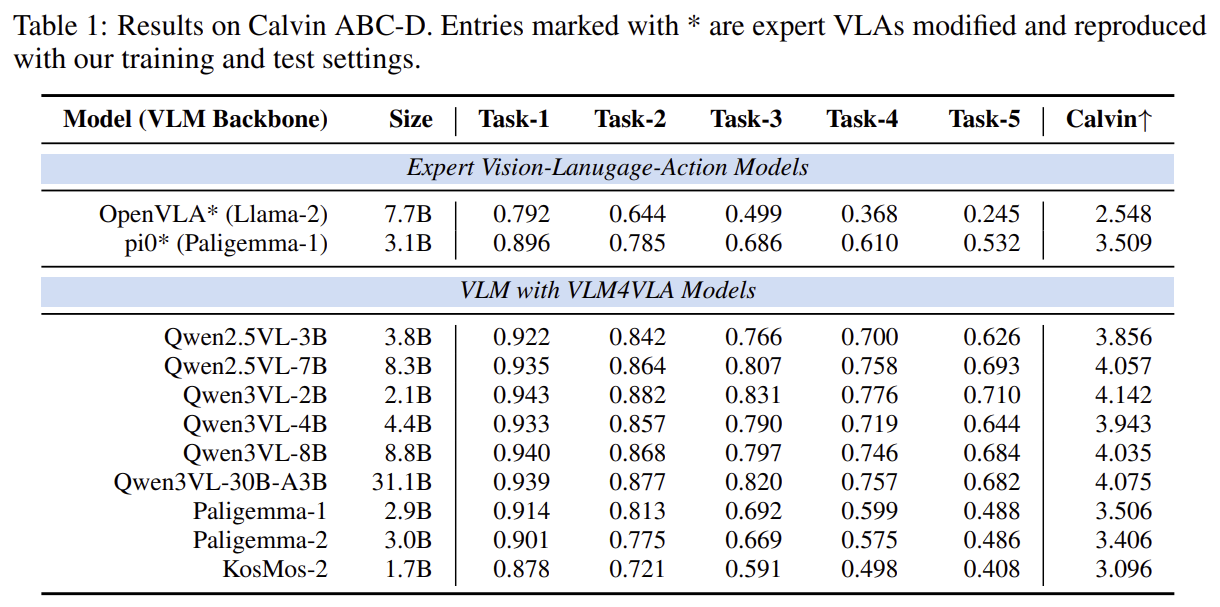
QwenVL 계열을 사용했을 때 Calvin ABC-D task에서 성능이 SoTA VLA 성능과 비슷했으며 VQA benchmark에 성능이 높은 VLM (특히 QwenVL)들이 Calvin에서 높은 성능을 갖는 경향이 존재한다.
또, Paligemma 기반 VLA인 $\pi_0$ 와 paligemma을 기반으로 하는 VLM4VLA 의 성능이 비슷하다는 것을 통해 diffusion/flow matching으로 학습이 되었더라도 action expert의 성능이 backbone으로 삼는 VLM의 능력에 많은 영향을 받는다는 것을 알 수 있다.
다음은 SimplerEnv-Bridge와 Libero_10에 대해서 평가한 결과이다.
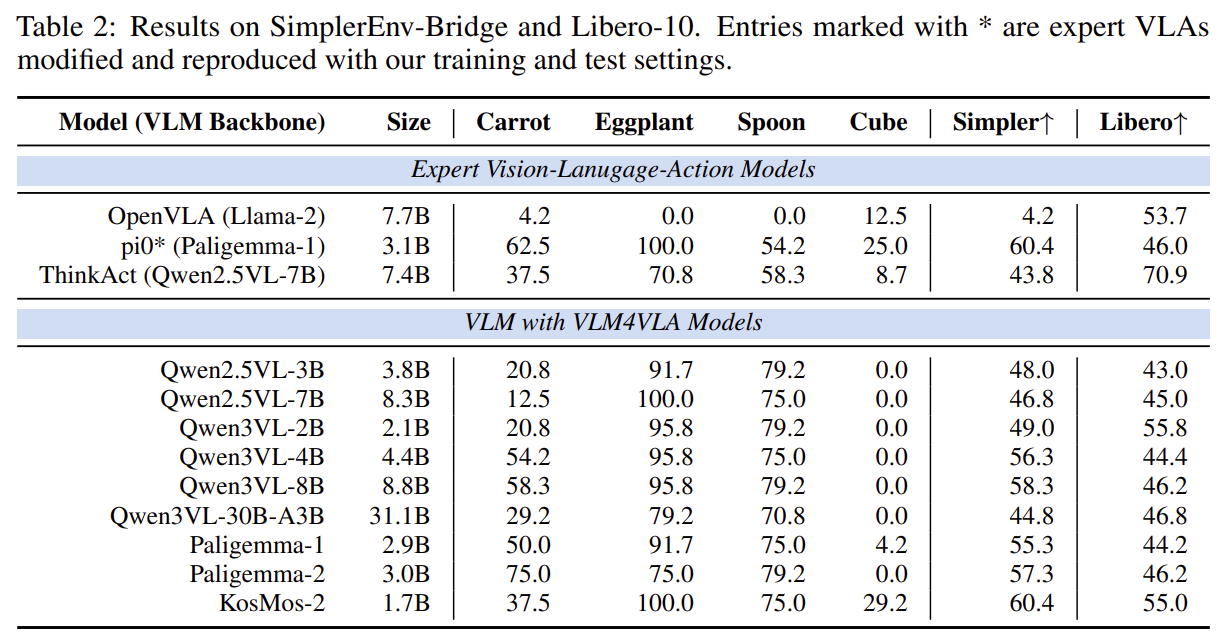
여기에서는 가장 작은 모델인 KosMos-2가 두 task에 대해서 성공률이 가장 높았다. 또, Simpler-Bridge task에서는 Paligemma 모델들이 Qwen2.5VL 모델들보다 성능이 더 좋았으며 Libero_10에서는 다 비슷하게 나왔다.
또, Qwen2.5VL-7B 기반으로 하는 ThinkAct는 Simpler-Bridge에서 Qwen2.5VL-7B와 성능이 비슷하면서 Libero_10에서는 그렇지 않다.
이건 아마도 ThinkAct가 사용하는 proprioceptive state 정보가 Libero10에서 효과적으로 사용될 수 있기 때문인 것 같다
VLA의 능력과 VLM의 generalibility의 relationship을 표현한 그림은 다음과 같다.
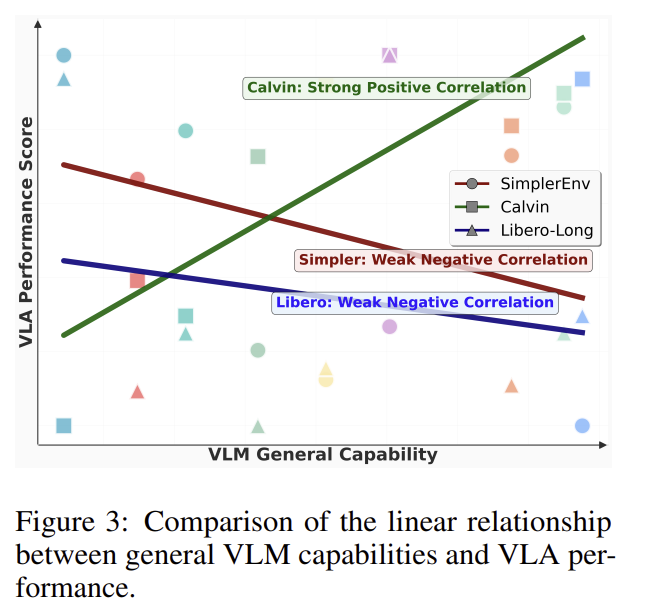
위 실험 결과들을 토대로 VLA low robot control 성능은 VLM의 generalability와 큰 영향이 없음을 알 수 있다.
Calvin에서는 generalability가 높을수록 성능이 좋았지만 libero10와 simpler bridge에서는 그렇지 않았기 때문이다
Embodied Specific Capability
VLA에서 VLM이 embodied-specific 능력 (spatial reasoning, robot 환경 특화 능력)을 가지면 성능이 더 좋아지는가를 알아본다.
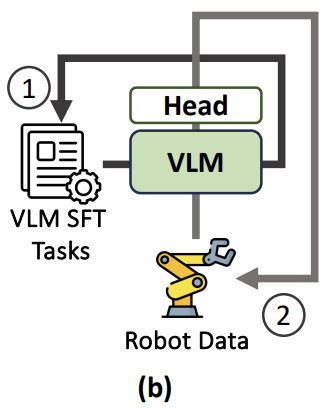
최근 연구들은 VLM이 embodied specific 능력을 가지도록 robotic data로부터 VQA dataset (gripper로부터 특정 물건이 얼마나 멀리 있는가 등) 을 구성하고 VLM에게 학습시킨다. 하지만 VLM이 이 dataset으로부터 실제로 얼마나 이점을 얻는지에 대해서는 연구가 존재하지 않는다.
따라서 본 논문은 Qwen 2.5-VL 계열 VLM들을 7가지의 embodied task에 대해 각각 finetune하여 사용하여 평가하여 embodied task에 대해서 학습을 하는 것의 효과를 알아본다.
사용하는 데이터셋들은 이미지와 목표지점이 있을 때 모델이 목표지점의 2D 좌표를 출력하도록 하는 task, RGB-D dataset으로부터 공간적 이해를 학습할 수 있게 하는 task (크기 예측, 위치 이해, 거리 예측 등), 두 물체 간의 거리, 크기 등을 예측하도록 하는 공간적 이해 QA task, 실제 robot trajectory로부터 multi view 이해, 성공 여부 예측, 위치 파악 등에 대한 task이다.
다음은 다양한 embodied specfic dataset에 대해서 하나씩 학습한 모델들을 다양한 embodied specfic dataset들을 다 섞어서 평가한 결과이다.
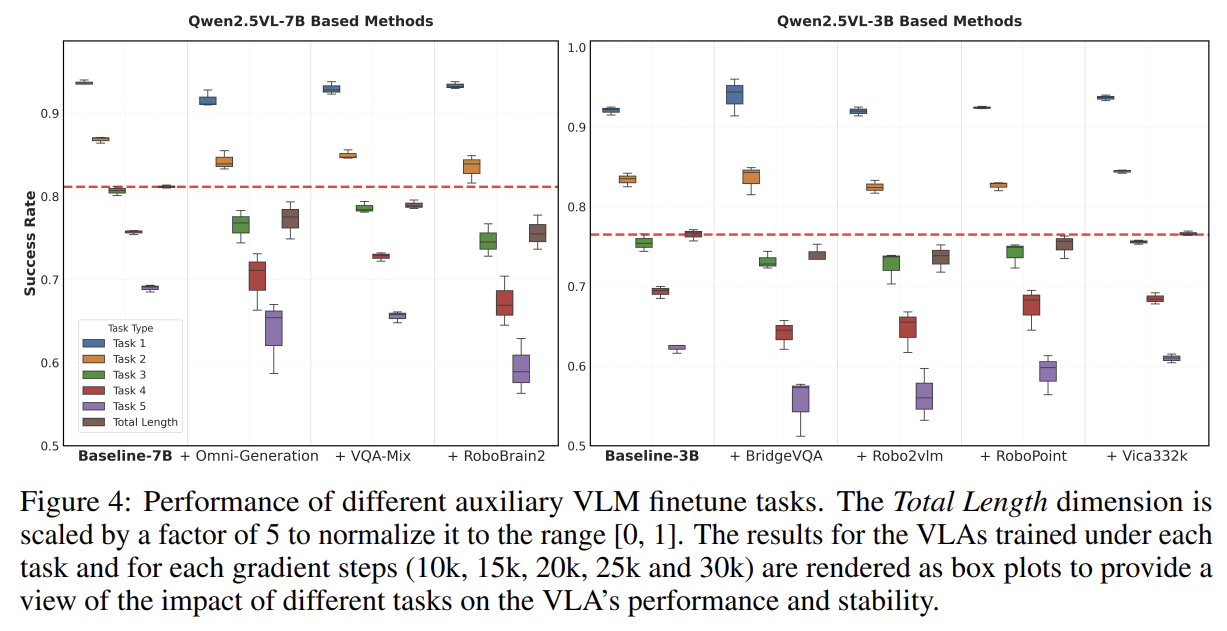
Vica332k (그나마 general한 data)에 대해서 학습된 Qwen2.5VL-3B 모델이 다른 모델들보다 더 좋은 성능을 보이고 VQA-mix으로 학습된 모델들이 가장 적은 성능 저하를 보인다는 것을 토대로 VLM에게 general한 VQA 데이터를 학습시키는 것은 중요하다라는 것을 알 수 있다.
Modality-level Analysis
Vision과 Language encoder 중에서 VLA 성능 향상에 어떤게 가장 큰 영향을 주는지를 알아본다.
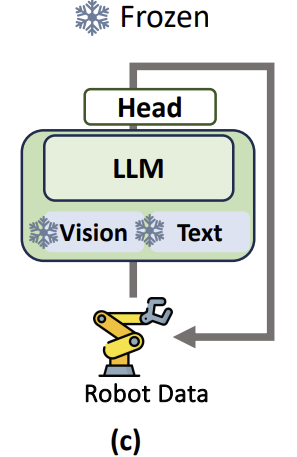
Vision encoder와 language encoder들을 각각 freeze/finetuning 하면서 어떤 modality가 영향력이 높은지 알아보고 Robot control과 관련된 지식을 FAST tokenizer을 통해 visual encoder에 주입했을 때의 효과도 탐구한다.
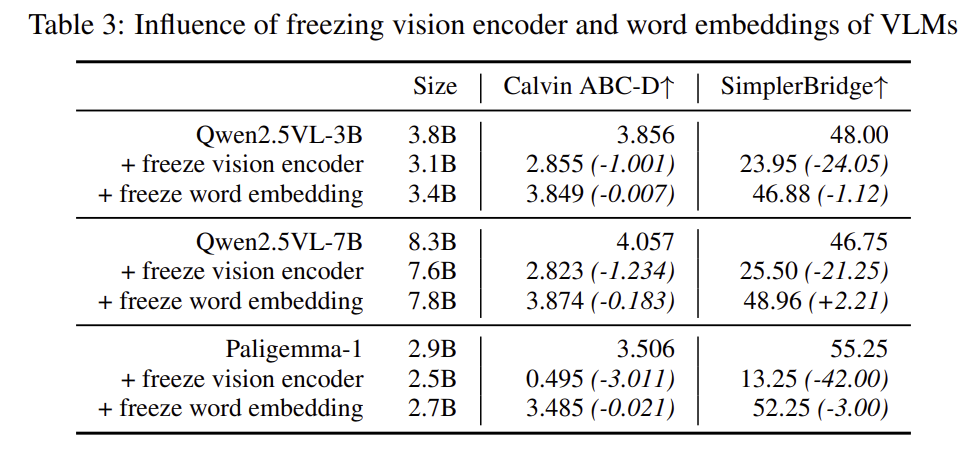
학습을 할 때 Paligemma 모델에서 vision encoder을 freeze하면 모든 benchmark에서 심각한 성능 저하가 나타난다.
또, Qwen2.5VL-7B에서는 vision encoder크기가 0.7B라서 vision encoder를 freeze해도 학습 parameter 크기가 7.6B이며 Qwen2.5 VL-3B보다 훨씬 크다. 그런데도 vision encoder을 freeze하고 학습했을 때 성능이 Qwen2.5 VL-3B보다 떨어진다.
반면, word embedding을 freeze 했을 때는 성능 저하가 거의 나타나지 않는다.
이를 통해 VLM을 VLA에 적용할 떄 vision modality가 가장 중요하다는 것을 알 수 있다.
VLM의 representation이 robot environment 시각 정보와 align시키는 것이 학습 parameter를 늘리는 것보다 더 중요하다는 것이다.
Analysis: Visual Gap betweem VLM and VLA
Vision encoder가 pretraining에서 학습한 representation은 image-text 관계에서 유용하지만 action 생성에는 유용하지 않기에 vision encoder을 학습하는 것이 VLA에서 큰 영향을 준다는 것을 알 수 있다.
Vision encoder representation과 action 생성에서 필요한 representation 간의 gap은 다음 두 가지 이유 때문이라고 가설을 세운다.
-
Pretraining 때 VLM은 simulation rendering에 적게 노출된다. 이로 인해서 simulated image으로부터 semantic representation을 효과적으로 얻지 못한다.
-
VLM의 representation은 language-output objective (QA)에 더 적합하고 robotics가 요구하는 representation은 low level action control에 특화된 것이기에 적합하지 않다.
본 논문은 다음 실험을 통해 1보다는 2가 더 유력한 가설이라고 제시한다.
Real -> sim을 없애기 위해서 real world image들로만 이루어진 BridgeV2 dataset을 사용한다. 그리고 BridgeV2 dataset의 action들을 Fast Token들로 encoding하고 Qwen3VL-4B로 autoregressive하게 action token들을 예측하도록 학습하였다. 학습을 할 때 visual encoder을 freeze/unfreeze 해서 성능을 비교하였다.
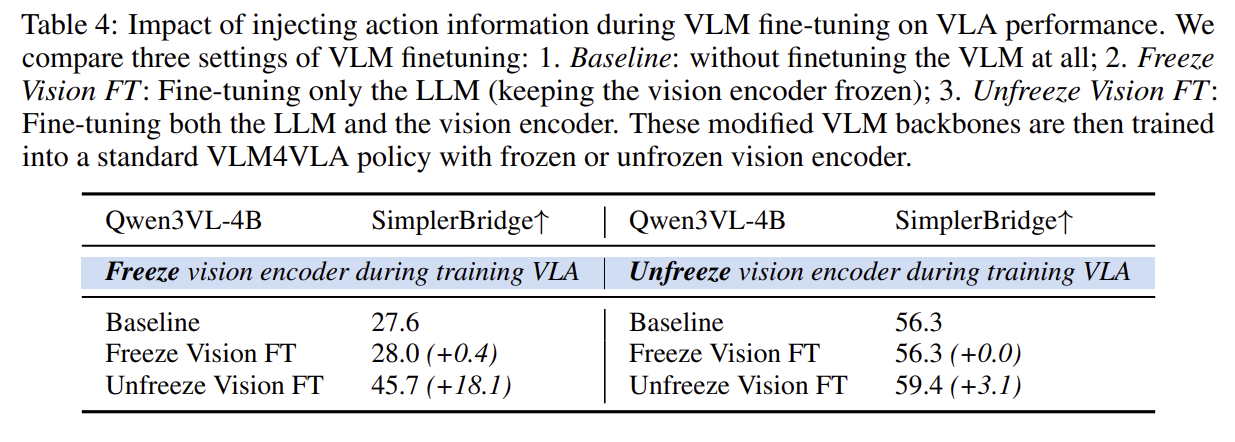
1이 유력하다면, 즉 visual encoder가 simulation image을 입력받아서 action expert에게 정보를 잘 전달하지 못하는거라면, freeze하고 학습했을 때 성능이 좋아야 한다. 하지만 성능이 unfreeze와 비교했을 때 많이 떨어진다. 이 결과가 의미하는것은 visual encoder에서는 sim to real gap은 존재하지 않고 그저 visual encoder가 action expert에게 전달하는 정보가 action 생성에 적절하지 않다는 것이다. 따라서 2의 가설이 더 유력한 것이다. Visual encoder와 action expert의 needs에는 semantic gap이 존재한다는 것이다.
그렇다고 해서 pretraining이 의미가 없다는 것이 아니다. 다음 실험 결과는 각 dataset으로 scratch부터 학습했을 때의 결과이다.
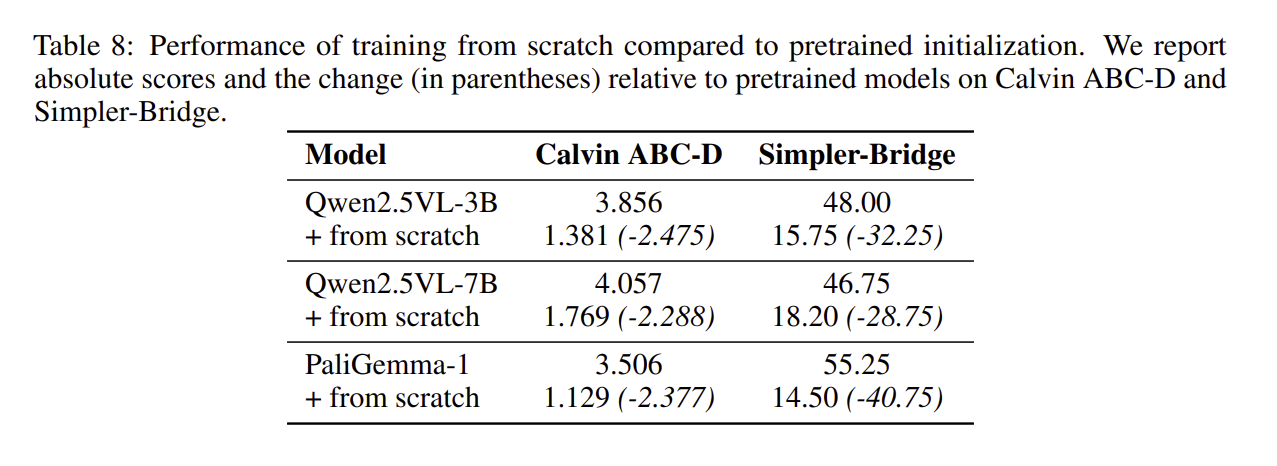
이 결과를 통해 오히려 pretraining은 필수적인 단계이라는 것을 알 수 있다. 그저, VLM이 action expert의 control gradient을 같이 받으면서 학습을 해서 semantic gap을 없애야 VLM이 action expert에게 유용한 정보를 줄 수 있다는 것이다.