Orca-Math: Unlocking the potential of SLMs in Grade School Math 리뷰
Background
수학 문제 해결은 Small Language Model (SLM)에게는 어려운 과제로 여겨진다. 최근 연구에 따르면 모델 자체의 성능만으로 GSM8K benchmark (초등학생 수학 문제)에서 80% 이상의 성능을 달성하기 위해서는 최소 34B parameters가 필요하다고 한다. SLM으로 더 좋은 성능을 내기 위해서는 추가적인 방법을 도입하는 것이 일반적이다. 예를 들어, 외부 tool을 통해 계산 실수가 존재하는지 본다거나 답변 ensembling (majority voting 등)이 있다. 특히 ensembling은 Phi-GSM 모델 성능을 68.2 -> 81.5, Llama-2 성능을 38.6 -> 71.9로 향상시킬만큼 효과적이다. 하지만 ensembling 방법은 너무 많은 API 호출을 요구한다는 점에서 비용이 비싸다.
따라서 이 연구에서는 SLM의 성능을 향상시키는 다른 방법인 Transfer Learning에 집중한다. 이 맥락에서의 Transfer Learning이란 LLM이 생성한 답안을 SLM에게 학습시켜 좋은 성능을 가진 LLM의 사고방식과 지식을 전달하는 방법이다. 또, 창의적인 학습 방법인 Iterative Learning 방법론을 추가하여 성능을 더욱 높인다.
Method
이 논문에서 사용하는 방법론을 간단하게 요약하면 다음과 같다. Data Construction Agent based setup을 활용하여 200k개의 수학문제와 그에 대응하는 정답 data를 생성한다. 이때 이 agent setup은 기존 문제 (seed set이라고 부른다)를 바탕으로 더 복잡하고 다양한 문제들과 알맞은 정답 data를 생성해주는 역할을 한다. Agent에서 활용하는 모델은 GPT4-Turbo를 사용한다.
Iterative Training
-
생성한 dataset을 SLM에게 학습시켜 LLM의 지식을 SLM에 이식한다. 그 다음, SLM을 통해 각 문제에 대해 여러 풀이를 생성하도록 하고 이 풀이들을 바탕으로 preference dataset을 생성한다. 풀이가 맞았을 경우에는 positive label을, 틀린 경우에는 negative label을 부여한다.
-
이 preference dataset을 다시 SLM에게 학습시켜 SLM의 성능을 향상시킨다.
과정 1,2를 반복하여 최종 모델인 Orca-Math를 얻는다.
이 방법론을 수행했을 때, Orca-Math는 대부분의 LLM (70B 이상)보다 우수한 성능을 보인다.
방법론의 각 단계에 대한 자세한 설명은 다음과 같다.
Data construction
이 단계에서는 다양한 난이도를 가진 광범위한 초등학교 수학 문제를 생성한다. 우선 open-source로 공개된 수학문제들을 모은다. 이 문제들을 seed set 이라고 한다. Seed set에는 총 36,217개의 문제가 들어있다. Seed set으로부터 Agent setup을 활용하여 다양한 문제들을 생성한다.
Agent - Ask Me Anything
첫 번째로 사용하는 setup은 Ask Me Anything setup이다. 이 과정에서는 Seed set의 문제들을 분해하여 비슷한 난이도/유형의 문제들을 만든다. 이 Agent를 통해 총 120,445개의 수학 Dataset을 추가로 생성한다. 각 문제에 대한 풀이는 GPT4-Turbo를 사용한다
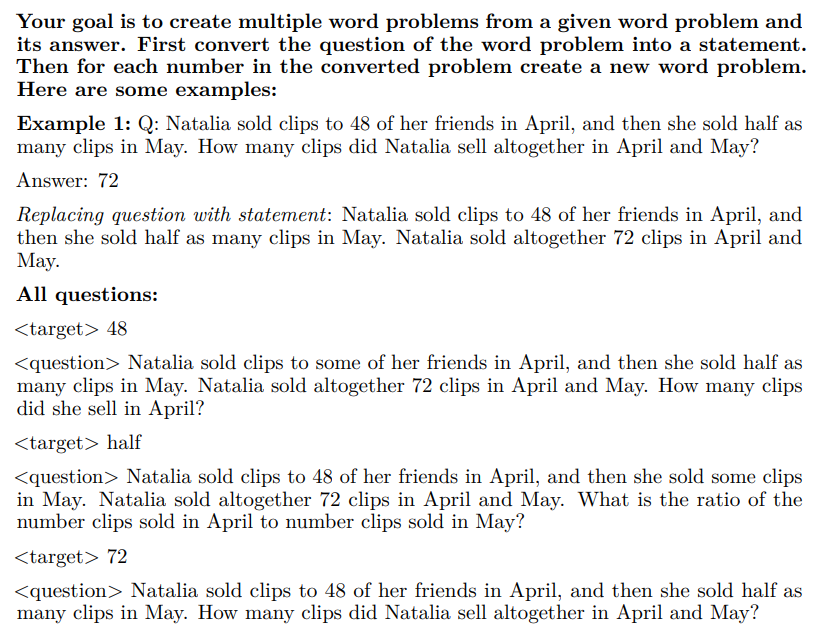
Agent - Suggester & Editor
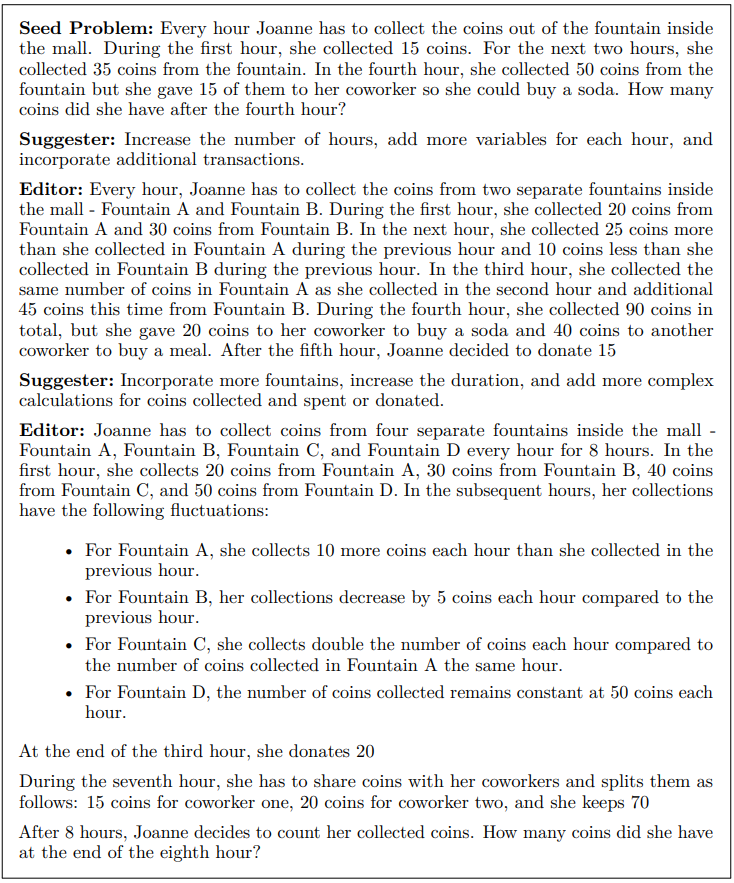
이 setup으로 Seed set 문제들을 바탕으로 더 복잡한 문제들을 만든다. Suggester는 각 seed set 문제들을 분석하고 어떻게 하면 더 복잡한 문제들을 만들 수 있는지 Editor에게 제안한다. Editor는 기존 문제와 Suggester의 제안을 검토하여 복잡한 문제를 생성한다. 이 과정을 여러 번 반복함으로써 다양한 난이도의 문제들을 생성하고 그에 대한 풀이는 GPT4-Turbo를 사용한다. 풀이가 1800 글자 수를 넘는 경우, 그 문제는 버려진다. 이 Agent를 통해 총 37,157개의 수학 Dataset을 추가로 생성한다.
여기에 DMath의 Training set의 7943개의 문제들을 가져와서 최종 Dataset Orca-Math-200k-dataset을 만든다.
Training
Supervised Fine-tuning Experiment
Orca-Math-200k-dataset으로 Mistral-7B 를 supervised fine-tuning(SFT) 시킨다. Data는 다음 형식을 통해 전달된다.
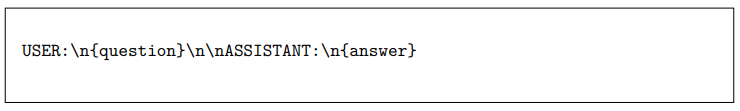 Loss는 최종 답안 token에 대해서만 계산되었으며 고정된 학습률 $1 \times 10^{-6}$을 사용한다.
SFT된 모델을 M1이라고 정의한다.
Iterative Learning from both Positive and Negative Signals
Dataset Construction Iteration #2
M1으로부터 preference dataset을 생성한다. 각 문제에 대해 M1이 생성한 4개의 풀이와 GPT4-Turbo (gold answer)가 생성한 1개의 풀이를 짝짓는다. M1 풀이의 최종 답안이 GPT4-Turbo의 최종 답안과 다르다면 negative, 같다면 positive으로 label한다. 이 paired label dataset으로 preference dataset을 구성한다. 이때 M1의 생성 argument는 top_p = 0.95, temperature = 0.7로 설정했다. 정리하자면 각 문제 $q_i$에 대해 올바른 solution dataset $q_i^+$과 틀린 solution dataset $q_i^-$가 존재하게 되는 것이다. 최종 구성된 preference dataset은 $Q_i = {(q_i, a_i^+, a_i^-) \mid (a_i^+, a_i^-) \in q_i^+ \times a_i^- }$이 된다. 이때, M1이 생성한 풀이가 다 positive이라면, 아예 다른 4개의 질문 $q_j (i \ne j)$의 negative solution dataset $q_j^-$에서 하나씩 가져와 $q_i^-$을 구성하게 했다.
이 방법으로 생성된 Preference Dataset로 KTO (Model Alignment as Prospect Theoretic Optimization) 를 사용하여 M1을 학습시켜 M2를 만든다.
KTO란 Preference data의 선호 여부 {-1, 1} (binary weak signal)만을 가지고 human preference를 잘 capture하도록 해주는 alignment 방법이다.
Dataset Construction Iteration #3
이 M2을 가지고 앞 과정을 다시 반복한다. 이때 M1이 생성한 풀이 말고 M2가 생성한 풀이를 생성하여 preference dataset을 다시 구성한다.
최종 Preference dataset에 대해 KTO 방법으로 또 학습시켜 최종 모델 Orca-Math을 얻는다.
Evaluation
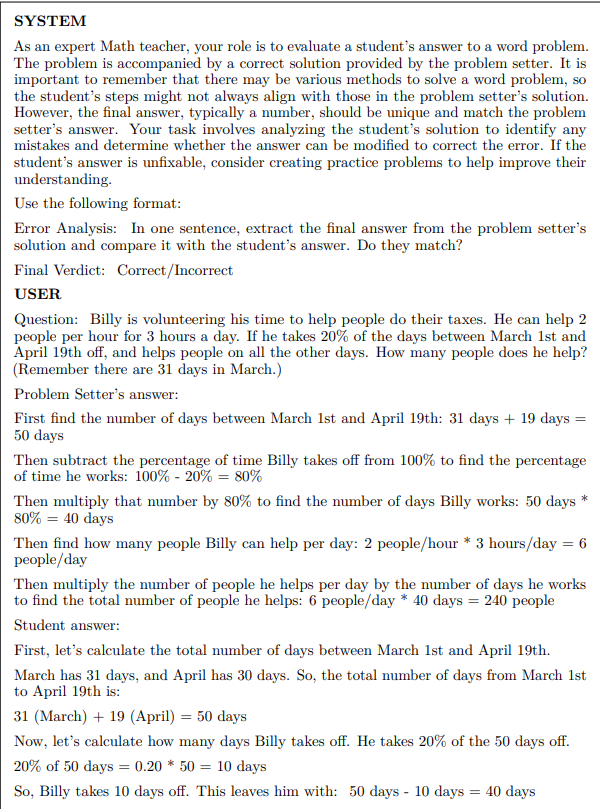
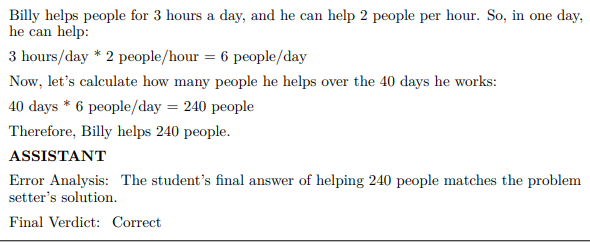
모델의 성능 측정은 GSM8k test set 문제들에 대해 모델이 생성한 최종 답과 GPT4-Turbo의 최종 답과 exact match하는지 여부로 계산하였다. 다음 prompt template으로 evaluation을 진행하였다.
Result
-
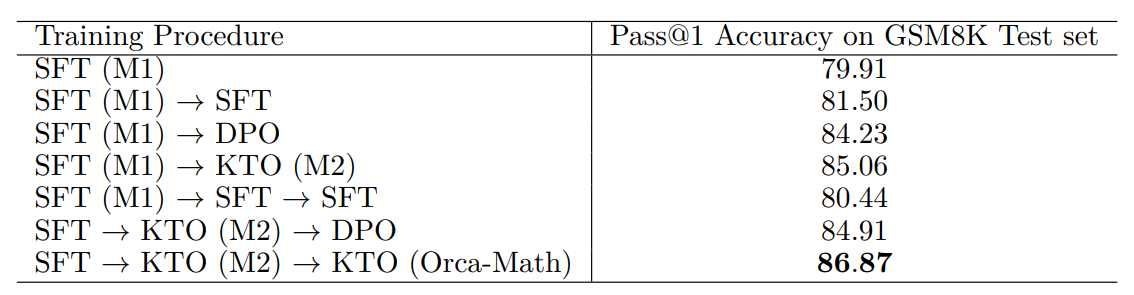
매우 우수한 data들로만 구성된 Orca-Math-200k-dataset로 SFT한 것만으로도 Mistral-7B의 성능은 79.91로 우수하게 나왔다.
-
M1으로 생성한 Preference dataset으로 M1을 다양한 학습 방법 (SFT, DPO, KTO) 을 이용하여 반복 학습한 결과 KTO로 학습했을 때가 더 우수하게 나왔다.
-
M2으로 생성한 Preference dataset으로 또 다시 (SFT, DPO, KTO) 을 이용하여 반복 학습한 결과 KTO가 더 우수하게 나왔다.
다른 모델들과 비교했을 때의 결과는 다음과 같다.
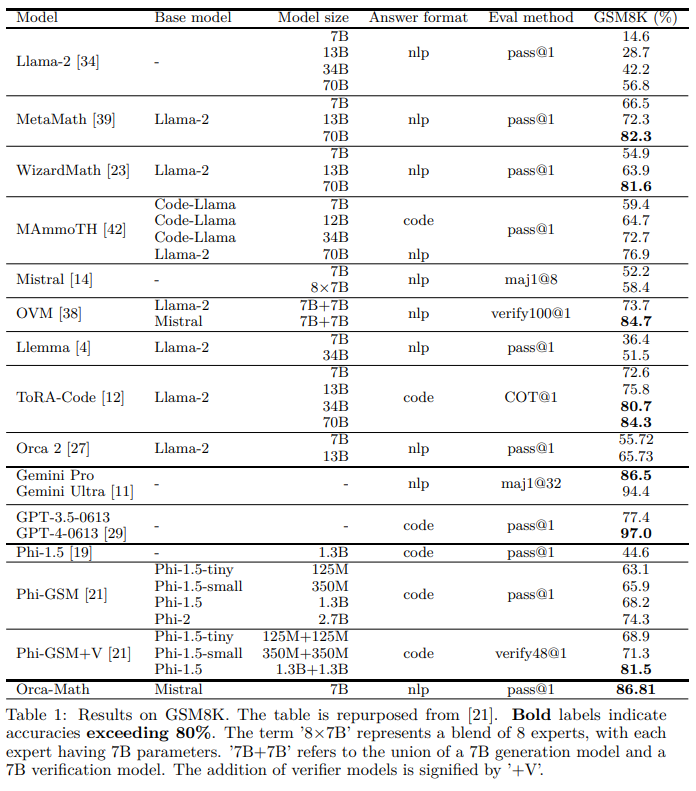
Gemini Ultra나 GPT 4 - 0613을 제외한 나머지 LLM들보다 성능이 더 우수하게 나온다.
Conclusion
Iteration Learning method과 같이 창의적인 학습 방법의 중요성을 알게 되었고 Agent으로 우수한 Dataset을 만들어 학습시켰을 때의 효과에 대해 알게 되었다.