Compose by Focus: Scene Graph-based Atomic Skills 리뷰
Background
Long horizon task을 해결하기 위해서 전체 task을 여러 개의 sub task으로 나누고 그 subtask들을 순서대로 수행하게 하는 것이 추세이다.
이전 연구들은 이 skill들을 어떻게 조합해야 하는지에 집중 (high level planner 학습) 하지만 본 논문은 각 skill들이 어떻게 설계되어야 효과적으로 이어질 수 있을까에 집중한다.
예를 들어 야채들을 바구니에 담는 task가 있다고 해보자. 이때 그 scene에 야채 말고 다른 물건 (distractors)가 존재한다고 하자.
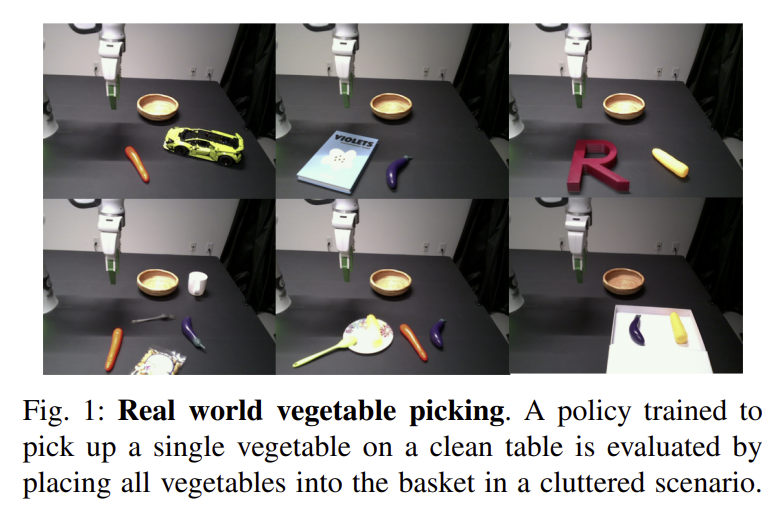
이때 high-level planner (VLM)는 당근 담기 $\rightarrow$ 가지 담기 $\rightarrow$ 옥수수 담기와 같은 계획을 세울 것이다.
본 논문은 개별 skill = 야채를 담는 skill을 학습할 때 table이 깨끗한 상태에서 학습을 한다면 distractors가 있는 상태에서 그 skill이 원하는대로 작동 안 할 확률이 높다고 주장한다.
이 문제는 high level planner에게 있는 것이 아니라 action expert에게 있다고 한다. Action expert가 학습을 할 때 다양한 상황 (ex. distractors 존재하는 scene)에서 skill을 학습하지 않았기 때문에 이런 문제가 발생한다고 하는 것이다.
따라서 본 논문은 skill들이 다양하게 조합이 가능하게 하기 위해서는 skill을 학습할 때 global scene을 바탕으로 학습을 하는 것이 아니라 skill과 관련있는 object에만 집중하는 상태에서 학습을 해야 한다고 주장한다. 이렇게 해야 distractors가 존재하더라도 skill을 수행할 때 skill과 관련있는 object만 보게 되어서 성공적으로 수행될 수 있다고 주장하는 것이다.
Related Works
Compositional Generalization
Robotics에서 skill 조합 능력은 long horizon task에 중요하다. Task을 여러 sub task으로 나눌 수 있어야 한다.
LLM을 robotics에 적용하는 연구에서는 meta-skill 라이브러리를 통해서 high-level planning에 집중하는데 low-level action execution에는 적용되고 있지 않다(?)
Task and Motion Planning에서는 discrete + continuous planning을 합쳐서 high + low level에서의 planning이 가능하지만 geometric/symbolic model가 요구되어서 generalization 능력이 부족하다.
최근에는 VLM을 segmentation model으로 사용해서 raw image을 더 효과적으로 사용하는 방법을 연구하지만 이 방법도 아직 generalization 능력이 부족하다.
Visual Imitation Learning
Imitation learning은 조작 관련된 policy을 학습하는데 효과적으로 알려져있다. 이 중에서 visual imitation learning은 policy가 2D image을 통해서 적절한 추론과 action을 하게 만드는 방법이다.
하지만 이런 방법은 공간적 정보가 부족하다. 이런 문제점으로 인해 3D 또는 동적인 4D scene representation을 사용하는 방법도 나왔지만 여전히 객체 간 관계를 명시적으로 표현하는 능력이 부족하다.
Compose By Focus
Method
Problem setup
본 논문은 long horizon task에서 skill들을 조합해서 해결하는 방법에 대해 탐구한다.
학습 데이터는 개별적인 skill에 대한 expert demonstration으로 한다. (ex: 사과를 그릇에 담기, cube를 당기기) 이때 skill을 정의할 때 “pick”, “place”처럼 고정된 primitive가 아니라 task 문맥을 포함한 short-term goal로 정의하였다. 각 atomic skill은 단독으로 수행되는 demonstration만으로 학습하며, 여러 skill이 조합된 cluttered scene의 demonstration은 학습에 사용하지 않는다.
Observations $O$, scene graph $G$, skill 설명들을 $L$, action space를 $A$라고 할 때 visuomotor policy $\pi : (G,L) \rightarrow A$가 학습되어 모든 atomic skill들을 수행하도록 하는 것이다.
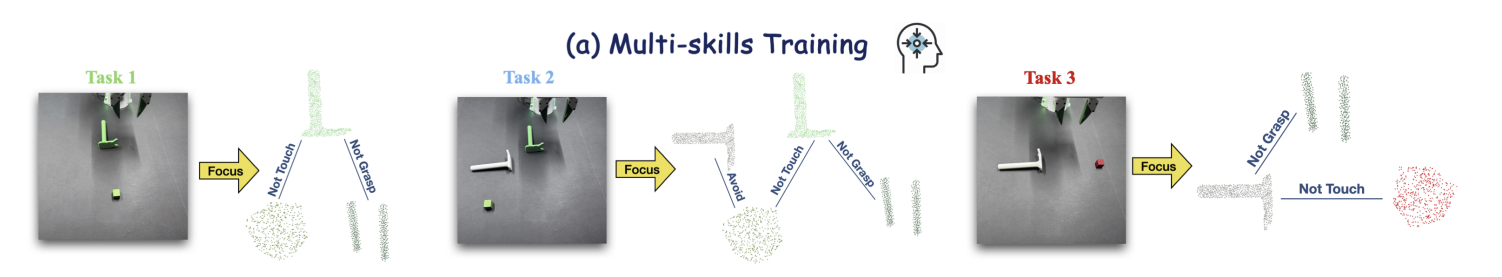
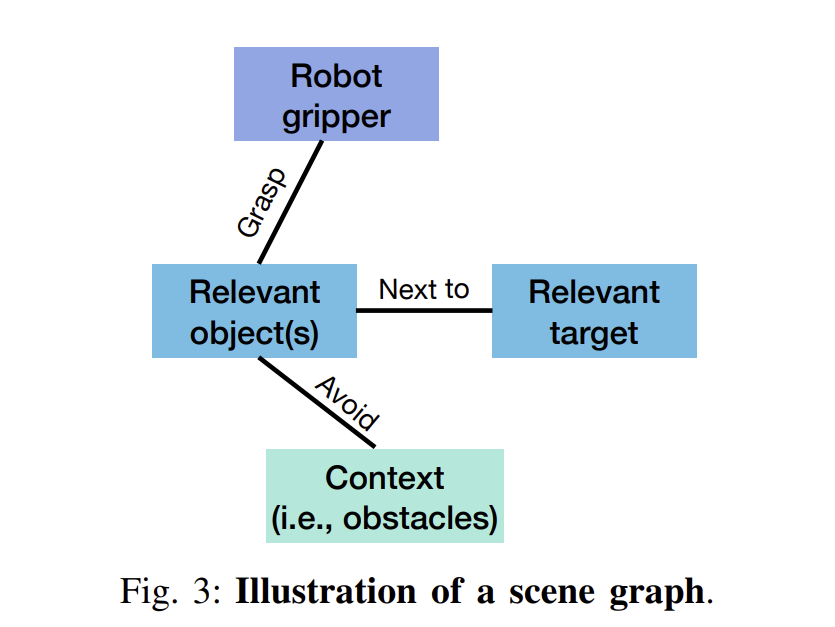
Scene Graph 구축 방법
demonstration의 RGB 이미지와 depth 이미지가 있다고 할 때, depth 이미지는 point clouds으로 바꾸고 gripper의 point clouds는 존재한다고 가정한다.
각 skill은 skill과 관련 있는 object $B$를 명시하는 언어 지시사항과 pairing한다.
이미지로부터 object level의 정보를 얻기 위해서 vision foundation 모델을 사용하여 task와 관련있는 object만 보게 하기 위해 필요한 mask을 얻고 이 object들의 point clouds을 얻는다.
이 point clouds는 farthest point sampling을 통해서 encoder로 vector representation이 변환된다. 각 object embedding은 scene graph의 노드를 구성하게 된다.
Graph의 edge는 RGB 이미지와 VLM을 통해 추론한 object 간의 semantic·spatial relation을 나타낸다. (grasp, next, inside)
Multi Skill Policy Training
Sub-scene graph를 얻은 뒤에 2-layered Graph Attention Network를 통해서 scene graph를 feature embedding으로 변환하였다. 각 노드 $i \in V$는 input feature $h_i^{(0)} \in \mathbb{R}^{d_{\mathrm{in}}}$으로 초기화된다.
각 GAT layer $l$에서 node feature들은 다음과 같은 방법으로 update 된다.
\[h_i^{(\ell+1)} = \sigma_\ell \left( \mathop{\Big\Vert}_{m=1}^{H_\ell} \sum_{j \in \mathcal{N}(i)} \alpha_{ij}^{(\ell,m)} W^{(\ell,m)} h_j^{(\ell)} \right)\]$\alpha_{ij}^{(\ell,m)}$는 head $m$에서 node $i$와 $j$ 간의 attention coefficient 값이고 $W^{(\ell,m)}$은 head $m$에서의 learnable weight 값이다.
수식의 $\Vert$ 기호는 $H_{\ell}$ 개의 attention head들의 output을 모두 concatenate하는 연산을 의미한다.
즉, object i의 embedding을 얻기 위해서 우선 graph 상에서 object i의 모든 이웃 j을 찾는다. 그 다음, 각 이웃들의 feature을 $Wh_j$ 으로 projection한다.
Object i가 이웃 j들과 얼만큼의 관련성이 있는지를 알아내기 위해 이들 간의 attention을 통해서 $\alpha_{\text{ij}}$ 을 얻는다. 이 attention 가중치 값을 통해서 weight sum을 구해 object i의 representation을 새로 얻는 것이다. 이때 multi head attention을 사용해서 head마다 중요하다고 생각하는 것이 달라지기에 각 head의 output들을 모두 concatenate 한 것이다.
2 layered Graph Attention Network에서 첫 번째 layer는 head 4개를 사용하고 두 번째 layer는 head 1개만 사용하는데 이는 처음에는 다양한 관점으로 주변 정보를 모으고 두 번째 layer에서 이 feature을 하나의 embedding으로 통합시키기 위함이다.
Graph Attention Network의 한 layer에서 각 head가 $z_i^{(\ell,m)} \in \mathbb{R}^d$를 출력한다면 다음과 같다.
\[\mathop{\Big\Vert}_{m=1}^{H_\ell} z_i^{(\ell,m)} = \left[z_i^{(\ell,1)}; z_i^{(\ell,2)}; \ldots; z_i^{(\ell,H_\ell)}\right] \in \mathbb{R}^{H_\ell d}\]
전체 graph representation (global mean pool)은 다음처럼 얻어진다.
\[F = \frac{1}{\lvert V \rvert} \sum_{i \in V} h_i^{(2)}\]즉, graph을 구성하는 노드들의 평균 embedding으로 전체 graph을 구성하게 하였다.
각 skill의 언어 지시사항은 CLIP encoder으로 encode해서 skill description feature P으로 만든다.
논문은 visuomotor policy (Action expert)을 conditional denoising diffusion model으로 구현하였다.
Action expert가 개별 skill을 학습할 때 scene graph features F, skill description P, robot state Q에 대해 condition 되어 random Gaussian noise가 정답 demonstration action $A_t$가 되도록 denoising하는 방향으로 학습을 한다.
수식으로 설명하면 action expert $\epsilon_{\theta}$는 Gaussian noise $A^{K}_t$에서 시작해서 $K$번의 iteration을 통해 정답 action $A^0_t$가 되도록 학습하는 것이다.
\[A_{t}^{k-1} = \alpha_k \left( A_{t}^{k} - \gamma_k \epsilon_{\theta} \left( A_{t}^{k}, k, F, P, Q \right) \right) + \sigma_k \mathcal{N}(0,\mathbf{I}), \tag{1}\]이때 $\mathcal{N}(0,\mathbf{I})$ 는 Gaussian noise이고 $\alpha_k$, $\gamma_k$, 그리고 $\sigma_k$ 는 noise scheduler hyperparameter이다.
$\epsilon_{\theta}$ 은 학습 objective function으로는 k-th iteration에 noise $\epsilon^k$ 을 정답 action $A^0_t$ 에 넣고 noise $\epsilon^k$ 을 예측하도록 하는 MSE을 사용한다
\[\mathcal{L} = \operatorname{MSE} \left( \epsilon^{k}, \; \epsilon_{\theta} \left( \bar{\alpha}_{k}A_{t}^{0} + \bar{\beta}_{k}\epsilon^{k}, \; k, \; F, \; P, \; Q \right) \right).\]$\bar{\alpha}{k}$와 $\bar{\beta}{k}$는 noise scheduler의 계수이다. End-to-end로 point cloud encoder, graph encoder, diffusion model (action expert)을 학습한다.
Test time skill composition
실제 inference에서는 VLM이 long horizon task를 여러 subgoal $S$로 나누고 각 subgoal마다 연관된 object를 파악한다. 각 observation마다 Grounded SAM으로 관련 object를 segmentation한 뒤 depth 정보를 이용해 point cloud를 얻고, VLM은 object 간의 semantic relationship을 추론한다. 이 정보들을 바탕으로 각 subgoal마다 dynamic sub-scene graph가 만들어지고 이 graph는 GNN을 통해 feature embedding으로 변한다.
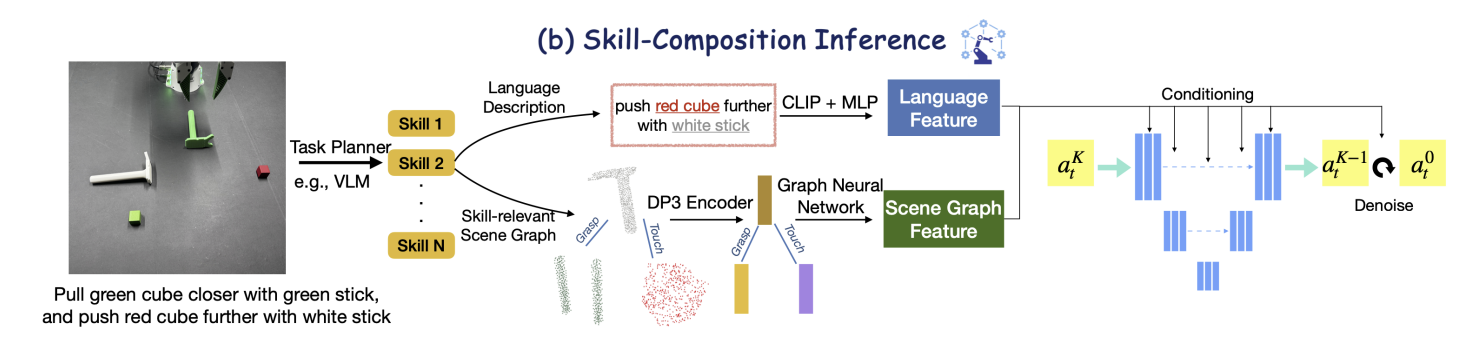
그 다음 action expert는 위 그림처럼 graph feature와 subgoal description에 condition 되어 subgoal에 맞는 action을 생성한다. 단, test time에 필요한 atomic skill 자체는 모두 training에서 학습된 것으로 가정한다.
Experiment
Simulation Experiment
본 논문은 scene graph을 policy의 input으로 사용해서 skill composition을 통한 long horizon task 능력을 증명하고자 한다. 따라서 실험의 목적으로
-
다양한 scenes에서 scene graph을 통한 zero shot generalization 능력 증명
$\rightarrow$ 일반적인 2D, 3D 이미지로 학습된 action expert들은 distribution shift으로 인해서 다양한 scenes에서 성능이 안 좋기 때문
-
Scene graph을 사용하는 것의 효과를 증명
Task description
Long horizon task 평가를 위해 ManiSkill2로 여러가지의 skill이 요구되는 long horizon task들을 총 5 set 생성하였다.
이 task들은 13개의 atomic skill (ex: pull, place, push, pick, etc) 을 사용하도록 구성하였다. 또, task을 구성할 때 난이도를 높이기 위해 특정 물건과 접촉하지 않고 수행하도록 하는 것과 같은 제약사항을 추가하였다.
각 atomic skill을 학습하기 위해서 각 atomic skill마다 100개의 demonstration을 모았다.
Multi skill이 요구되는 long horizon tasks
-
Cube out and in
통에서 Red cube을 꺼내기 + 통에서 blue cube 넣기 skill이 요구되는 task으로 통에 red cube가 있고 blue cube는 밖에 있는 상황에서 시작한다.
이때 task description은 put the blue cube into the bin so that only the blue cube remains inside이다.
-
Sort by color
특정 물건을 특정 위치로 옮기는 skill이 요구되는 task으로 실제 평가할 때는 세 색깔의 위치들이 존재하고 세 물건을 그 물건의 색과 동일한 곳으로 옮기라고 시킨다.
task description은 put the three objects onto the ellipses of same color
-
Blocks stacking game
두 cube가 쌓여있다면 중앙으로 같이 밀어라, 빨간색 큐브가 초록색 큐브 뒤에 있다면 초록색 큐브를 밀기 전에 빨간색 큐브를 먼저 들어라, 빨간색 큐브 위에 아무것도 없다면 보라색 큐브를 쌓아라 와 같은 atomic skill들을 바탕으로 실제 평가에서는 세 색깔의 큐브가 등장하고 move the red cube to the center while avoiding the green cube, and then stack the purple cube on top of the red cube if there is no other cube on it 라는 task을 준다.
-
Tool Usage
L 모양의 도구로 cube을 pull해라, 막대기를 통해 큐브를 밀어라 와 같은 atomic skill들을 바탕으로 평가에서는 두 도구 모두 등장하고 큐브가 두 개인 상황에서 pull back the blue cube with red tool and push away the green cube with yellow tool 라는 task을 준다
-
Obstacle Avoidance
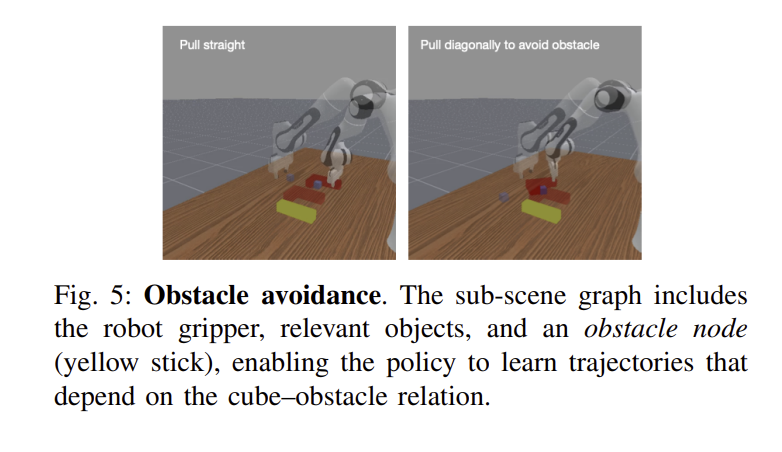
큐브를 pull할 때 방해물이 있다면, 대각선으로 pull해서 부딪치는 것을 방지해야 하는 것과 같이 복잡한 atomic skill이 요구된다. 평가할 때는 pull one cube back with red tool and push another cube away with yellow tool, while avoiding the obstacles라는 task를 준다.
Baseline
비교 대상으로 2D 기반 diffusion policy, 3D 기반 diffusion policy, $\pi_0$ 을 사용한다.
이 비교 대상을 통해 구조화된 scene 정보 (scene graph)가 general한 skill composition에서 효과적이라는 것을 증명하고자 한다.
각 모델을 각 long-horizon task에서 50개의 random seeds (initial positions)로 평가한다. 각 trial의 점수는 완료한 sub-skill의 비율이며, 논문은 이 점수의 평균을 보고한다.
Results
Atomic skill 성공률
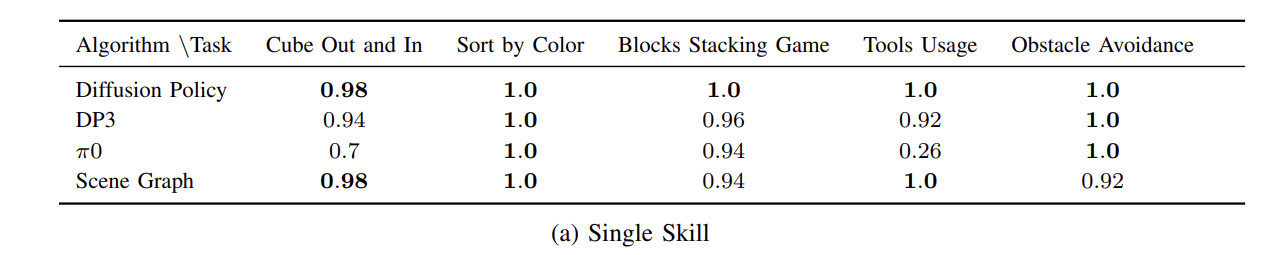
이 결과를 보면 scene graph 기반으로 했을 때 거의 완벽한 성공률을 보여주는 것을 알 수 있다. Baseline도 atomic skills에 대해서는 어느정도 좋은 성능을 가졌다는 것을 알 수 있다.
Skill Composition
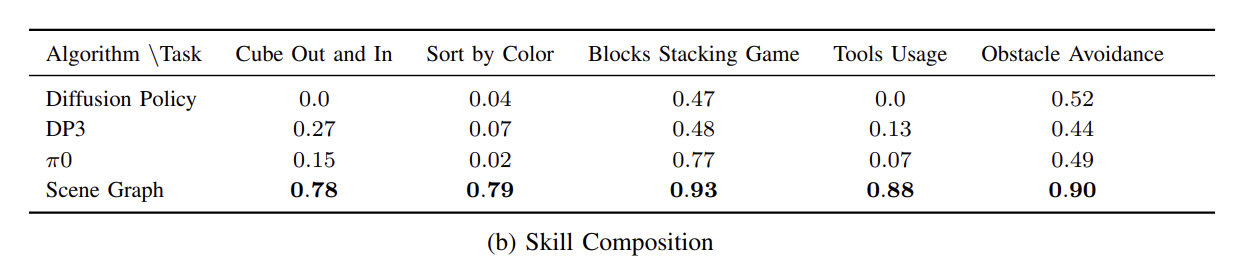
Scene graph 기반 모델 성능을 보면 skill composition task와 atomic task와 큰 차이가 존재하지 않는다는 것을 알 수 있다.
반면 baseline들에서는 성능 저하가 뚜렷하다.
이 결과들을 통해서 본 논문은 다음 4가지의 정보를 알려준다.
-
Behavior cloning에서 visual perturbations에 대한 민감성
2D, 3D 기반 policy들은 평가할 때 scene에 기존에 없던 distractors가 생기면 이상한 행동을 보인다.
-
대규모 pretraining만으로는 이 실험의 distribution shift를 해결하지 못한다
$\pi_0$는 대규모 데이터로 pretraining되고 atomic skill dataset으로 finetuning되었지만 이 논문의 skill composition task에서는 좋지 않은 성능을 보였다. 따라서 이 실험에서는 대규모 pretraining만으로 atomic-skill 학습 환경과 compositional scene 사이의 visual distribution shift를 충분히 해결하지 못했음을 보여준다.
-
Domain adaptation 문제
기존 Behavior cloning을 통해서 skill composition (long horizon task)이 가능하기 위해서는 atomic skill들의 모든 조합을 학습해야 한다. 즉, long horizon task들을 하기 위해서 각 long horizon task들의 demonstration이 필요하다. 하지만 Human manipulation 데이터는 매우 비싸기 때문에 이런 방법은 비효율적이고 cost effective 하지 않다. 반면에 개별적인 skill을 behavior cloning으로 학습하고 VLM/LLM의 추론 능력을 이용하면 generalization 성능이 더 좋아진다고 주장한다.
-
Scene graph representation의 장점
Scene graph는 nodes 수, node 간의 정보들을 유연하게 다룰 수 있다는 장점이 존재한다. 이런 graph의 특성이 세밀한 action (그냥 pull vs obstacle 피하는 pull)을 가능하게 해준다고 한다.
Ablation Study
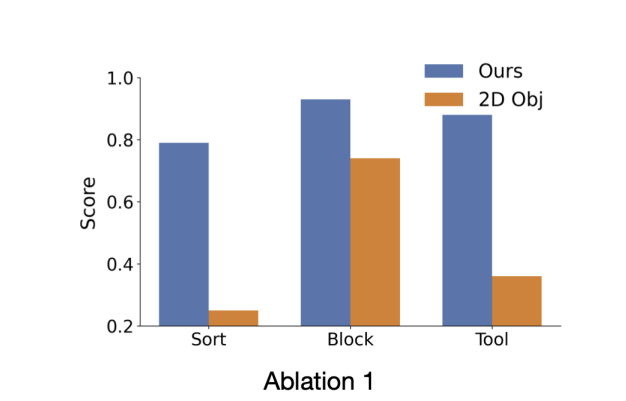
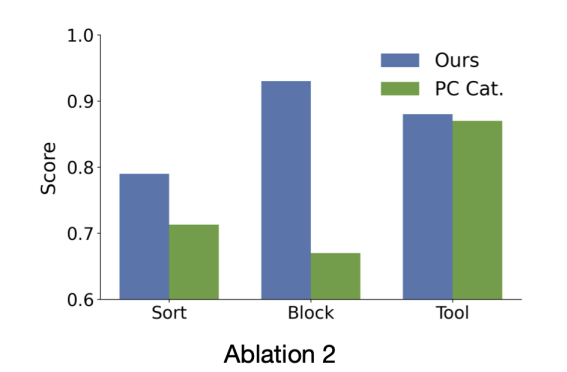
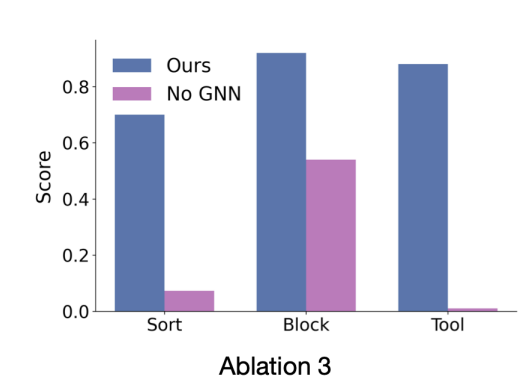
Atomic skill들을 조합하여 long term task을 하기 위한 policy 학습에 3D Scene graph representation가 주는 이점을 알아내기 위해 세 가지의 ablation study을 진행한다.
이 study에서는 Sort by Color, Blocks Stacking Game, Tool Usage task가 사용된다.
3D representation의 장점
Graph representation의 장점
Structured 하지 않은 3D scene representation을 사용하는 방법과 scene graph representation을 사용하는 방법을 비교하였다.
GNN으로 graph representation을 만드는 것의 장점
GNN을 통해서 노드 간의 정보를 encoding 하는 방법과 그냥 node features을 concat하는 방법의 차이를 실험했다. 후자 방법은 concatenation 순서에 민감하고 edge information을 사용하는 정도가 다르기 때문에 GNN을 사용하는 것이 효과적이라는 것을 보여준다.
Real World Experiment
Real world 실험에서 모든 모델들은 동일한 steps 동안 동작하게 했고 각 task마다 20번 시도하게 하였다. 각 trial의 최대 점수는 1을 갖게 하였고 수행하면서 성공한 sub task의 비율로 최종 점수를 설정하였다.
Real world vegetable picking
Single Skill Evaluation
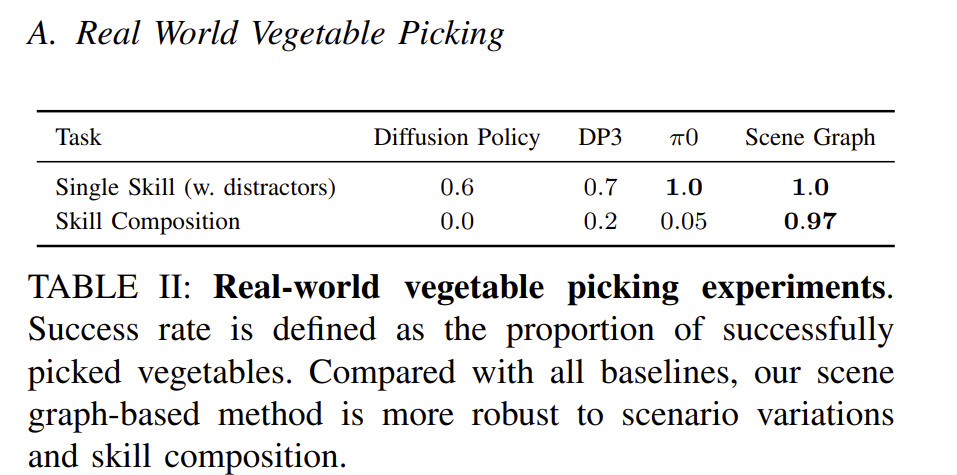
Atomic skill은 하나의 야채를 바구니에 넣는 것이고 이 skill에 대해서 평가를 하였다.
Scene graph와 $\pi_0$은 좋은 결과를 보여주지만 2D,3D diffusion policy들은 성공률이 높지 않다.
Skill Composition Evaluation
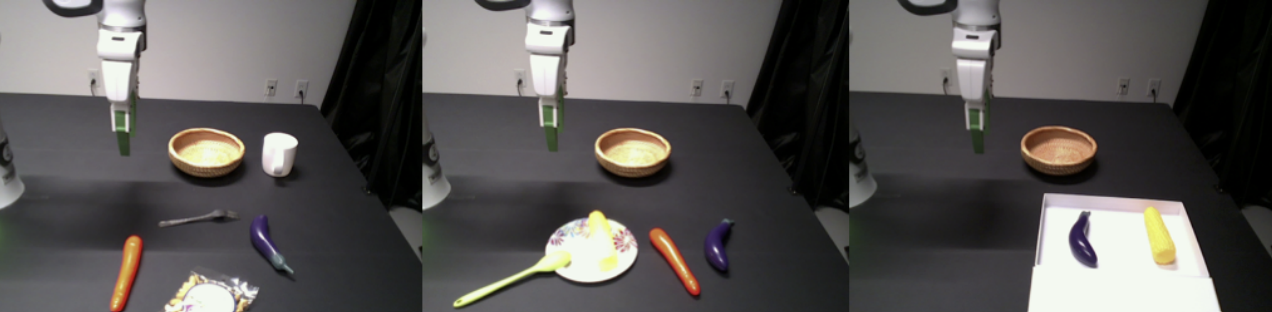
여러 야채들과 distractors들이 존재할 때, Pick up all vegetables and put them in the basket을 하도록 하였다. Substeps는 ChatGPT (VLM)으로 생성하였다. ex: “1. Pick up the corn and put it in the basket. 2. Pick up the carrot and put it in the basket”
각 substep description은 순차적으로 모델에게 전해졌다.
결과를 보면 본 논문의 방법이 압도적인 성능을 보여준다는 것을 알 수 있다.
Real World Tool Usage
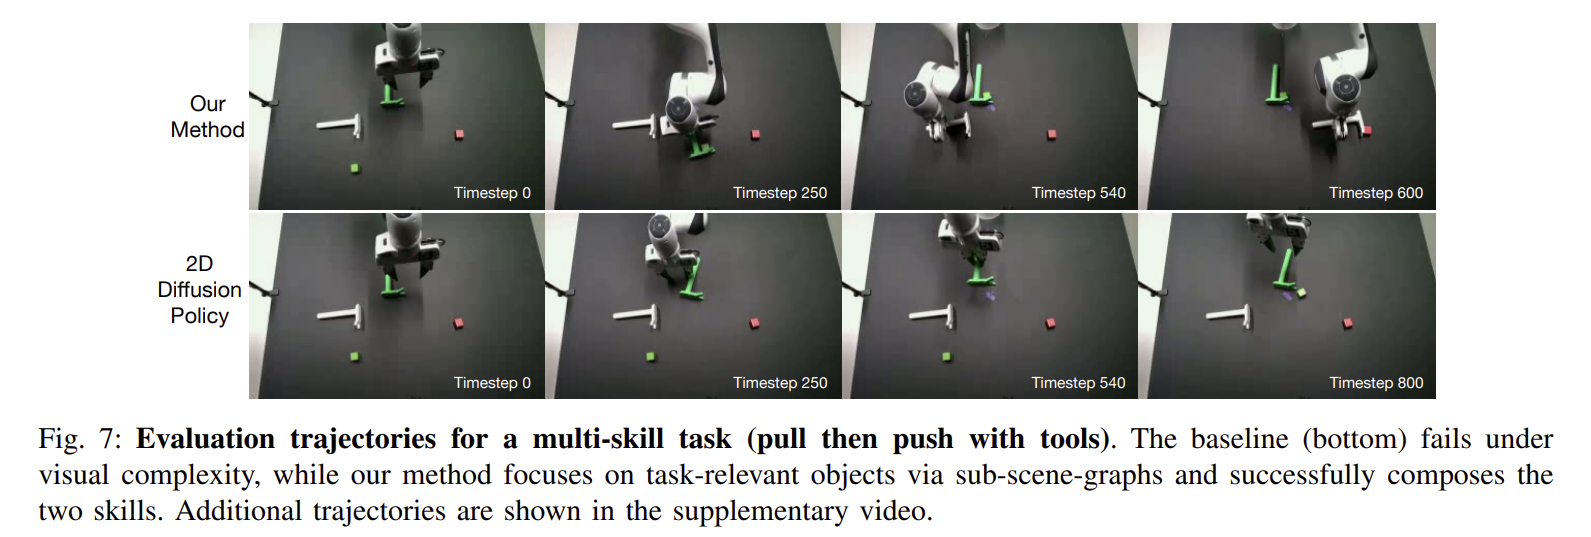
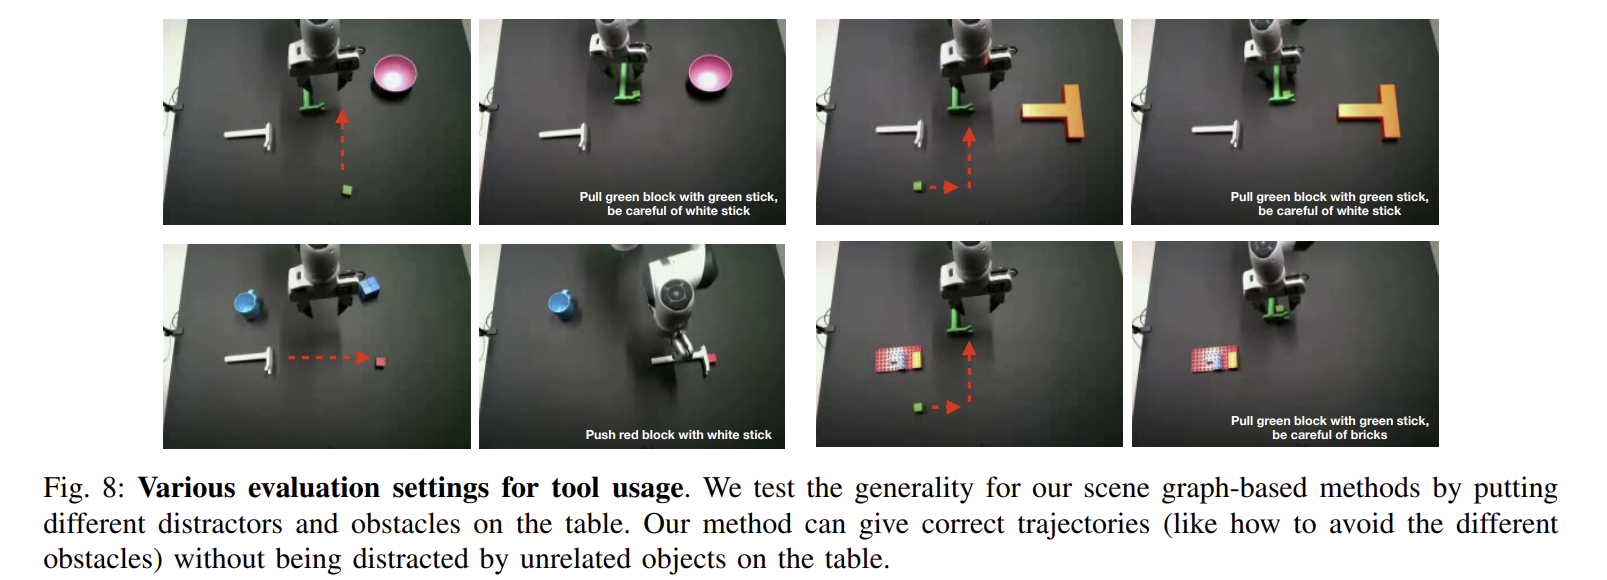
Tool usage task을 실제 상황에서도 평가하였다. 막대 두 개와 두 개의 큐브가 존재할 때 Use the green stick to pull the green cube, be careful of the white stick; then use the white stick to push the red cube 이라는 task을 주었다.
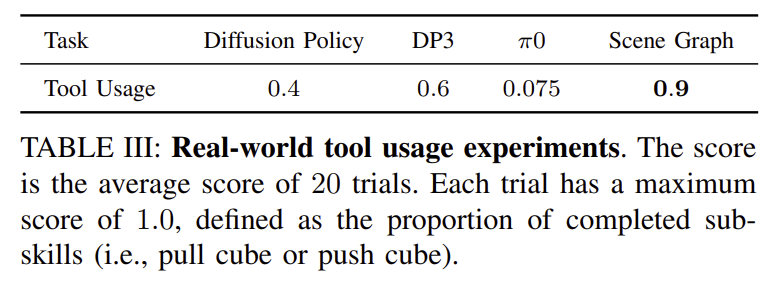
이 방법에서도 Scene Graph 기반 방법이 압도적인 성능을 보여준다
예시 trajectory는 다음과 같다.
다양한 상황에서도 generalization을 보여준다.
나의 주제
개별적인 skill을 학습할 때 task relevant object만을 보면서 학습을 하면 long horizon task에서 sub task별로 나누면서 해도 skill들을 수행하면서 생기는 distributional shift 문제를 해결할 수 있다.
Compose by Focus는 이 문제를 3d graph representation으로 해결을 하지만 subgoal마다 graph representation을 만들기 / LLM 호출하기 등은 long horizon task 수행 시간을 너무 길게 만든다.
따라서 해야 하는 것은 더 간단하게 camera 정보를 이용하여 task relevant objects을 얻어낼 것인지.