ReFT: Reasoning with REinforced Fine-Tuning 리뷰
Background
일반적으로 LLM의 추론 능력을 향상시키기 위해 CoT annotation 데이터를 활용한 학습을 진행한다. 이때 CoT annotation이란 정답에 도달하기까지의 논리적 사고 흐름을 함께 제공하는 데이터이다. 보통 질문에 대한 사고 흐름을 잘 맞추기 위해 이를 구성하는 token들을 잘 예측하도록 supervised learning으로 학습한다. 이 방법의 문제점은 질문당 하나의 풀이만 학습한다는 점이다. 결과적으로 LLM은 다양한 풀이 과정을 탐색하지 못하게 되어, 일반화 성능이 저하된다.
ReFT 방법론
ReFT 논문은 우선 두 종류의 CoT annotation을 사용한다. Natural Language CoT (N-CoT)와 Program based CoT (P-CoT).
ReFT는 일반화 성능을 높이기 위해 두 단계를 거쳐 학습한다.
Warm up 단계
(질문 x, 풀이 CoT e)로 구성된 dataset에 대해 Supervised Finetuning하여 일정 수준의 문제 해결 능력을 갖추는 단계이다. CoT $e$에 포함된 토큰들을 다음 토큰 예측을 위한 action 시퀀스로 간주하여, policy $\pi_\theta$가 적절한 풀이를 생성하도록 학습한다. 마지막 action token <eos>은 생성을 끝내도록 signal한다.
CoT e = [ $a_1, a_2, …, a_L$ = <eos>]. 이때 L은 생성할 수 있는 CoT의 maximum length이다. 즉, 매 timestep마다 policy $\pi_\theta(\cdot \mid s_t)$ 로부터 vocabulary의 임의의 token인 $a_t$을 sample한다고 보면 되고, $s_t$은 질문과 지금까지 생성된 token들의 concatenation이라고 보면 된다.
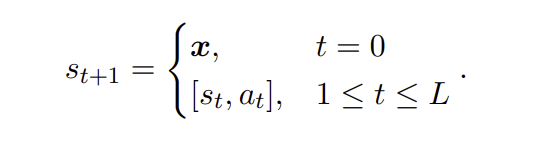
이 과정의 loss function은 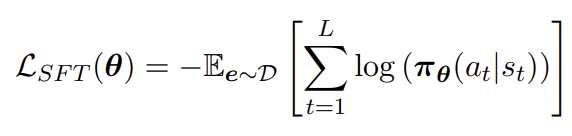
Reinforcement Learning 단계
이 단계에서는 강화학습을 통해 policy가 (질문 x, 답 y) data 로 online self learning을 한다.
Self learning이란 model이 생성한 sample로 또 학습을 하는 과정이고 online이란 data가 하나씩 들어올 때마다 바로 model을 update하는 방식이다.
ReFT에서 Self Learning을 하기 위해 문제 x가 주어졌을 때 Policy model $\pi_\theta$ 가 x를 푸는 CoT data $\hat{e}$ 를 일정 개수만큼 생성하도록 하였다.
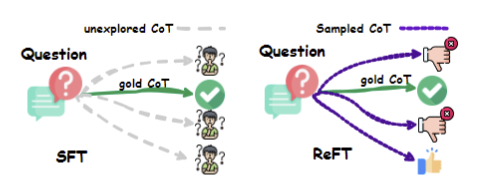
모델이 CoT data에 대해 SFT를 warm up 단계에서 이미 하였기에 $\hat{e}$ 은 “풀이… 그래서 답은 k” 형태로 되어있다. 따라서 마지막 부분을 추출하면 model의 답안 $\hat{y}$ 을 얻을 수 있다. 이 과정을 EXTRACT()라고 하자. 즉, $\hat{y} \sim $ EXTRACT( $\hat{e}$ )이다. $\hat{y}$ 와 실제 답 y의 일치 여부를 이용해 강화학습에 사용될 reward가 정해진다. 이때, 답이 틀린 $\hat{e}$도 학습에 사용한다. 즉, SFT보다 다양한 풀이에 대해 학습하여 일반화 성능을 높이고자 하였다.
논문에서 PPO with clipped objective algorithm을 통해 policy를 update한다.
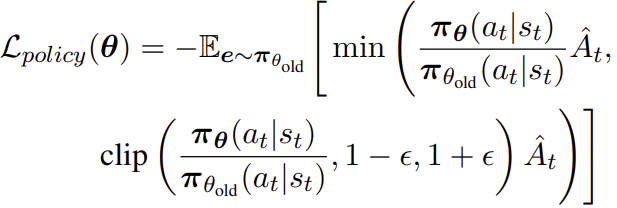
Policy를 PPO로 update하기 위해 우선 사용할 reward function, value function, 그리고 advantage function을 정의해야 한다.
Reward Function $r(s_t, a_t, s_{t+1})$
이 reward function은 $s_t$에서 $a_t$을 함으로써 얻는 즉각적 reward이다. 논문에서 $a_t$로 terminal state에 도달하지 못했다면 0, EXTRACT($s_{t+1}$) = y라면 1의 reward을 준다. Dataset 중에 답이 모두 숫자로 이루어진 dataset에 대해서는 정답과 완전히 일치하지 않더라도 EXTRACT가 가능하고, 답이 숫자 형식이라면 0.1의 보상을 부여한다.
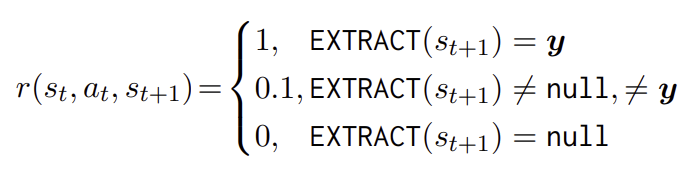
0.1과 같은 partial reward는 sparse한 reward로 학습을 할 때 생기는 부정적인 영향을 줄여준다고 한다.
최종적으로 $s_t$에서 $a_t$를 취함으로써 얻는 총 즉각적 reward를 논문에서 다음과 같이 정의한다.
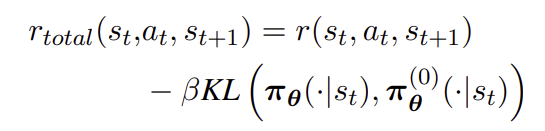
KL divergence를 통해 과도한 policy 변화가 일어날 때 reward를 감소하도록 설정했다.
Value Function (model) $V_\phi$
PPO은 지금 policy가 얼만큼 잘하고 있는지를 추정해서 그 값을 증가시키는 action은 자주 sample 되도록, 그 값을 감소시키는 action은 덜 sample 되도록 policy를 update한다. 잘한다의 기준은 policy가 sample하는 action $a_t$ 이 가져다주는 보상, 즉 advantage가 높은지에 따라 결정된다. 하지만 $a_t$가 미래에 가져다줄 모든 reward은 계산하기 어렵기 때문에 이 값을 estimate 할 수 있는 함수를 구해야 한다. 이런 함수를 value function이라고 한다. ReFT 논문에서는 함수가 아니라 linear model로 value function을 대체한다. warm up이 끝난 $\pi_\theta$의 마지막 hidden states 위에 linear value head을 추가하여 value function을 구성한다. 이 function은 state $s_t$에서부터 미래에 얻을 수 있는 총 보상의 기댓값을 계산한다.
Advantage 계산
Advantage를 계산하는 방법에는 여러가지가 존재한다.
-
몬테카를로 방식의 Q를 사용한 Advantage 함수: $A_t = Q_t(s_t, a_t) - V_\phi(s_t)$
여기서 $Q_t(s_t, a_t)$ 는 state $s_t$에서 $a_t$를 sample함으로써 얻는 기대 누적 보상이고 $V_\phi(s_t)$는 state $s_t$에서 얻을 수 있는 기대 누적 보상이다. 하지만 Q를 계산하기 위해서는 모든 state, action 쌍에 대해서 미래 보상 기댓값을 계산해야 하기 때문에 $a_t$를 골랐을 때 policy에게 즉각적인 피드백을 주지 못한다. 이 문제를 해결하기 위해 temporal difference $\delta_t$를 사용한다. 이 방법은 몬테카를로 방식의 Q 추정치처럼 보상 시퀀스(sequence)의 무작위성이 누적되어 분산이 크다. -
Temporal Difference Error: $\delta_t = r_t + \gamma V_\phi(s_{t+1}) - V_\phi(s_t)$ 여기서는 $r_t + \gamma V_\phi(s_{t+1})$ 가 $Q_t(s_t, a_t)$를 대체한다고 보면 된다. $r_t + \gamma V_\phi(s_{t+1})$에서 $r_t$은 timestep t에서 $a_t$를 취함으로써 얻는 즉각적인 보상이고 $\gamma V_\phi(s_{t+1})$은 미래 state $s_{t+1}$에서부터 얻을 수 있는 기대 누적 보상이다. 이 방법의 장점은 앞선 방식처럼 모든 state-action 쌍에 대해 기대 보상을 계산할 필요가 없으며, 상태값에만 의존하기 때문에 $a_t$를 선택했을 때 policy에 즉각적인 피드백을 부트스트래핑 방식으로 제공할 수 있다는 점이다. 즉, episode 종료를 기다리지 않고 즉시 policy를 update 할 수 있다. 하지만 이 방법 또한 문제점이 존재한다. 가치 함수 추정값 $V_\phi(s_t)$가 잘못 추청된다면 그 잘못된 추정값이 다음 update에도 반영이 되어 오류가 연쇄적으로 확대되고 누적될 수 있다. 이러한 이유 때문에 편향이 크다고 한다. 이러한 문제를 완화하기 위해 Generalized Advantage Estimation(GAE) 기법이 제안되었다.
참고: 축구 경기에 비유하면, Q-learning은 축구게임이 끝나고 나고 결과에 따라 축구선수들이 잘했는지 못했는지를 판단하는 것이고 Temporal Difference는 경기 중간중간에 주변인 $V_\phi(s_{t+1})$ 에게 축구 선수들이 잘 하고있는 것 같은지 물어보고 그 답변에 따라 축구선수들의 실력을 판단하는 것이다.
-
Generalized Advantage Estimate: $\hat{A_t}^{\text{GAE}(\gamma, \lambda)} = \sum_{l=0}^{L-t} (\gamma \lambda)^l \, \delta_{t+l}$ GAE는 Q-learning과 Temporal Difference의 가중 평균이라고 보면 된다. GAE는 분산도 높지 않으며 편향도 높지 않은, 안정적인 advantage estimation을 구할 수 있게 된다. $\lambda$ 값에 따라 둘의 비율이 정해진다.
- $\lambda$ = 0일 때는 $\hat{A_t}^{\text{GAE}(\gamma, \lambda)}$ = $\delta_t$ => 즉각적인 reward만 고려
- $\lambda$ = 1일 때는 $\hat{A_t}^{\text{GAE}(\gamma, \lambda)}$ = $\delta_t + \gamma \delta_{t+1} + … + \gamma^{L-t} \delta_{L}$ => 모든 누적 reward 고려
GAE의 안정성 때문에 논문에서 GAE로 Advantage를 계산한다.
이 Reward function, value function, advantage function을 가지고 논문은 정의한 Value model이 더 value를 더 잘 예측하도록 다음 value function objective으로 value model을 update하였디.
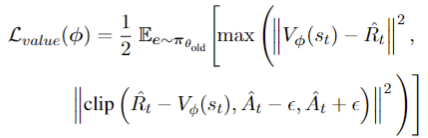
$\hat{R_t} = \hat{A_t} + V_\phi(s_t)$ 을 value의 이상적인 예측값을 계산하고 $V(s_t)$의 값이 $\hat{R_t}$와 유사하도록 update하는 것이다.
Experiment
Dataset
-
세 종류의 수학 문제 dataset, GSM8K, SVAMP, MathQA에 대해 실험을 진행하였다. GSM8K, SVAMP은 답변 형식이 숫자 값인 dataset이고, MathQA는 답변 형식이 객관식(A, B, C, D).이다. Numeric MathQA라는 추가적인 dataset을 만들어 MathQA의 객관식 형식에서 발생 가능한 보상 해킹(Reward Hacking) 현상을 분석했다.
-
GPT-3.5-turbo를 사용하여 Few-shot 프롬프팅을 통해 N-CoT 및 P-CoT을 얻었다.
Baseline
-
SFT (Supervised Fine-Tuning) 가장 기본적인 기준선으로, 언어 모델을 단순히 원본 훈련 데이터에 대해 미세 조정(fine-tune)하는 방법이다.
-
자가 학습 (Self-Training, ST) 자가 학습 방법은 모델이 직접 생성한 샘플을 훈련에 사용한다는 점에서 ReFT와 메커니즘을 공유하므로 공정한 비교가 가능하게 합니다. 두 가지 ST 방법이 구현되었다.
-
Offline Self-Training (Offline-ST) 초기 SFT 체크포인트를 사용하여 CoT를 샘플링한다. 샘플링된 CoT 중 정답을 포함하는 샘플(→ 전문가 샘플)만 남기고 원본 훈련 데이터와 이 전문가 샘플을 결합하여 SFT를 수행한다.
-
Online Self-Training (Online-ST) 이 방법은 ReFT와 밀접하게 비교하기 위해 설계되었으며, ReFT와 동일한 warm-up 과정을 거친다. 각 훈련 단계에서 모델은 CoT를 샘플링한다. 샘플 중 정답을 포함하는 CoT만 남긴다. 샘플링된 정답 CoT와 원본 정답 CoT를 결합하여 SFT로 모델 파라미터를 업데이트한다.
ReFT와의 주요 차이점: Online-ST는 오답이 포함된 Sample을 활용하지 않으며, 초기 모델에서 크게 벗어나는 것(Diverging)을 막는 전용 메커니즘이 없다.
-
Baseline 설정
- SFT (Supervised Fine-Tuning)
- 에폭: 40 에폭 훈련 (수렴을 보장하기 위한 충분히 큰 수).
- 선택: 가장 좋은 성능을 보인 체크포인트를 최종 모델로 선택.
- Offline-ST (Offline Self-Training) 이 모델은 $\text{ReFT}$의 $\text{Warm-up}$ 단계에서 얻은 체크포인트를 사용해 $\text{CoT}$를 샘플링한다.
- 샘플링 설정:
- Temperature: 1.0
- 최대 길이: 1024
- 샘플 수: 질문당 100개의 CoT를 샘플링한 후, 정답이 있는 CoT만 유지한다.
- 하위 샘플링: 정답 CoT를 질문당 10개의 무작위 고유 CoT로 재샘플링하여 난이도 균형을 맞춘다.
- 미세 조정 에폭: 20 에폭 (수렴을 보장하기 위한 충분한 횟수).
- Online-ST (Online Self-Training)
- 설정: ReFT와 동일한 Warm-up 과정을 거치며, 하이퍼파라미터 설정은 ReFT와 거의 동일하게 맞추어 공정하게 비교한다.
Results
ReFT의 핵심 실험 결과
SFT를 비롯한 다양한 기준선 모델들을 일관되게 능가한다는 것이다. 이는 ReFT가 학습 데이터셋에 포함된 단 하나의 정답 추론 경로를 넘어, 문제 해결에 이르는 여러 가지 유효한 경로를 학습함으로써 우수한 일반화 능력을 확보했음을 의미한다. 자세하게는 ReFT는 SFT 대비 최대 약 12%p에 달하는 정확도 향상을 달성했다. 특히, 훈련에 사용되지 않은 미지의 문제(out-of-distribution)에 대한 일반화 능력에서 강점을 보였다.
세부 실험 결과 및 분석
-
CoT 유형별 효과 (N-CoT vs. P-CoT)
ReFT는 자연어 형태의 CoT와 프로그램 기반 CoT 모두에서 효과적이다. -
추론 시 다른 강화학습 전략과의 시너지 효과
ReFT로 미세 조정된 모델은 추론 단계에서 추가적인 전략을 결합했을 때 성능이 더욱 향상되었다.-
다수결 투표(Majority Voting): 모델이 생성한 다수의 추론 경로(예: 100개) 중 최종적으로 가장 많은 정답을 제시한 결과를 채택하는 방식으로, ReFT 단독 성능 대비 추가적인 향상을 가져왔다.
-
보상 모델 재랭킹(Reward Model Re-ranking): 별도로 학습된 보상 모델을 사용하여 생성된 여러 응답 중 가장 높은 점수를 받은 응답을 선택하는 방식으로, 다수결 투표와 유사하게 최종 정확도를 높이는 데 기여했다.
-
-
보상 해킹(Reward Hacking) 문제에 대한 분석
MathQA와 같은 일부 객관식 데이터셋에서는 모델이 정답 추론 과정 없이 최종 답안 형식(A, B, C, D)만 학습하여 높은 보상을 얻는 “보상 해킹” 문제가 발생할 수 있다.논문은 이러한 현상을 진단하고, 최종 답을 객관식이 아닌 “숫자”로 추출하는 MathQA의 숫자 변형 버전을 사용하여 실험했다.
ReFT는 이 숫자 변형 MathQA에서도 SFT를 능가했습니다. 이는 ReFT의 성능 향상이 단순히 객관식 형식을 외우는 것이 아니라, 실제적인 수학적 추론 능력을 강화했기 때문임을 뒷받침한다.
강화 학습의 역할
ReFT가 SFT를 능가하는 근본적인 이유는 강화 학습(PPO) 단계에서 풍부한 지도 신호를 얻기 때문이다. SFT가 단일 정답 CoT에만 의존하는 반면, ReFT는 정책 모델을 통해 다양한 오답 및 정답 추론 경로를 능동적으로 샘플링하고, 이를 정답: 1, 숫자 오답: 0.1, 추출 불가: 0이라는 명확한 보상 신호로 학습한다. 이 과정이 모델의 문제 해결 능력을 향상시킨다.