ReAct: Synergizing Reasoning and Acting in Language Models 리뷰
추론 과정과 행동을 결합하여 LLM이 다양한 문제 상황에 대해서 의사결정과 추론을 하도록 하는 방법론에 대한 연구이다.
연구 배경
인간은 과제를 해결하고자 행동과 언어적 추론을 결합하여 스스로 통제하고, 계획을 세우고, 기억을 유지한다. 이런 결합이 새로운 task를 빠르게 배우게 해주고, 경험해보지 못했거나 확실하지 않은 상황에도 강력한 추론과 의사결정을 가능하게 해준다.
LLM이 인간처럼 추론하도록 만들기 위해서 CoT로 prompting하여 답을 내도록 하면 단계적인 추론을 통해 학습해보지 않은 과제도 수행할 수 있다. 하지만 이 방법의 단점은 In-context learning을 통해서 답을 추출, 즉 모델의 내부 지식에만 근거하여 답을 도출하기 때문에 Hallucination 문제를 겪는다. 또, CoT는 미리 정해진 단계를 따르거나 일직선상의 추론을 수행하기 때문에, 환경의 동적인 피드백(Observation)을 받아 계획을 수정하거나 새로운 단계를 도입하는 능력이 부족하다.
ReAct
ReAct는 이런 문제를 해결하기 위해 필요한 언어적 추론 과정과 행동이 교대로 나온 example로 few shot prompting을 하여 동적인 추론을 가능하게 만들었다. 또, Model이 외부 지식을 갖고 올 수 있도록 하여 CoT prompting의 단점을 해결하였다. 이로 인해 수준 높은 추론 과제나 의사 결정 과제에서 뛰어난 성능을 보였다.
환경과 상호작용하여 문제를 해결하는 일반적인 agent는 timestep t에서 환경에 대한 관측 $O_t \in O$를 통해 policy $\pi(\cdot \mid c_t)$로부터 취할 행동 $a_t$를 고르게 된다. 이때 $c_t = (O_1, a_1, \cdot\cdot, a_{t-1}, O_t)$인 context를 의미한다. 이때 $c_t$로부터 $a_t$를 고르는 과정이 복잡하다면 policy를 학습하는 것은 어렵다.
ReAct는 이 문제를 단순하게 $c_t$로부터 $a_t$를 고르는 과정을 쉽게 만들었다고 보면 된다. Agent 행동 공간 A에 언어공간 L을 결합하여 augment된 행동 공간 $\hat A = A + L$을 만든다. 언어공간 L에서 이루어지는 행동 $\hat a_t \in L$은 언어로 된 thought로 기존 action과 다르게 외부환경에 영향을 주진 않지만 현재 context $c_t$에 대해 추론을 하여 중요한 정보를 생성한다. 그리고 그 정보를 현재 context $c_t$에 더함으로써 새로운 context $c_{t+1} = (c_t, a_t)$를 만든다. 이렇게 재구성된 context는 $a_t$를 고르는 과정을 쉽게 해줘서 이어지는 추론 / 의사결정에 도움을 준다. Thought을 설계할 때 다양한 종류로 구성할 수 있다. 예를 들어 다음과 같은 방법으로 Thought을 구성하여 context를 재구성할 수 있다.
- 수행 과제를 분해하여 계획 세우기
- 과제와 관련된 상식 주입
- 관측 정보에서 중요한 정보 추출
- 진행 상황 기록하고 계획 실행하기
- 예외 상황 처리하고 계획 세우기
이때 L은 무한한 공간이기 때문에 augment된 $\hat A$에서 context에 알맞은 action과 thought를 고르는 것은 언어에 대한 방대한 지식이 필요하다. 따라서 논문에서 인간이 직접 만든 ReAct example (action, thought, observation이 반복된 trajectory)로 PaLM-540B에 few shot in-context prompting을 하여 특정 문제를 해결할 때 필요한 action과 thought를 생성하도록 하였다. Actions와 thoughts를 생성할 때, 수행하는 과제의 성격을 반영하였다. 추론이 주된 과제를 위해서는 작업 해결 과정을 여러 개의 사고-행동-관찰 단계로 구성하도록 생성하게 하였다. 의사(Action) 결정이 주된 과제를 위해서는 thought를 가장 관련성 높은 위치에만 sparse하게 in-context example을 구성하여 LLM이 thought와 action이 필요한 시점을 유연하게 결정할 수 있게 하였다.
ReAct의 장점
- ReAct는 prompt 구성이 간단하다. 취한 action 중간중간에 필요한 thought를 작성하면 된다.
- 유연한 추론 공간 L과 thought-action 형식 덕분에, ReAct는 각기 다른 행동 공간과 추론 요구 사항을 가진 다양한 작업에 적용될 수 있습니다.
- 소수의 in-context examples로 few shot prompting을 해도 새로운 과제에 대해 강한 일반화 능력을 보여준다.
- ReAct의 의사결정 및 추론 과정은 해석이 쉬워서 인간이 직접 그 내용과 정확성을 검토하고 실시간으로 통제/수정이 가능하다.
Experiments
지식을 많이 요구하는 추론 과제 실험 (여러 단계로 구성된 (Multi-hop) QA, Fact verification)
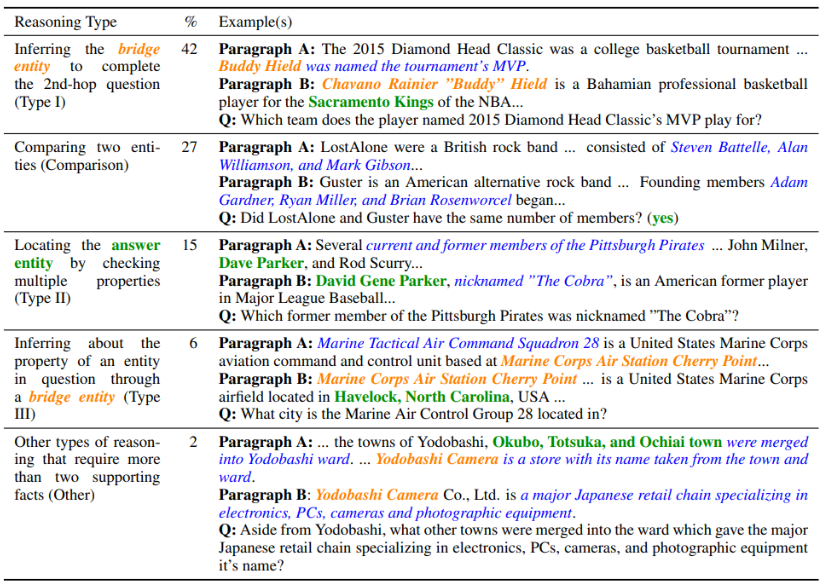
- Hotpot-QA: 다양한 정보를 종합적으로 이해해야 해결할 수 있기 때문에 복잡한 문제 상황에 대한 추론 능력을 시험할 수 있음
- FEVER: 주장이 주어졌을 때 그 주장을 검증할 수 있는 위키피디아 passage가 존재하는지에 따라 SUPPORTS(뒷받침함), REFUTES(반박함), 또는 NOT ENOUGH INFO(정보 불충분)을 판단하는 Benchmark이다.
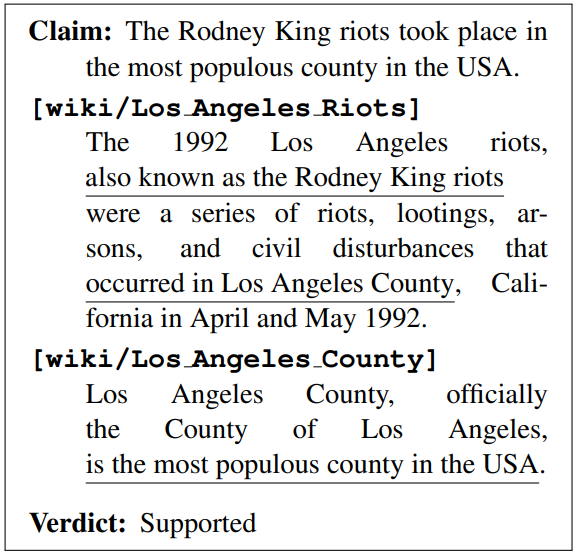
이때, 모델은 질문/주장만 입력으로 받으며, 뒷받침하는 단락에는 접근할 수 없게 하였다. 추론을 뒷받침하기 위해 내부 지식을 활용하거나 외부 환경과 상호작용하여 지식을 검색하도록 강제하였다.
외부 환경의 지식을 가져오기 위해서 세 가지 유형의 action을 가진 간단한 위키피디아 웹 API를 설계했다:
-
search[entity]: 해당 entity가 위키피디아 페이지에 존재하면 그 페이지의 첫 5개 문장을 반환하고, 그렇지 않으면 위키피디아 검색 엔진에서 가장 유사한 상위 5개 개체를 제안한다.
-
lookup[string]: 해당 페이지에서 문자열을 포함하는 다음 문장을 반환하며, 브라우저에서 Ctrl+F 기능을 시뮬레이션한다.
-
finish[answer]: 답변과 함께 현재 작업을 종료한다.
이 행동 공간으로 대부분 정확한 구절 이름에 기반하여 구절의 작은 부분만을 검색할 수 있다. 이런 설계의 목적은 사람들이 위키피디아와 상호작용하는 방식을 재현하고, 모델이 언어로 된 추론을 통해 검색하도록 강제하는 것이다.
Prompting Method 비교
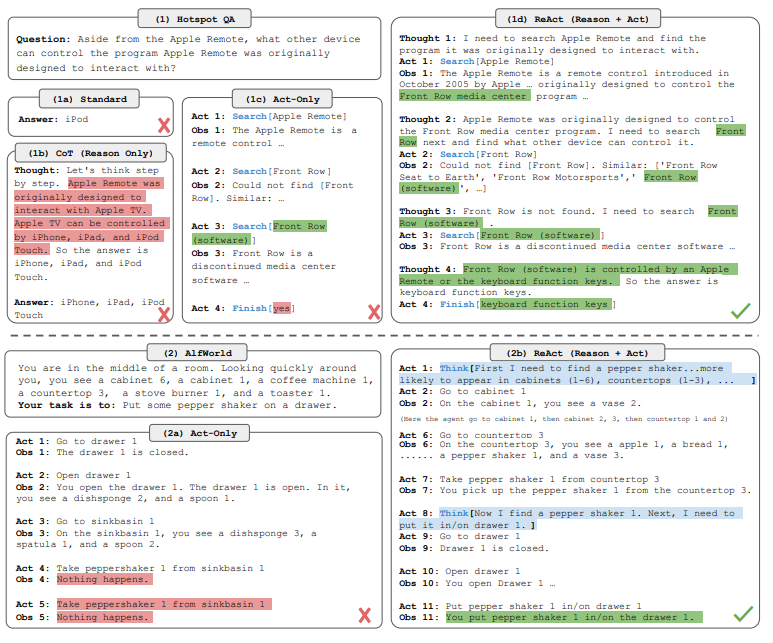
ReAct로 prompting 하였을 때와 다른 방법으로 prompting 하였을 때의 benchmark 성능을 비교하여 ReAct 기반 prompting의 효과를 확인하고자 하였다.
ReAct Prompting
각 benchmark의 Training set에서 6개의 example, 직접 생성한 3개의 ReAct 형식의 example로 few shot example을 구성하였다. 각 example은 여러개의 Thought - Action - Observation 단계들로 구성되어있다. 이 example에서 사용한 Thought 종류는 다음과 같다.
-
질문을 분해하는 사고 (“x를 검색하고, y를 찾은 다음, z를 찾아야 해”),
-
위키피디아 관찰 결과로부터 정보를 추출하는 사고 (“x는 1844년에 시작되었어”, “이 단락에는 x에 대한 정보가 없어”),
-
상식적 추론 (“x는 y가 아니니까, z는 대신 …이어야 해”) 또는 산술적 추론 (“1844 < 1989”)을 수행하는 사고,
-
검색 재구성을 유도하는 사고 (“대신 x를 검색하거나 찾아볼(look up) 수 있을 것 같아”),
-
최종 답변을 종합하는 사고 (“…따라서 정답은 x야”).
Baselines
- Standard Prompting: ReAct 형식 example에서 thought, action, observation을 모두 뺀 것
- CoT prompting: ReAct 형식 example에서 action, observation을 뺀 것. 추론만 하는 baseline.
- CoT-SC prompting: 추론 시 decoding temperature) 0.7로 21개의 CoT trajectory을 샘플링하고, 다수결 답변을 채택하는 방법. 일반적인 CoT보다 더 좋은 성능을 보이는 baseline.
- Act only prompting: ReAct 형식 example에서 thought을 모두 뺀 것. Thought의 영향력을 보여주는 baseline.
내부 지식와 외부 지식을 모두 이용하는 방법론 추가
ReAct와 CoT 기반 해결 과정을 관찰한 결과 ReAct는 정확한 사실에 기반하여 답을 도출하는 경향이 있고 CoT는 추론 구조를 잘 지키지만 Hallucinated 사실과 내부 지식에 기반하여 답을 도출하는 경향이 있다. 따라서, 내부 지식과 외부 지식을 모두 사용하는 Prompting method을 만들고자 ReAct + CoT-SC 방법을 만들었다. ReAct → CoT-SC 방법은 ReAct가 일정 timestep 안에 답을 도출하지 못했다면 CoT-SC 방법으로 다시 시도하는 방법이고 CoT-SC → ReAct 방법은 CoT-SC가 도출한 답이 다수결 답변이 아니라면 (= 모델 내부 지식으로 해결하지 못하는 문제라면) ReAct 방법으로 시도하는 방법이다.
Fine-tuning 실험
논문에서는 Standard, CoT, Act only, ReAct 형식의 사고 과정으로 finetuning 시켰을 때의 성능도 비교하고자 하였다. PaLM 540B이 생성한 Thought - Action - Observation trajectory 중 답이 맞은 것만 3000개를 가져와 더 작은 언어 모델 PaLM 8/64B에 finetuning 시켰다. 다른 형식의 경우에도 동일하게 답이 맞은 3000개의 사고과정을 가져와 finetuning 시켰다. Fine-tuning의 method는 질문 / 주장이 입력으로 주어졌을 때, 각 형식의 사고 과정을 self-supervised learning을 하는 방법으로 진행되었다.
실험 결과
Prompting 실험 결과
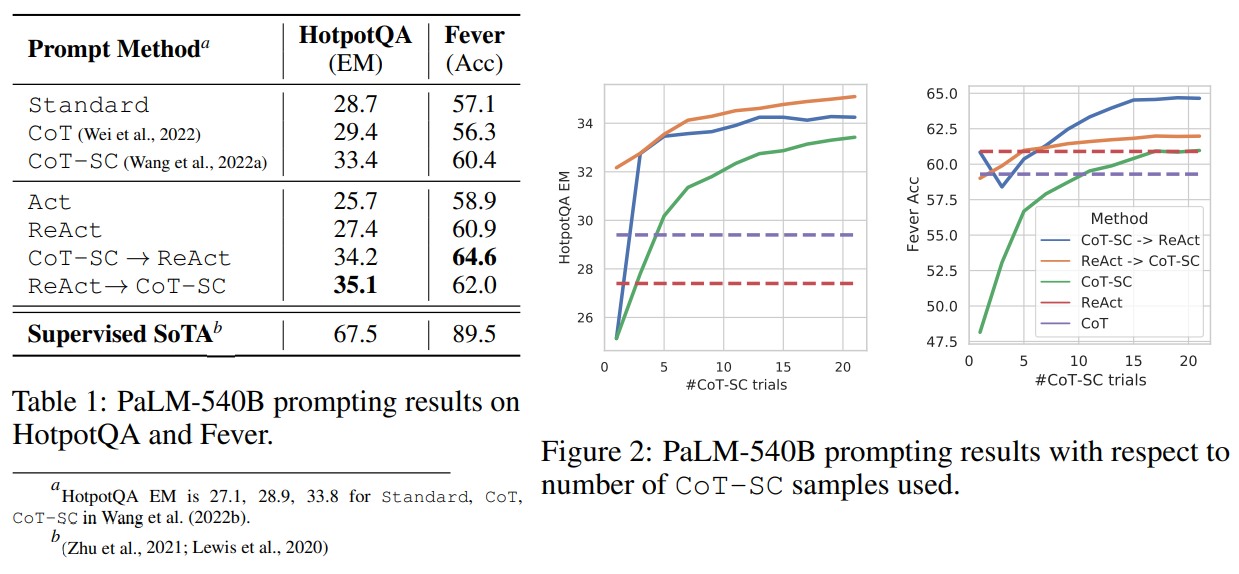
- ReAct는 Act only보다 일관되게 더 좋은 성능을 보임. 이는 행동과 추론을 결합하는 것이 더 효과적임을 보여준다. 추론 과정을 통해 더 많은 정보에 입각한 action을 하게 하여 답을 더 도출을 잘 하게 된다.
- ReAct는 CoT보다 FEVER에서 더 좋은 성능을 보여준다. 이는 wikipedia api를 통해 최신 정보를 활용할 수 있기 때문에 가능한 것이다.
- 하지만 HotpotQA에서는 ReAct는 일관된 우수성을 보이지 못한다. 이를 분석하기 위해 논문에서 ReAct와 CoT의 해결 과정들 중 답이 틀린 것 50개씩, 답이 맞은 것 50개씩 총 200개의trajectory를 분석했다.
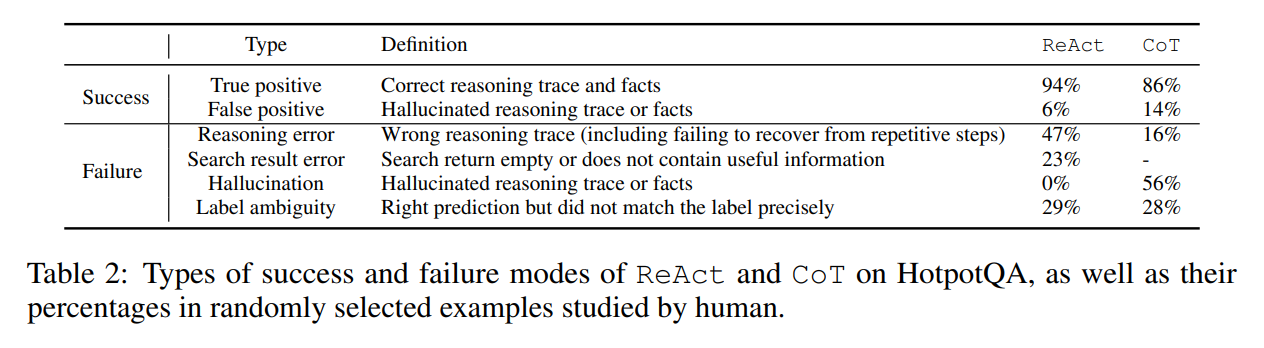
- CoT가 답을 맞은 경우 중 14%는 Trajectory에 hallucinated 정보들이 들어가 있다. 이를 통해 CoT 방법론은 Hallucination에 큰 영향을 받는다는 것을 볼 수 있고 반대로 ReAct는 최신 정보를 가져올 수 있기 때문에 Hallucination에 덜 영향을 받는 것을 볼 수 있다.
- ReAct의 유연하지 못한 구조로 인해 답을 도출하지 못하게 되는 경우가 너무 빈번했다.
-
ReAct가 답을 틀린 경우 중 23%는 잘못된 정보를 가져와서 발생하였다. 이를 통해 ReAct에서 정보 Retreival 성능이 매우 중요함을 알 수 있다.
- ReAct와 CoT-SC를 섞은 방법론은 다른 방법론들보다 더 우수한 성능을 보였다. 이 결과는 내부 지식과 외부 지식을 둘 다 적절하게 활용하는 것의 우수함을 보여준다.
Finetuning 실험 결과
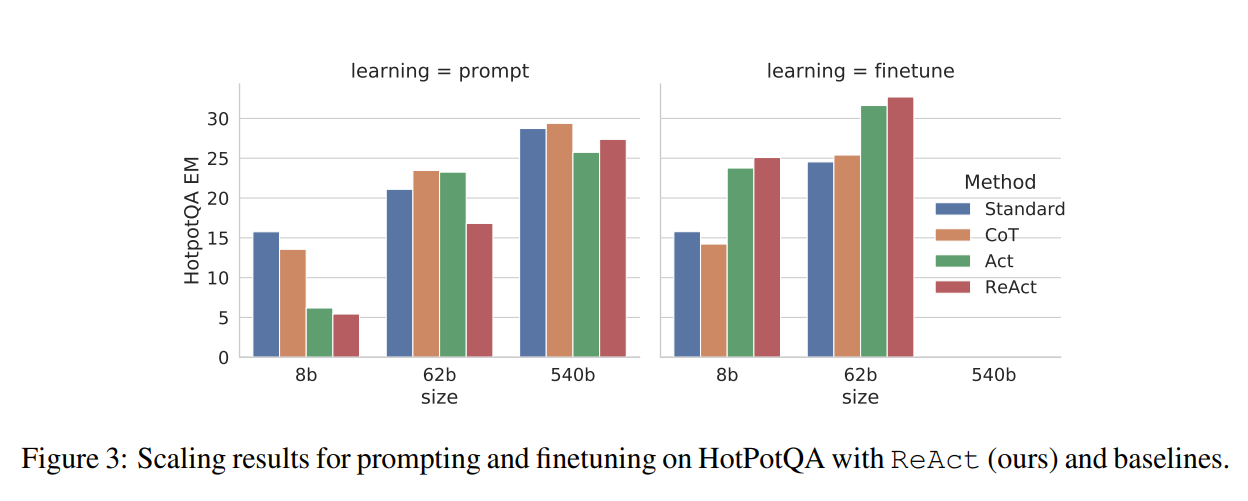
- PaLM-8/62B 모델의 경우, prompting을 했을 때 가장 저조한 성능을 보였다. 하지만 3,000개의 예시로 fine-tuning했을 때, ReAct는 가장 우수한 성능을 보였다. Fine-tuning된 PaLM-8B ReAct는 모든 PaLM-62B prompting 방법을 능가하며, fine-tuning된 PaLM-62B ReAct는 모든 540B prompting 방법을 능가한다.
의사결정 과제 실험
의사결정 과제로 사용하는 benchmark는 ALFWorld와 WebShop이다. 두 benchmark 모두 행동을 효율적으로 선택하기 위해 일정 수준의 추론을 요구한다.
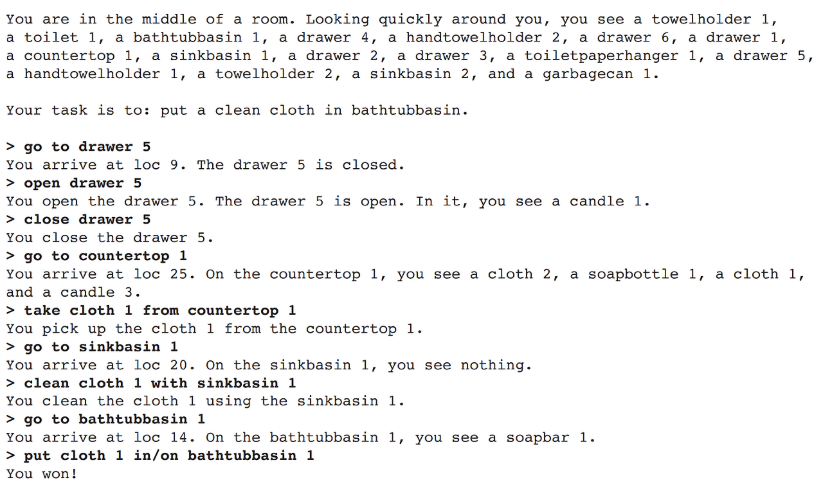
- ALFWorld: 시뮬레이션된 가정 환경을 탐색하고 상호작용하여 해결해야 하는 6가지의 복잡한 문제 상황이 주어진다. 이를 해결하기 위해 50번의 timestep이 필요하기도 하므로 Agent에게 하위 목표를 계획하고 기록하는 능력, 그리고 체계적으로 탐색하는 능력을 요구한다. 특히 ALFWorld에 내장된 한 가지 도전 과제는 일반적인 가정용 물품의 있을 법한 위치를 결정해야 한다는 점에서 LLM이 사전 학습된 상식 지식을 활용하기에 적합하다.
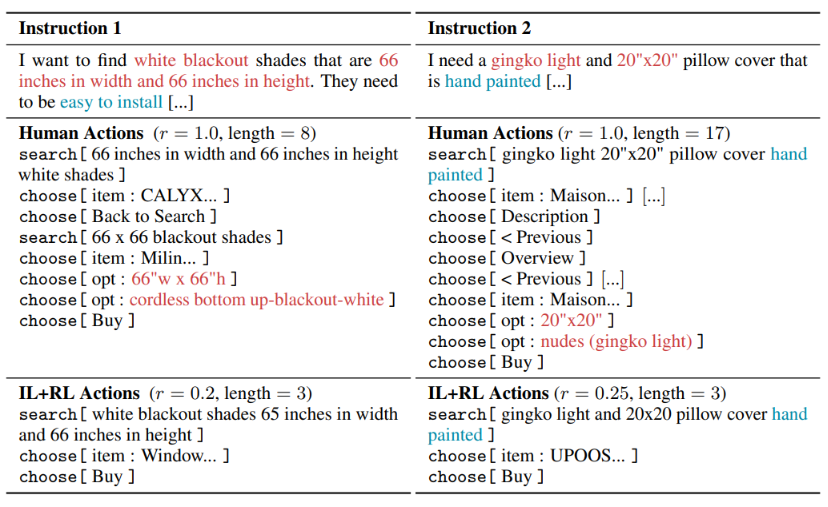
- WebShop: 실제 언어 환경에서 실용적인 과제를 수행할 수 있는지를 보는 benchmark이다. 사용자의 요구에 따라 agent가 상품을 구매할 수 있는지를 본다. 이 작업은 500개의 테스트 지침에 대해 평균 점수 (선택된 제품이 다루는 원하는 속성의 비율을 모든 에피소드에 걸쳐 평균한 값)와 성공률 (선택된 제품이 모든 요구 사항을 충족하는 에피소드의 비율)로 평가된다. Act 프롬프트는 검색, 제품 선택, 옵션 선택, 구매와 같은 행동으로 구성하고, ReAct 프롬프트는 여기에 무엇을 탐색할지, 언제 구매할지, 그리고 어떤 제품 옵션이 요구사항과 관련이 있는지를 결정하는 추론을 추가한다.
실험 결과
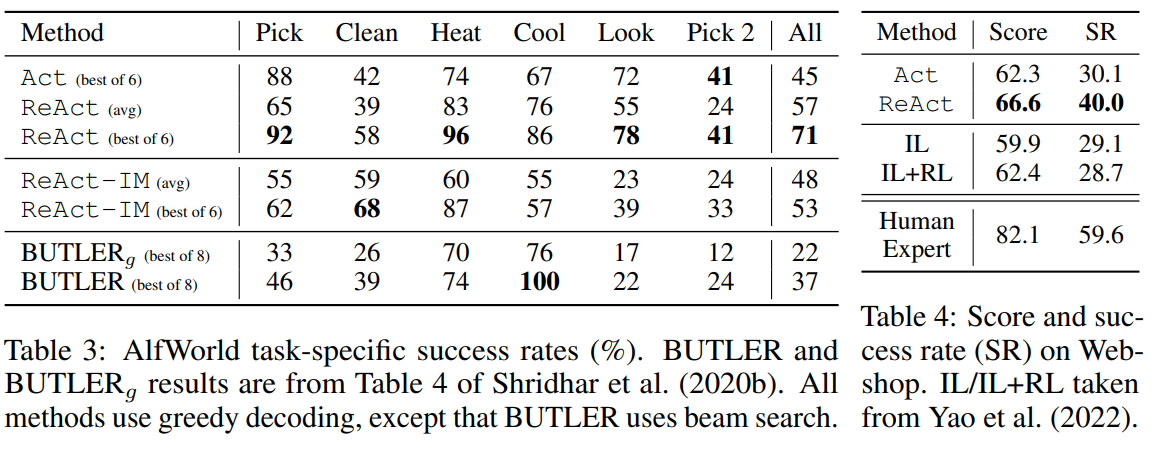
ReAct는 ALFWorld와 Webshop 모두에서 Act보다 우수한 성능을 보였다.
ALFWorld
-
ALFWorld에서 가장 우수한 ReAct는 평균 성공률 71%를 달성하였고, 가장 낮은 성능의 ReAct 성공률 (48%)은 두 방법의 가장 우수한 결과보다 더 나은 결과를 보였다.
-
ReAct가 Act에 대해 갖는 우위는 일관적이었고, 상대적인 성능 향상은 평균적으로 62%이다.
=> Thoughts가 전혀 없는 Act only 기반 prompting 방법은 목표를 더 작은 하위 목표로 분해하지 못하거나 환경의 현재 state를 잘 인지하지 못한다는 것을 엿볼 수 있다.
Webshop
-
One shot Act prompting으로도 이미 IL(모방 학습) 및 IL+RL(모방 학습 + 강화 학습) 방법들과 대등한 성능을 보입니다. 여기에 thought을 더한 ReAct는 10%의 성능 향상을 보였다.
-
ReAct prompting 기반으로 생성된 답안 예시를 보면 “거실용 공간 절약형 벤치’의 경우, 이 제품에는 ‘39x18x18인치’와 ‘파란색’ 옵션이 있으며 구매하기에 좋은 것 같다” 와 같이 thought을 통해 노이즈가 많은 관찰과 행동 사이의 간극을 연결함으로써 요구사항과 관련된 제품 및 옵션을 식별할 가능성이 Act only prompting보다 더 높아진 것을 엿볼 수 있다.